Databricks oder Matching Engine? Build-versus-Buy-Leitfaden für Banken 2026

Kurzfassung: Erstellen Sie Entity Resolution auf Databricks, wenn individuelles Matching strategisch wichtig ist und Ihre Bank den Aufwand für Entwicklung, Governance und Betrieb dauerhaft tragen kann. Kaufen Sie erst, nachdem Sie geklärt haben, welche Komponenten für Matching, Clustering, Prüfung und Monitoring das Produkt pflegt, während die Verantwortlichkeit auf Bankseite klar benannt bleibt. Mit einer hybriden Architektur lassen sich diese Grenzen leichter festlegen.
Vergleichen Sie Build und Buy mit Ihren eigenen Daten. Demo buchen · Tilores Studio kostenlos testen.
Auf dieser Seite
- Welche Entscheidung treffen Banken tatsächlich?
- Was muss eine Bank über die Matching-Logik hinaus entwickeln?
- Wann ist der Aufbau auf Databricks sinnvoll?
- Wann ist der Kauf einer Matching Engine sinnvoll?
- Ist eine hybride Architektur die bessere Lösung?
- Wie sollte eine Bank die Optionen bewerten?
- Wie lautet das praktische Fazit?
- Häufig gestellte Fragen
Welche Entscheidung treffen Banken tatsächlich?
Bei der Entscheidung geht es nicht einfach um Databricks oder eine andere Software. Databricks stellt eine leistungsfähige Daten- und Analyseplattform bereit, auf der eine Bank ein System für Entity Resolution entwickeln kann. Eine Matching Engine stellt die spezialisierte Resolution-Funktion selbst bereit. Die eigentliche Entscheidung betrifft daher die betriebliche Verantwortung: Welche Teile der Identity Resolution sollte die Bank dauerhaft konzipieren, pflegen und absichern?
Ein Proof of Concept kann eine individuelle Lösung trügerisch kompakt erscheinen lassen. Datensätze laden, einige Felder standardisieren, Ähnlichkeiten berechnen und eine gemeinsame Kennung zuweisen. Im Produktivbetrieb ändert sich die Fragestellung. Die Bank muss unvollständige Daten, widersprüchliche Attribute, veränderte Beziehungen, falsche Zusammenführungen, übersehene Übereinstimmungen, historische Entscheidungen und Ausnahmen handhaben, die eine menschliche Prüfung erfordern.
Diese Unterscheidung ist wichtig, weil eine Datenpipeline noch keine betriebsfähige Entity Resolution darstellt. Eine Bank, die die Optionen bewertet, sollte den vollständigen Service vergleichen, den sie betreiben muss, nicht nur den Code, der einen ersten Match-Score erzeugt.
Nutzen Sie diesen Vergleich als Due-Diligence-Karte und nicht als Aussage, dass jedes Produkt denselben Umfang abdeckt. Vor der Wahl einer Architektur sollte die Bank für jede Zeile die verantwortliche Stelle und die Lebenszykluskosten bestimmen.
| Entscheidungsbereich | Auf Databricks entwickeln | Matching Engine kaufen | Hybridmodell |
|---|---|---|---|
| Matching-Logik | Von der Bank konzipiert und gepflegt | Unterstützten Matching-Umfang des Produkts und Verantwortlichkeiten des Anbieters prüfen | Festlegen, welche Resolution-Verantwortlichkeiten bei der Engine und welche bei der Bank verbleiben |
| Golden Record | Bank konzipiert Mastering und Survivorship | Prüfen, ob das Produkt Mastering-Workflows unterstützt, statt sie zu verantworten | Bank weist die Verantwortung für den gemasterten Datensatz zu und nutzt aufgelöste Entitäten an der vereinbarten Grenze |
| Datenplattform | Databricks hostet den Resolution-Workflow | Separate Engine wird in Banksysteme integriert | Databricks bleibt die Datenplattform und die Engine übernimmt die Resolution |
| Betrieb | Bank verantwortet Monitoring, Incidents und Upgrades | Monitoring, Incidents und Upgrades ausdrücklich zwischen Bank und Anbieter aufteilen | Verantwortung wird anhand klarer Servicegrenzen aufgeteilt |
| Anpassbarkeit | Maximale Freiheit mit entsprechendem Pflegeaufwand | Konfiguration innerhalb des unterstützten Modells der Engine | Individuelle Orchestrierung um einen gepflegten Resolution-Kern |
Was muss eine Bank über die Matching-Logik hinaus entwickeln?
Die folgende Karte mit acht Ebenen ist ein praktischer Bewertungsrahmen für Banken und keine universelle Branchentaxonomie. Die begutachtete Fachliteratur zur Entity Resolution unterscheidet Alignment, Blocking, Linkage und Kanonisierung und erläutert, warum paarweises Linkage und Clustering auf Entitätsebene unterschiedliche Probleme sind. Für eine Bank erweitert die Karte diese technischen Stufen um Verantwortlichkeiten für Governance, Prüfung und Service, denen konkrete Zuständige zugewiesen werden müssen.
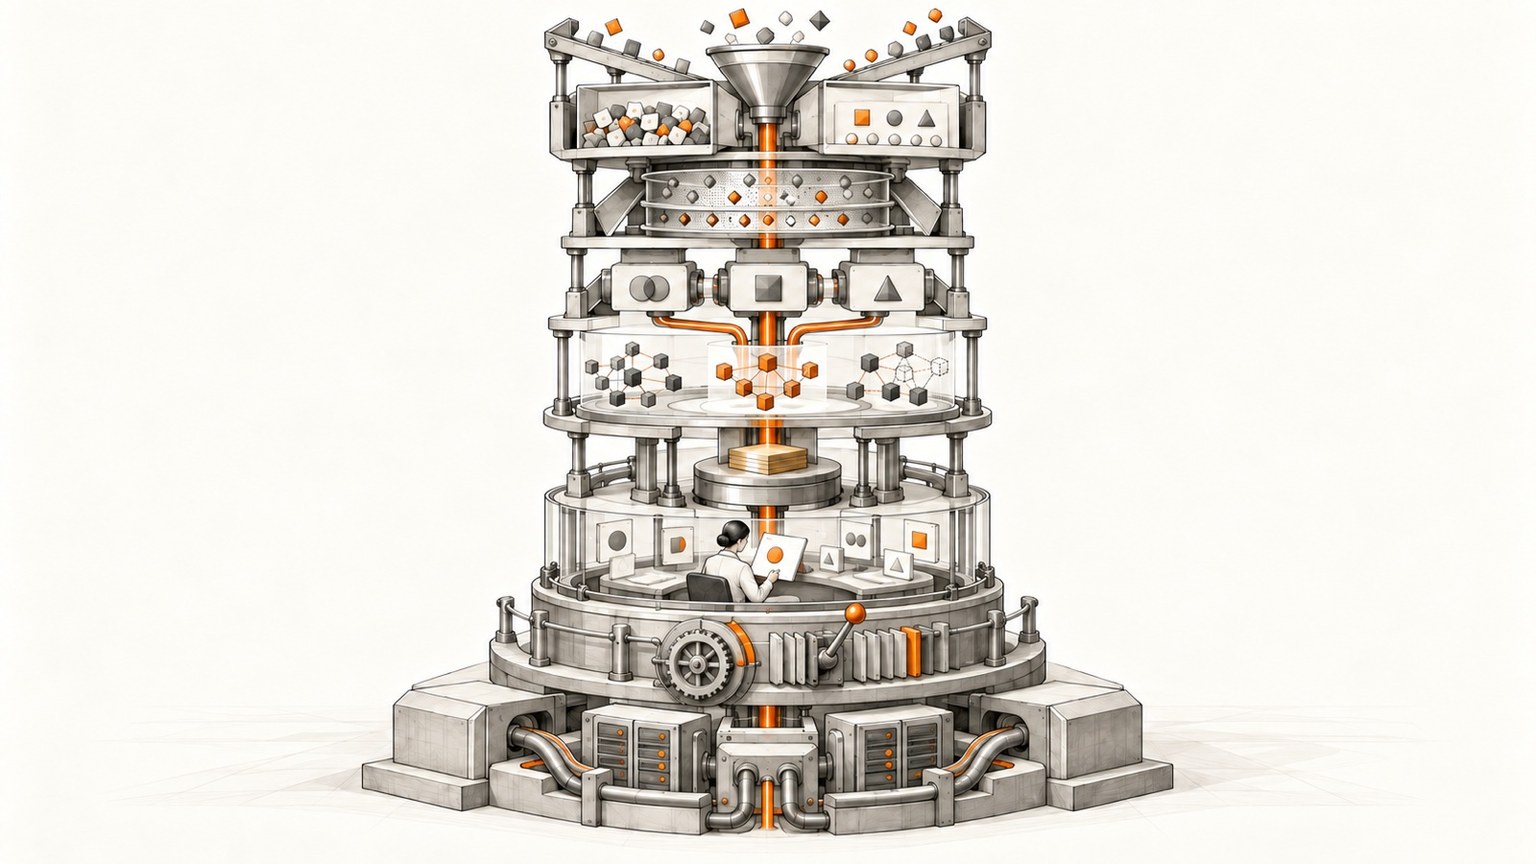
Entity Resolution im Produktivbetrieb reicht über Match Scoring hinaus und umfasst Datenaufnahme, Kandidatengenerierung, Matching, Clustering, Mastering, Prüfung, Monitoring und Servicebetrieb.
- Datenaufnahme und Normalisierung. Namen, Adressen, Datumsangaben, Kennungen und Kontaktdaten liegen in unterschiedlichen Formaten und unterschiedlicher Qualität vor. Die Bank benötigt wiederholbare Transformationen, eine Rückverfolgbarkeit der Quellen und Regeln zur Aufbewahrung der Originalwerte.
- Kandidatengenerierung. Jeden Datensatz mit jedem anderen Datensatz zu vergleichen, ist nur selten ein sinnvolles Produktionsdesign. Die Fachliteratur zur Entity Resolution beschreibt Blocking als die Stufe, die Vergleiche begrenzt. Das Design muss daher auf plausible Kandidaten getestet werden, die möglicherweise ausgeschlossen werden.
- Match-Entscheidungen. Deterministisches Matching, Fuzzy Matching und probabilistisches Matching lösen jeweils unterschiedliche Teile des Problems. Fuzzy-Ähnlichkeit ist nicht dasselbe wie probabilistisches Matching. Ein Produktionsdesign benötigt klare Regeln dafür, wie jede Methode zu einer Entscheidung beiträgt.
- Entity Clustering. Paarweise Ähnlichkeit erzeugt nicht automatisch stabile Entitäten. Eine begutachtete Übersichtsarbeit erläutert, dass paarweise Methoden Transitivitätsbedingungen übersehen können. Der Service muss daher Zusammenführungen, Aufteilungen und widersprüchliche Evidenz innerhalb eines Clusters ausdrücklich behandeln.
- Golden-Record-Logik. Das Matching von Datensätzen und die Entscheidung darüber, welche Werte maßgeblich werden, sind getrennte Aufgaben. Survivorship, Provenienz und fachliche Verantwortung benötigen ein eigenes Design.
- Erklärbarkeit und Prüfung. Ermittler, Data-Stewards, Prüfer und Modellverantwortliche müssen verstehen, warum Datensätze verknüpft wurden. Prüfergebnisse müssen in kontrollierte Konfigurationsänderungen zurückfließen.
- Monitoring und Change Control. Quellsysteme, Kundenverhalten und Datenqualität verändern sich. Die Bank muss Drift erkennen, falsch positive und falsch negative Ergebnisse prüfen, Regeländerungen testen und die Entscheidungshistorie bewahren.
- Integration und Servicebetrieb. Nachgelagerte Systeme benötigen stabile Entitätskennungen, Schnittstellen, Zugriffskontrollen, Service-Monitoring, Wiederherstellungsverfahren und verantwortlichen Support. Das Basel Framework verlangt klare Verantwortlichkeiten und Kontrollen über den gesamten Daten- und Technologielebenszyklus für Risikodaten von Banken.
Databricks bietet nützliche Grundlagen für mehrere dieser Ebenen. Unity Catalog Lineage kann dabei helfen, Datenbewegungen nachzuvollziehen, während sich mit Lakeflow Pipeline Expectations Einschränkungen der Datenqualität ausdrücken und überwachen lassen. MLflow Tracking kann Parameter, Metriken und Artefakte für Modellexperimente erfassen. Diese Funktionen unterstützen die Governance, doch die Bank muss das darauf aufbauende Verhalten der Entity Resolution weiterhin selbst konzipieren und betreiben.
Neue Beiträge zu Entity Resolution, Identitätsdaten und KI. Kein Spam, Abmeldung jederzeit möglich.
Wann ist der Aufbau von Entity Resolution auf Databricks sinnvoll?
Eine Eigenentwicklung ist überzeugend, wenn Entity Resolution eine strategische Engineering-Kompetenz und nicht nur eine unterstützende Funktion ist. Die Bank sollte über ein dauerhaftes Team und nicht nur über vorübergehende Projektkapazitäten verfügen. Das Basel Framework weist Fach- und IT-Funktionen Verantwortung, Kontrollen und Lebenszykluspflichten für Risikodaten der Bank zu.
Eine Databricks-Eigenentwicklung ist besonders überzeugend, wenn die Bank ungewöhnliche Resolution-Logik benötigt, über ausgereiftes Data Engineering und einen reifen Machine-Learning-Betrieb verfügt und die Verantwortung für jede Entscheidung im Produktivbetrieb übernehmen kann. Sie kann auch zu einer Organisation passen, deren Architektur erfordert, dass die Matching-Logik tief in bestehende Lakehouse-Workflows eingebettet bleibt.
Vor Beginn der Implementierung sollte die Eigenentwicklung fünf Fragen beantworten:
- Wer verantwortet die Match-Qualität, nachdem das Projektteam seine Arbeit beendet hat?
- Wer untersucht falsche Zusammenführungen und übersehene Übereinstimmungen?
- Wie werden Schwellenwerte, Merkmale und Regeln genehmigt, getestet und zurückgesetzt?
- Über welche Schnittstelle können Data-Stewards mehrdeutige Entitäten prüfen?
- Wie wird die Bank historische Entscheidungen erklären, nachdem sich die zugrunde liegenden Daten oder die Logik geändert haben?
Wenn diese Antworten von einzelnen Engineers oder undokumentierten Notebooks abhängen, bewertet die Bank keine Eigenentwicklung für den Produktivbetrieb. Sie bewertet einen Prototyp, dessen laufender Betriebsaufwand noch nicht festgelegt wurde.
Wann ist der Kauf einer Matching Engine sinnvoll?
Ein Kauf kann attraktiv sein, wenn die Bank das Geschäftsergebnis und die Governance verantworten möchte, ohne jeden spezialisierten Mechanismus selbst zu entwickeln. Der Wert sollte nicht allein aus vorgefertigten Ähnlichkeitsfunktionen abgeleitet werden. Die Bewertung muss ermitteln, welche Teile von Normalisierung, Kandidatengenerierung, Matching, Clustering, Erklärbarkeit, Prüfung und betrieblicher Kontrolle das Produkt tatsächlich pflegt.
Eine Matching Engine sollte dennoch mit den eigenen Daten und Fehlerkosten der Bank getestet werden. Produktfunktionen beseitigen nicht den Bedarf an klaren Verantwortlichkeiten für Schwellenwerte, Datenschutzprüfung, Stewardship oder Integrationsdesign. Sie verändern, welches Team für die spezialisierten Mechanismen zuständig ist. Dies sollte die Bank ausdrücklich dokumentieren.
Unsere Matching-Regeln kombinieren deterministische Matcher wie einfache Textgleichheit mit Fuzzy-Text-Matching und probabilistischem Matching als getrennte Methoden. Wir verwenden Transformationen zur Normalisierung von Arbeitswerten. Übermittelte Datensätze werden mit bereits in Tilores gespeicherten Datensätzen verglichen, während Fuzzy-Lookup-Matching Originalwerte mithilfe des konfigurierten Ähnlichkeitsvergleichers vergleicht. Anwendungen nutzen zur Laufzeit unsere GraphQL API. Der öffentliche MCP-Server unterstützt die Konfigurationsarbeit, einschließlich Regel-Linting und Vorlagen für GraphQL-Abfragen, und dient nicht als Schnittstelle für die Resolution zur Laufzeit. Die Deployment-Optionen können Sie gesondert bewerten.
Der Kauf ist besonders sinnvoll, wenn die Entwicklung eines internen Matching-Produkts wertvollere bankspezifische Arbeit verdrängen würde. Er ist weniger überzeugend, wenn die Anforderungen der Bank außerhalb des unterstützten Betriebsmodells der Engine liegen oder die Organisation nicht bereit ist, klare Verantwortlichkeiten für Konfiguration und Ergebnisse festzulegen.
Ist eine hybride Architektur aus Databricks und Matching Engine die bessere Lösung?
Für viele Bankarchitekturen liegt die sinnvolle Antwort nicht im vollständigen Ersatz einer Plattform durch eine andere. Databricks kann die Umgebung für Datenaufnahme, Transformation, Analytics und kontrollierte Datenprodukte bleiben. Eine Matching Engine kann Datensätze zu Entitäten auflösen. Die Bank kann dann die Verantwortung für den Golden Record, die Survivorship-Richtlinie und das nachgelagerte Kundenmodell behalten.
Diese Aufteilung schafft eine klare Grenze:
- Databricks bereitet kontrollierte Quelldaten auf und nutzt die Ergebnisse der Resolution.
- Die Matching Engine übernimmt Kandidatensuche, Match-Entscheidungen und Entity Clustering.
- Die Bank verantwortet die Definition und Verwendung ihres gemasterten Kundendatensatzes.
- Feedback der Data-Stewards und genehmigte Korrekturen fließen über kontrollierte Workflows zurück.
Das Hybridmodell vermeidet, die Matching Engine als Verantwortliche für jede Entscheidung zu Kundendaten zu behandeln. Zugleich verhindert es, dass das Datenplattformteam dauerhaft ein spezialisiertes Resolution-Produkt pflegen muss. Die Grenze muss ausdrücklich gestaltet werden, insbesondere für Entitätskennungen, erneute Verarbeitung, Löschung, Lineage und Wiederherstellung.
Wie sollte eine Bank Build versus Buy bewerten?
Beginnen Sie mit repräsentativen Fehlerfällen und nicht mit einem bereinigten Durchschnittsdatensatz. Beziehen Sie doppelte Kunden mit wenigen Attributen, gemeinsam genutzte Kontaktdaten, Transliteration, geänderte Namen, widersprüchliche Adressen und Datensätze ein, die trotz oberflächlicher Ähnlichkeit getrennt bleiben sollten.
Bewerten Sie anschließend das vollständige Betriebsmodell mit einem strukturierten Proof of Concept:
- Folgen von Entscheidungen definieren. Eine falsche Zusammenführung und eine übersehene Übereinstimmung können unterschiedliche Risiken verursachen. Legen Sie fest, welche nachgelagerten Prozesse das Ergebnis nutzen und worauf sich jeder Fehler auswirken könnte.
- Resolution und Mastering trennen. Entscheiden Sie, ob der Test Record Linkage, die Erstellung des Golden Record oder beides bewertet. Lassen Sie nicht zu, dass eine überzeugende Matching-Demo eine undefinierte Mastering-Richtlinie verdeckt.
- Erklärbarkeit testen. Prüfer sollten die Evidenz hinter einer Verknüpfung untersuchen, die angewandte Methode verstehen und eine genehmigte Korrektur nachvollziehen können.
- Betriebliche Änderungen testen. Fügen Sie neue Datensätze hinzu, ändern Sie Quelldaten, teilen Sie eine fehlerhafte Entität auf und ändern Sie eine Regel. Beobachten Sie, ob das System verständlich und reversibel bleibt.
- Dauerhafte Verantwortung zuordnen. Weisen Sie jede Ebene einem benannten Team zu, einschließlich Datenqualität, Matching-Konfiguration, Infrastruktur, Stewardship, Incident Response und Anbietermanagement. Das Basel Framework verlangt ebenfalls festgelegte Rollen und Zuständigkeiten für die Dateneigentümerschaft und Qualität von Risikodaten über Fach- und IT-Funktionen hinweg.
- Gesamtumfang vergleichen. Vergleichen Sie beide Optionen anhand derselben Lebenszyklusgrenze. Die Definition der Lebenszykluskosten in der Federal Acquisition Regulation umfasst Erwerb, Betrieb, Support und gegebenenfalls Aussonderung eines Gegenstands. Führen Sie für diese Entscheidung auf beiden Seiten den entsprechenden Implementierungsaufwand und den laufenden Betriebsaufwand auf, statt eine Lizenz mit einer unvollständigen internen Schätzung zu vergleichen.
Anwendungsfälle im Bankwesen erfordern zudem, dass Datenschutzkontrollen und Kontrollen zur Bekämpfung von Finanzkriminalität in den Workflow integriert werden. Nach den Grundsätzen der DSGVO sind Richtigkeit, Datenminimierung und verantwortliche Verarbeitung dafür relevant, wie Identitätsnachweise ausgewählt und aufbewahrt werden. Bei der Customer Due Diligence können aufgelöste Identitäten mit Sanktionsdaten und Daten zu politisch exponierten Personen aus Quellen wie OpenSanctions sowie mit separat gesteuerten Adverse Media Signalen kombiniert werden.
Präzision ist daher nicht nur eine technische Kennzahl. Eine zu weit gefasste Entität kann Informationen im falschen Workflow offenlegen, Screening-Ergebnisse verfälschen oder unnötige Prüfungen verursachen. Der Proof of Concept sollte zeigen, wie das System ein solches Ergebnis verhindert, erkennt und korrigiert.
Wie lautet das praktische Fazit?
Entscheiden Sie sich für eine Databricks-Eigenentwicklung, wenn Ihre Bank bewusst die Produktverantwortung für Entity Resolution übernehmen möchte und diese Entscheidung über Engineering, Stewardship, Governance und Betrieb hinweg dauerhaft tragen kann. Entscheiden Sie sich für eine Matching Engine, wenn das Produkt nachweislich die spezialisierten Mechanismen abdeckt, welche die Bank nicht selbst entwickeln will, während die Bank die Verantwortung für ihre Daten, Richtlinien und Ergebnisse behält.
Entscheiden Sie sich für ein hybrides Design, wenn Databricks bereits die kontrollierte Datenplattform ist, Matching jedoch ein eigenständiger Service bleiben soll. In diesem Modell löst die Matching Engine Identitäten auf, während die Bank die Kontrolle über ihren Golden Record und die davon abhängigen Prozesse behält.
Der fairste Vergleich lautet nicht individueller Code gegen Softwarelizenz. Verglichen wird ein vollständiges Betriebsmodell mit einem anderen, anhand einer gleichwertigen Lebenszyklusgrenze und mit einem benannten Verantwortlichen für jede wesentliche Kontrolle.
Häufig gestellte Fragen
Kann Databricks Entity Resolution durchführen?
Databricks kann die Grundlagen für Data Engineering, Governance und Machine Learning eines individuellen Entity Resolution Systems bereitstellen. Die Fachliteratur zur Entity Resolution unterscheidet Blocking, Linkage, Clustering und Kanonisierung. Eine Bank, die auf Databricks entwickelt, muss ihren eigenen Umfang rund um diese Stufen dennoch festlegen und pflegen, einschließlich Prüfung, Monitoring und Servicebetrieb.
Ersetzt eine Matching Engine Databricks?
Eine Matching Engine muss Databricks nicht ersetzen. Databricks kann Daten aufbereiten und steuern, während die Engine Datensätze zu Entitäten auflöst. Die Resolution-Ergebnisse können an die Datenplattform und die Customer-Mastering-Workflows der Bank zurückgegeben werden.
Wer sollte den Golden Record verantworten?
Die Bank sollte eine klar verantwortliche Stelle für die Definition ihres Golden Record, ihre Survivorship-Regeln und die nachgelagerte Nutzung benennen. Eine Matching Engine kann erkennen, welche Datensätze zusammengehören, ohne die Verantwortung für jedes gemasterte Kundenattribut zu übernehmen. Das Basel Framework verlangt festgelegte Verantwortlichkeiten und Kontrollen für Risikodaten von Banken über Fach- und IT-Funktionen hinweg.
Was sollte eine Bank in die Total Cost of Ownership einbeziehen?
Bei der Total Cost of Ownership sollte für beide Optionen dieselbe Lebenszyklusgrenze gelten. Die Federal Acquisition Regulation definiert Lebenszykluskosten so, dass sie Erwerb, Betrieb, Support und gegebenenfalls Aussonderung eines Gegenstands umfassen. Wenden Sie diese Systematik an, um auf beiden Seiten den relevanten Implementierungsaufwand und den laufenden Betriebsaufwand einzubeziehen.
Was sollte eine Bank in einem Proof of Concept testen?
Eine Bank sollte repräsentative Mehrdeutigkeit, falsche Zusammenführungen, übersehene Übereinstimmungen, Erklärbarkeit, Korrekturen durch Data-Stewards, Regeländerungen, erneute Verarbeitung und Grenzen des Golden Record testen. Der Test sollte neben der anfänglichen Matching-Qualität auch die betriebliche Kontrolle messen.
Quellen
- (Almost) All of Entity Resolution, Binette and Steorts, Science Advances
- Risk data aggregation and risk reporting, Basel Framework, Bank für Internationalen Zahlungsausgleich
- FAR 7.101 Definitions, Acquisition.gov
- Data lineage with Unity Catalog, Databricks
- Manage data quality with pipeline expectations, Databricks
- MLflow Tracking, MLflow
- General Data Protection Regulation, EUR-Lex
- OpenSanctions documentation, OpenSanctions
- Matcher Reference, Tilores Dokumentation
- Transformer Reference, Tilores Dokumentation
- Rules Configuration, Tilores Dokumentation
- Tilores API Reference, Tilores Dokumentation
- Tilores MCP Server, Tilores Dokumentation
- Deployment options, Tilores
Sehen Sie, was aufgelöste Entitätsdaten für Ihr Unternehmen — und Ihre KI — leisten.