Entity-Resolution-Regeln ändern, ohne die Produktion zu gefährden (2026)

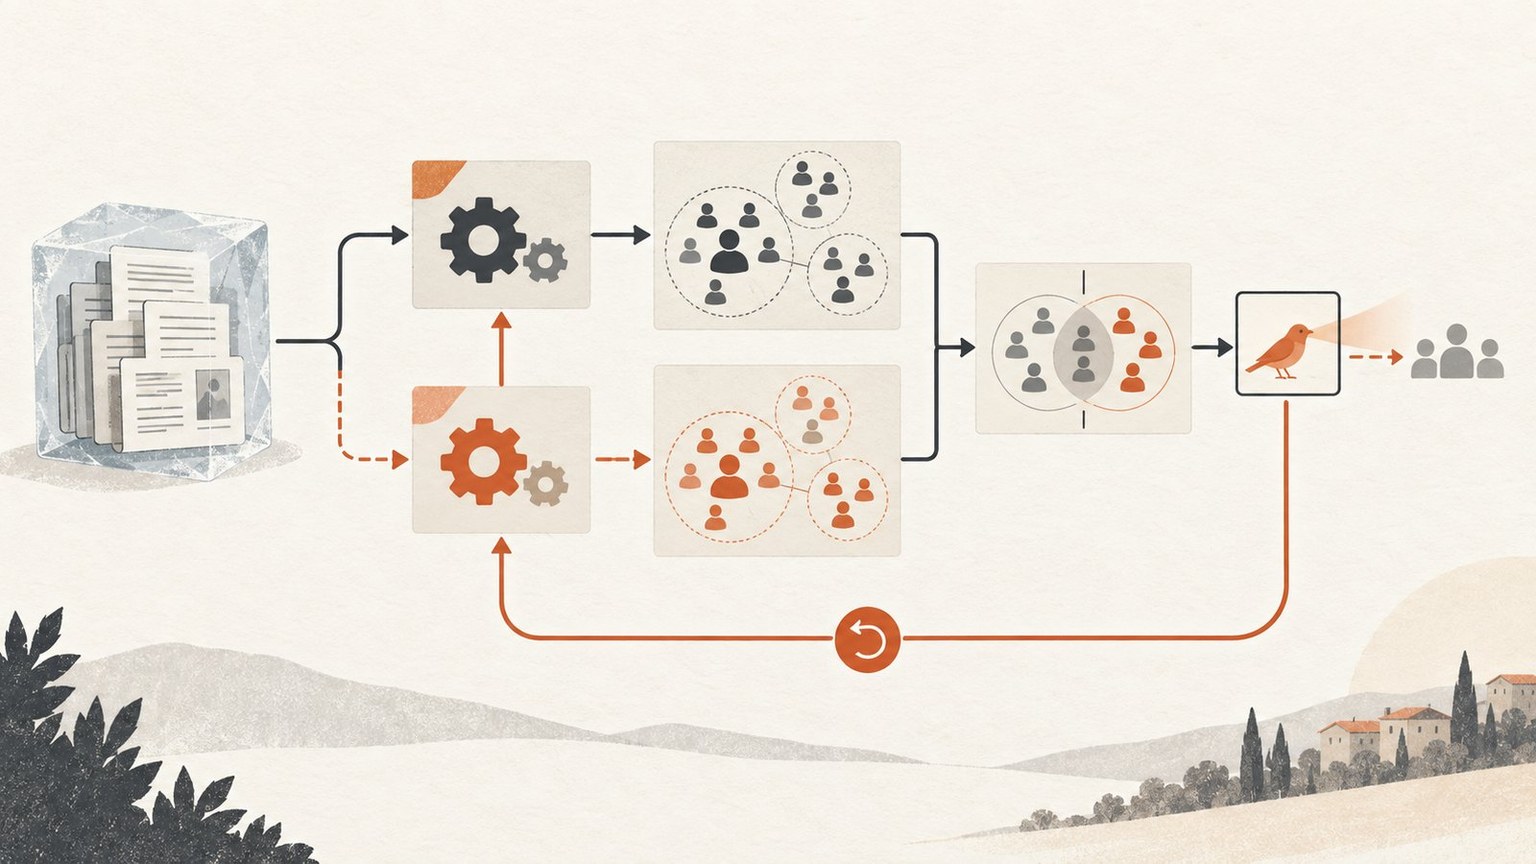
Kurzfassung: Versionieren Sie Regelwerk und Transformationen gemeinsam, spielen Sie einen repräsentativen eingefrorenen Korpus erneut ab und vergleichen Sie Paar- sowie Entitätsdeltas mit geprüfter Ground Truth. Danach folgen Shadow-Betrieb und ein begrenzter Canary. Wir wenden neue Regeln auf neue Daten an. Bereits ingestierte Records müssen mit ihren ursprünglichen IDs erneut eingelesen werden. Die historische Migration ist daher eine eigene, separat belegte Operation.
Prüfen Sie Ihre Matching-Konfiguration mit einem kontrollierten Datenausschnitt. Demo buchen · Tilores Studio kostenlos testen.
Auf dieser Seite
- Warum sind Änderungen an Matching-Regeln besonders riskant?
- Wie wird der Kandidat zuerst auf eingefrorener Evidenz bewiesen?
- Vom Shadow zum Canary ohne vermischte Wahrheit
- Regel-Release mit sieben Gates
- Rollback stellt Bedeutung wieder her, nicht nur Konfiguration
- Welche Evidenz muss einen Regel-Release überleben?
- Wie wenden wir eine Regeländerung in Tilores an?
- Häufige Fragen
- Quellen
Warum sind Änderungen an Matching-Regeln besonders riskant?
Ein gewöhnliches Anwendungsrelease scheitert oft sichtbar: Endpoint-Fehler, steigende Latenz oder ein abgestürzter Prozess. Eine Regeländerung kann schnell und verfügbar bleiben, während sie falsche Records verbindet. Sie kann auch bestehende Entitäten teilen oder einen anderen Kandidaten gewinnen lassen. Der Schaden erscheint später in Kundensichten, Fällen, Analysen oder automatisierten Entscheidungen. Infrastrukturgesundheit ist nötig, misst aber keine Identitätskorrektheit.
Die aktive Matching-Konfiguration wird deshalb wie ein Release-Artefakt behandelt. Dazu gehören Transformationen, Index- oder Blocking-Konfiguration, Matcher, Regeln, Schwellenwerte, Referenzdaten und Modellparameter. Das gesamte Bundle erhält Hash und Version. Ändert sich die Normalisierung bei gleicher Rule-ID, hat sich das wirksame Entscheidungssystem trotzdem verändert und braucht ein neues Release.
Wir beschreiben in unserem FAQ eine wichtige Migrationsgrenze: Neue Matching-Regeln aktualisieren bereits ingestierte Records nicht automatisch. Neue Daten folgen den neuen Regeln. Für bestehende Daten werden dieselben Records mit ihren ursprünglichen IDs erneut ingestiert. Rollout neuer Events und kontrollierte historische Verarbeitung sind deshalb verwandte, aber getrennte Operationen.
Wie wird der Kandidat zuerst auf eingefrorener Evidenz bewiesen?
Aktuelle und neue Konfiguration werden gegen denselben versionierten Korpus abgespielt. Dazu gehören unangetastete Ground Truth, aktuelle Produktionsstichproben, bekannte Vorfälle und quellspezifische Grenzfälle. Verglichen werden mehr als Precision und Recall: gewonnene und verlorene Links, Merges und Splits, Änderungen der Clustergröße, ungelöste Menge und verantwortliche Regeln.
Deltas werden nach ihrer Folge priorisiert. Ein False Merge mit Auswirkung auf ein sensibles Konto kann wichtiger sein als Tausende harmlose Non-Links. Geprüft werden große Clusteränderungen, Verbindungen über geschützte Quellgrenzen, Records mit widersprüchlichen stabilen Kennungen und Fälle aus folgenreichen Workflows. Ein besserer Gesamt-F-Score entschuldigt kein neues Hochrisikomuster.
Das Replay bleibt reproduzierbar. Eingabesnapshot, Schema- und Transformationsversion, aktuelles und neues Bundle, Zufallswerte, Evaluationsrichtlinie und Output-Hashes werden festgehalten. Kann ein überraschender Merge damit nicht reproduziert werden, kann das Team ihn in Produktion weder erklären noch sicher umkehren.
| Vergleich | Frage | Release-Signal |
|---|---|---|
| Paar-Delta | Welche Links kamen hinzu oder gingen verloren? | Geprüfte Gründe für materielle Änderungen. |
| Entity-Delta | Welche Cluster wurden gemergt, geteilt oder vergrößert? | Keine ungeklärte folgenreiche Topologieänderung. |
| Segmentqualität | Wie veränderten sich Quelle, Locale und Risikoklasse? | Grenzen in jedem geschützten Segment eingehalten. |
| Betriebslast | Wie änderten sich Kandidaten, Queue und Latenz? | Kapazität bleibt im getesteten Bereich. |
| Migrationsumfang | Welche bestehenden Records brauchen Reprocessing? | Begrenzter Plan mit Checkpoint und Recovery. |
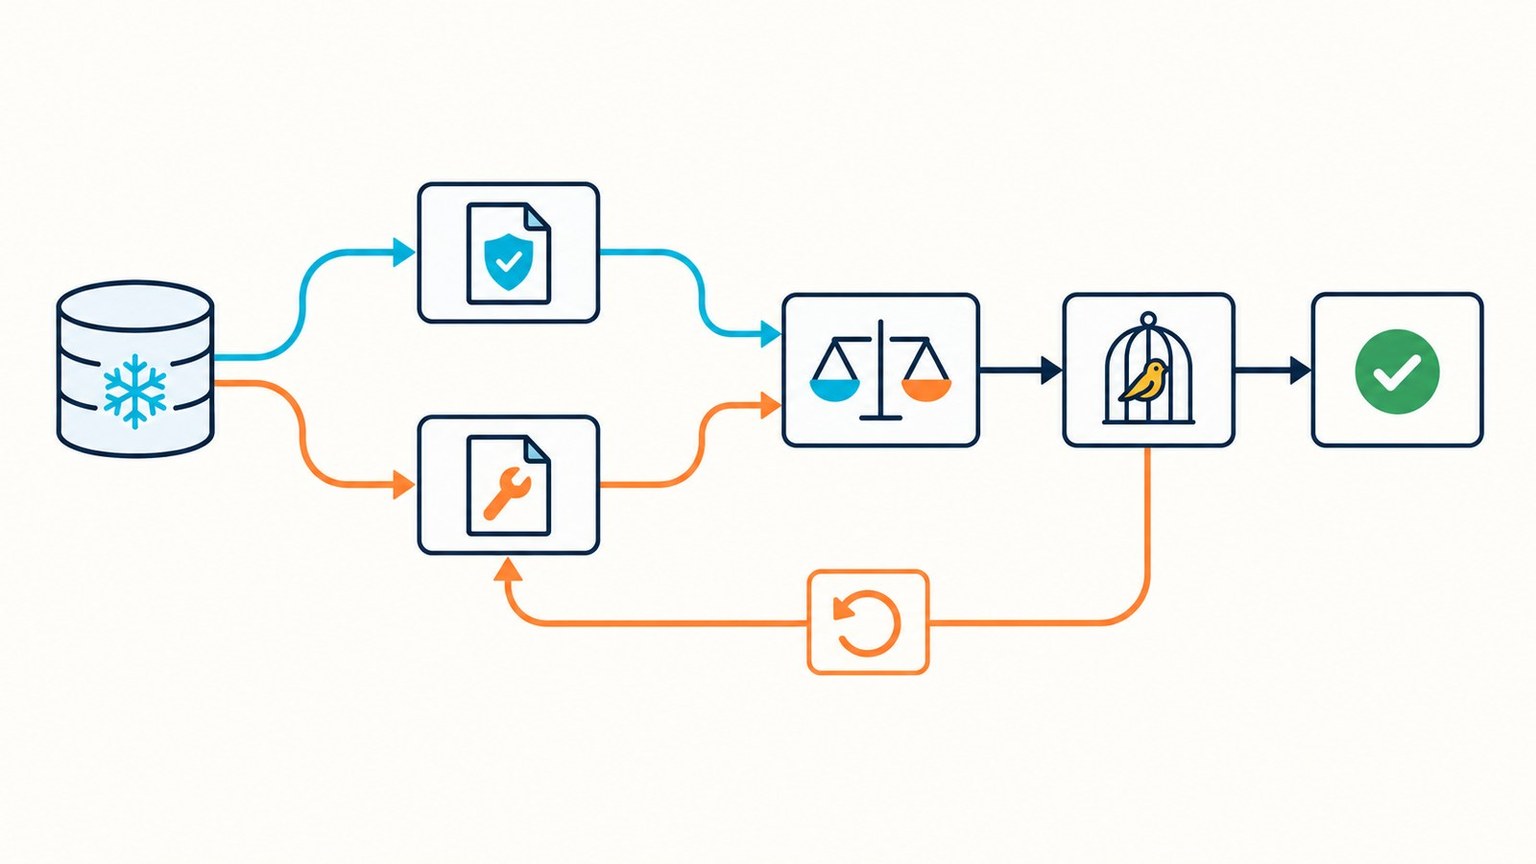
Ein neues Regelwerk erhält Produktionszugriff erst nach reproduzierbarem Replay, Ergebnisvergleich und begrenztem Canary.
Neue Beiträge zu Entity Resolution, Identitätsdaten und KI. Kein Spam, Abmeldung jederzeit möglich.
Vom Shadow zum Canary ohne vermischte Wahrheit
Im Shadow-Modus verarbeitet der Kandidat Live-Input, ohne sein Entitätsergebnis an Produktions-Consumer zu liefern. Abweichungen zwischen Candidate und Control werden untersucht. Das zeigt reale Datenformen und Last, aber nicht die fachliche Wirkung der geänderten Entität, weil sie noch nicht genutzt wird. Dafür ist ein begrenzter Canary da.
Ein Canary exponiert eine kleine, ausdrücklich ausgewählte Einheit wie eine risikoarme Quelle, einen Tenant oder eine Traffic-Partition. Die Google SRE Guidance beschreibt Canaries als teilweise, zeitlich begrenzte Releases mit Control-Vergleich und Rollback. Bei Entity Resolution muss die gewählte Einheit auch Graph-Effekte begrenzen. Können Candidate- und Control-Records im selben Graph verschmelzen, ist die kleine Exposition nur scheinbar klein.
Entscheidungstelemetrie bleibt nach Version getrennt. Gemessen werden Links, Non-Links, ungelöste Fälle, Prüfgründe, nachgelagerte Korrekturen, Entity-Größen und Verarbeitung. Control und Canary werden nicht gemittelt. Die Freigabe ist eine dokumentierte Entscheidung gegen vorher festgelegte Qualitäts- und Betriebsgrenzen.
Regel-Release mit sieben Gates
- Komplettes Candidate Bundle einfrieren. Transformationen, Matcher, Regeln, Indizes, Referenzdaten und Modellparameter werden gemeinsam versioniert. Autor, Absicht und erwartete Wirkung bleiben dokumentiert.
- Regelsimulation und Unit Cases ausführen. Prüfen Sie Grenzbeispiele, fehlende Felder, widersprüchliche Kennungen und Locale-Verhalten. Diese Tests diagnostizieren schnell, ersetzen aber keine Korpusevaluation.
- Repräsentativen Korpus erneut abspielen. Current und Candidate laufen auf Holdout und Produktionsschichten. Paar-, Entity-, Segment- und Betriebsdeltas erhalten reproduzierbare Hashes.
- Folgenreiche Änderungen prüfen. Große Merges, Splits, geschützte Grenzüberschreitungen und sensible Entscheidungen werden vor Online-Exposition erklärt und akzeptiert.
- Live-Input im Shadow verarbeiten. Der Candidate liefert noch keine Ergebnisse. Gemessen werden Kompatibilität, Kandidatenmenge, Latenz und Divergenz bei unveränderter Produktionswahrheit.
- Begrenzten Canary starten. Eine isolierte risikoarme Partition wird mit Control verglichen und durch automatische Stop-Bedingungen geschützt. Graph-Verbindungen dürfen die Grenze nicht ausweiten.
- Freigeben oder mit Migrationskontrolle zurückrollen. Freigabe dokumentiert Version und Zustimmung. Rollback korrigiert bereits geänderte Entitäten. Historische Re-Ingestion ist ein eigener Job mit Checkpoints und Reconciliation.
Rollback stellt Bedeutung wieder her, nicht nur Konfiguration
Die vorherige Regelversion zu aktivieren stoppt neue Candidate-Entscheidungen, macht bereits geänderte Entitäten aber nicht automatisch rückgängig. Recovery identifiziert betroffene Records, berechnet Entity-Mitgliedschaft neu, sendet Merge- oder Split-Korrekturen, invalidiert Caches und gleicht Downstream-Referenzen ab. Dieses Verfahren wird vor dem Canary definiert und auf einem nicht produktiven Snapshot geübt.
Ein Change Ledger hält für jedes Release alte und neue Version, Migrationsumfang, beobachtete Deltas, Freigabe, Start- und Endzeit, Rollback-Kriterien und tatsächliches Ergebnis fest. Spannt ein späterer Vorfall mehrere Releases, grenzt dieser Nachweis die Suche ein, ohne sich auf Erinnerung oder ein veränderliches Dashboard zu verlassen.
Kleine Releases sind leichter zu verstehen. Eine neue Datenquelle, neue Normalisierungsbibliothek, Matcher-Änderung und Schwellenwertkorrektur gehören nicht gemeinsam in einen Schritt. Wenn mehrere Änderungen nötig sind, werden sie offline faktoriell verglichen oder nacheinander freigegeben. Sonst zeigt eine bessere Kennzahl nicht, was geholfen hat, und eine Regression nicht, was zurückgenommen werden muss.
Welche Evidenz muss einen Regel-Release überleben?
Behandeln Sie die Kandidatenkonfiguration als unveränderliches Paket aus Transformationen, Indizes, deterministischen Regeln, Fuzzy-Vergleichen, probabilistischen Features, Schwellenwerten und Referenzdaten. Die Version gehört zu jedem Replay-Ergebnis, damit ein Paar- oder Entitätsdelta auf genau die Logik zurückgeführt werden kann, die es erzeugt hat.
Speichern Sie ursprüngliche Werte neben den normalisierten Matching-Werten. Eine geänderte Normalisierung kann bereits die Kandidatenmenge verändern, obwohl der Matcher gleich bleibt. Mit beiden Formen und der Paketversion lässt sich eine Entscheidung reproduzieren, statt ihre Ursache nachträglich aus dem Produktionsgraphen zu erraten.
Zur Freigabeevidenz gehören Korpus-Hash, Paar- und Entitätsdeltas, geprüfte folgenreiche Fälle, Shadow-Zeitraum, Canary-Kontrolle und Rollback-Ergebnis. Rollback stellt damit ein bekanntes Entscheidungsmodell wieder her und nicht nur ältere Dateien.
Wie wenden wir eine Regeländerung in Tilores an?
Wir kombinieren deterministische, Fuzzy- und probabilistische Verfahren in konfigurierbaren Regelsets. Mit der Simulation aus unserer Regelkonfiguration können Teams das beabsichtigte Verhalten vor dem Deployment prüfen. Der Release-Datensatz benennt trotzdem das vollständige Konfigurationspaket und seine Freigabeevidenz.
Neue Regeln gelten für neue Daten. Bereits ingestierte Records ändern sich nicht automatisch. Soll der Kandidat auf historische Daten wirken, werden dieselben Records mit ihren ursprünglichen IDs erneut eingelesen. Diese Migration ist eine eigene kontrollierte Operation mit Replay-Umfang, Consumer-Prüfung und Rollback-Grenze.
Unser Leitfaden zum End-to-End-Rollout beschreibt den breiteren Cutover. Hier zählt der konkrete Nachweis: Vergleich auf eingefrorener Wahrheit, Beobachtung im Shadow, begrenzter Canary und die Wiederherstellung des vorherigen Entitätszustands im Rollback-Test.
Häufig gestellte Fragen
Kann eine Regeländerung abwärtskompatibel sein?
Die Konfiguration kann erfolgreich geladen werden, während sich Entitätsergebnisse ändern. Verhaltenskompatibilität ist ein beobachtetes Ergebnis aus Replay und Canary und keine syntaktische Klassifizierung.
Aktualisieren neue Regeln bestehende Entitäten automatisch?
Nein. Laut unserem FAQ gelten neue Regeln für neue Daten. Bereits ingestierte Records müssen mit ihren ursprünglichen IDs erneut eingelesen werden.
Was soll einen Canary automatisch stoppen?
Vorab festgelegte Grenzen können unerklärte Links über geschützte Grenzen, große Clusteränderungen, Qualitätsverlust in einem Risikosegment, Queue-Überlast, nachgelagerte Korrekturen oder Betriebsfehler umfassen.
Reicht Shadow Traffic für eine Freigabe?
Nein. Er prüft Live-Input und Divergenz, ohne Candidate-Ergebnisse zu exponieren. Downstream-Wirkung erfordert einen begrenzten Canary und anschließende Reconciliation.
Was bedeutet Rollback nach bereits geänderten Entitäten?
Es stellt das alte Regelwerk wieder her und korrigiert betroffenen Entity-Zustand, Aliase, Events, Caches und Consumer. Nur die Konfiguration zurückzudrehen ist unvollständig.
Quellen
- Tilores documentation: Rules Configuration. Produktspezifisches Verhalten von Regeln, Transformationen, Matchern und Simulation.
- Tilores documentation: Matcher Reference. Funktionsweise deterministischer, unscharfer und probabilistischer Matcher.
- Tilores documentation: Frequently Asked Questions. Aktuelle ID-Stabilität und Folgen von Regeländerungen für bereits ingestierte Records.
- Google SRE Workbook: Canarying Releases. Zeitlich begrenzte Teil-Releases, Vergleich mit einer Kontrollgruppe und Rollback.
- UK Government: Quality assessment in data linkage. Precision, Recall, Trainingsdaten, Grenzen manueller Prüfung und Bewertung von Verknüpfungsfehlern.
- AWS Prescriptive Guidance: Event sourcing pattern. Unveränderliche, geordnete Events, Replay und Versionierung.
- Tilores: Wie ein Entity-Resolution-Rollout 2026 wirklich abläuft – von Anfang bis Ende. Interner Kontext zu gelabelter Wahrheit, Parallelbetrieb und operativer Verantwortung.
Die Beispiele sind Betriebsmuster. Release-Grenzen und Freigabeverantwortung müssen zu den Folgen von Identitätsfehlern im jeweiligen Workflow passen.
Sehen Sie, was aufgelöste Entitätsdaten für Ihr Unternehmen — und Ihre KI — leisten.