Wie deutsche Banken Namen und Adressen vor Entity Resolution normalisieren sollten

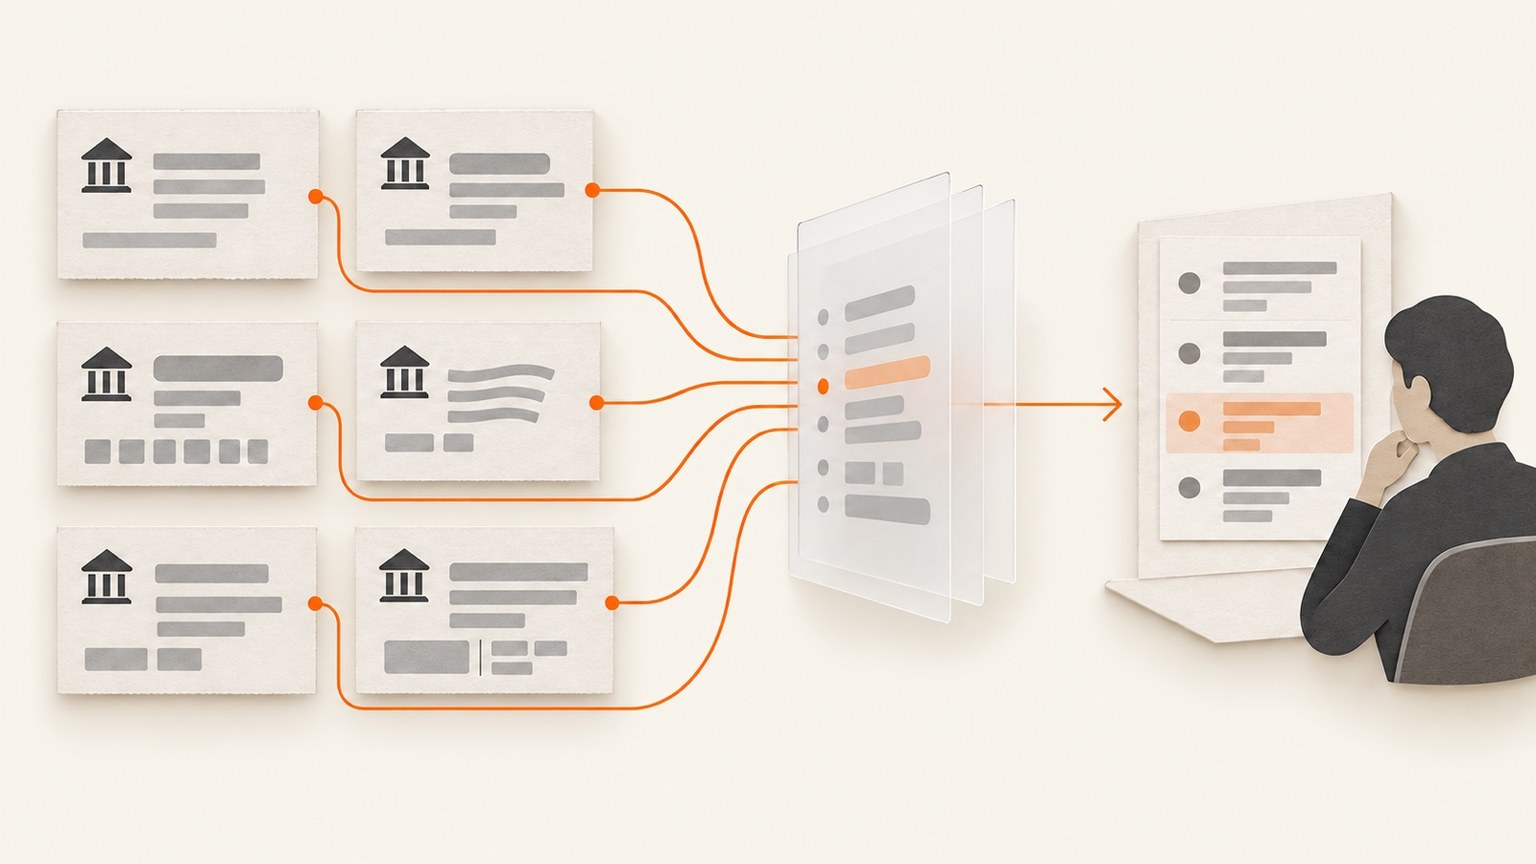
Kurzfassung: Bewahren Sie Namen und Adressen aus den Quellsystemen unverändert auf. Erzeugen Sie daneben versionierte Vergleichswerte, testen Sie deutsche Schreibweisen und Adressfelder anhand beschrifteter Fälle und geben Sie unsichere Treffer in eine menschliche Prüfung. Normalisierung verbessert den Vergleich. Sie beweist weder Identität noch ersetzt sie KYC-, Sanktions- oder PEP-Entscheidungen.
Demo buchen · Tilores Studio kostenlos testen
Auf dieser Seite
- Warum vor dem Matching normalisieren?
- Welche deutschen Varianten prüfen?
- Wie sieht eine nachvollziehbare Pipeline aus?
- Wie gelangen Vergleichswerte in Entity Resolution?
- Was gilt für Screening?
- Woran erkennen Sie einen Nutzen?
- Häufige Fragen
- Quellen
Eine Bank erhält selten für jede Kundin und jeden Kunden genau eine saubere Schreibweise. Ein Testdatensatz kann „Müller“, „Mueller“ und eine Namensform aus einer anderen Schrift enthalten. Straßenname, Hausnummer, Postleitzahl und Ort können in unterschiedlichen Feldern stehen oder zusammen in einer Zeile ankommen. Das Ziel ist nicht, daraus sofort einen angeblich richtigen Master-Wert zu machen. Das Ziel ist, Vergleichsmöglichkeiten zu schaffen, ohne die Herkunft einer Angabe zu verlieren.
Gerade bei einer Zahlungsfreigabe, einer Kontoeröffnung oder einer Screening-Prüfung wäre eine stille Zusammenführung riskant. Zwei ähnlich geschriebene Namen können verschiedene Personen bezeichnen. Eine abgekürzte Straße kann eine gültige Variante oder ein Erfassungsfehler sein. Behandeln Sie jede zusätzliche Schreibweise zunächst als Hypothese für den Vergleich. Erst weitere Merkmale, eine geprüfte Regel und gegebenenfalls eine berechtigte Person dürfen daraus eine Identitätsentscheidung machen.
Warum sollte die Normalisierung vor dem Matching stattfinden?
Computer vergleichen kodierte Werte und keine visuellen Eindrücke. Unicode Normalization Forms beschreibt definierte Formen, mit denen sich bestimmte gleichwertige Zeichenfolgen konsistent darstellen lassen. Wählen Sie eine Form für ein abgeleitetes Vergleichsfeld, dokumentieren Sie die Version und testen Sie, ob dabei für Ihren Zweck wichtige Unterschiede verloren gehen. Bewahren Sie die originale Zeichenfolge daneben auf. Eine technische Umformung darf nicht heimlich zur Änderung des Kundenstamms werden.
Danach kommen bankeigene Vergleichshypothesen. Eine beobachtete Variante von „ä“ und „ae“ kann die Kandidatensuche erweitern. Sie darf nicht pauschal behaupten, dass beide Schreibweisen immer dieselbe Person meinen. Gleiches gilt für „ß“ und „ss“, mehrteilige Familiennamen, Titel und Partikel. Eine Transliteration aus einer anderen Schrift muss die angewandte Konvention und den Quellwert festhalten. Unterschiedliche Systeme können verschiedene Konventionen verwenden. Wer alle Varianten in ein einziges Feld presst, kann später weder den Treffer noch einen Fehler gut erklären.
Bei Adressen ist dieselbe Trennung nötig. Die UPU erläutert Addressing Solutions und S42 als Struktur für Adresskomponenten. Die Bundesnetzagentur benennt für deutsche Anschriften insbesondere Straße, Hausnummer, Postleitzahl und Ort. Das stützt die Modellierung dieser Felder, nicht eine universelle Regel, die jede abweichende Anschrift korrigiert. Trennen Sie extrahierte Komponenten von der originalen Zeile und prüfen Sie, ob die Zerlegung in Ihrem Quellmix tatsächlich funktioniert.
Welche deutschen Namens- und Adressvarianten brauchen eine eigene Prüfung?
Beginnen Sie mit einer Bestandsaufnahme der Varianten, die Ihre Bank wirklich sieht. Ziehen Sie Beispiele aus Kernbank, CRM, Kartenplattform und relevanten externen Zuflüssen. Erfassen Sie für jedes Beispiel Quellsystem, Zeitpunkt, Originalwert, erzeugten Vergleichswert und den Grund der Transformation. Dazu gehören nicht nur häufige Schreibweisen, sondern auch schwierige Grenzfälle und nachweislich verschiedene Personen mit ähnlichen Angaben.
| Variantenklasse | Vergleich als Hypothese | Kontrollrisiko |
|---|---|---|
| Unicode-Darstellung | Eine definierte, versionierte Form in einem abgeleiteten Feld anwenden. | Für den Bankzweck relevante Unterschiede nicht unbemerkt verlieren. |
| Umlaut und Umschrift | Beobachtete Varianten wie ä und ae oder unterschiedliche Schriften getrennt testen. | Eine mögliche Schreibvariante nicht als sichere Gleichheit behandeln. |
| ß und ss | Nur als Kandidatenhypothese mit weiteren Merkmalen nutzen. | Unterschiedliche Namen oder Kennungen nicht zusammenziehen. |
| Titel und Namenspartikel | Wo die Quelle es erlaubt, explizite Felder erhalten und vergleichen. | Keine bedeutenden Bestandteile still entfernen. |
| Deutsche Anschrift | Straße, Hausnummer, Postleitzahl und Ort als getrennte Felder prüfen. | Eine fehlerhafte Zerlegung nicht als neue offizielle Anschrift speichern. |
Ein Dateninventar ist dabei nützlicher als eine große Ersetzungsliste. Markieren Sie, welche Regeln reine technische Normalisierung sind, welche nur Kandidaten erzeugen und welche eine fachliche Entscheidung benötigen. Diese Kategorien sollten im Regelregister und im Review-Werkzeug sichtbar bleiben. So kann eine Prüferin erkennen, ob zwei Werte wegen derselben Unicode-Form, einer beobachteten Schreibvariante oder einer schwachen phonetischen Ähnlichkeit nebeneinanderstehen.
Neue Beiträge zu Entity Resolution, Identitätsdaten und KI. Kein Spam, Abmeldung jederzeit möglich.
Wie bauen Sie eine nachvollziehbare Normalisierungs-Pipeline?
Definieren Sie zuerst den Quellvertrag. Für jeden Eingang muss klar sein, wer das Feld verantwortet, wie oft es aktualisiert wird und ob es ein rechtlich oder operativ maßgeblicher Originalwert ist. Speichern Sie den unveränderten Datensatz mit Quell-ID und Ereigniszeit. Erzeugen Sie Vergleichswerte getrennt davon. Eine Bank muss eine Transformation zurückverfolgen und bei einer geänderten Regel neu berechnen können, ohne die ursprüngliche Kundenangabe zu rekonstruieren.
Als zweiten Schritt wenden Sie eine begrenzte Unicode-Form und einfache, dokumentierte Behandlung von Großschreibung, Leerzeichen oder Interpunktion an. Danach können bankeigene Hypothesen für beobachtete Umlaute, Transliteration und Adressfelder folgen. Halten Sie jede Stufe versioniert. Protokollieren Sie, welche Stufe einen Kandidaten gefunden hat. Die Reihenfolge ist wichtig, denn eine aggressive Regel am Anfang kann später scheinbar gute Treffer erzeugen, deren Grundlage niemand mehr sieht.
Führen Sie anschließend Qualitätsprüfungen aus. Fehlt eine Hausnummer, darf das System nicht so tun, als stimmten zwei vollständige Anschriften überein. Ist ein Feld in der Quelle uneindeutig, geben Sie es zur Datenkorrektur oder menschlichen Prüfung weiter. Eine plausible Normalisierung kann die Kandidatensuche verbessern. Sie ersetzt keine geprüfte Quelle und keine Entscheidung über die Identität.
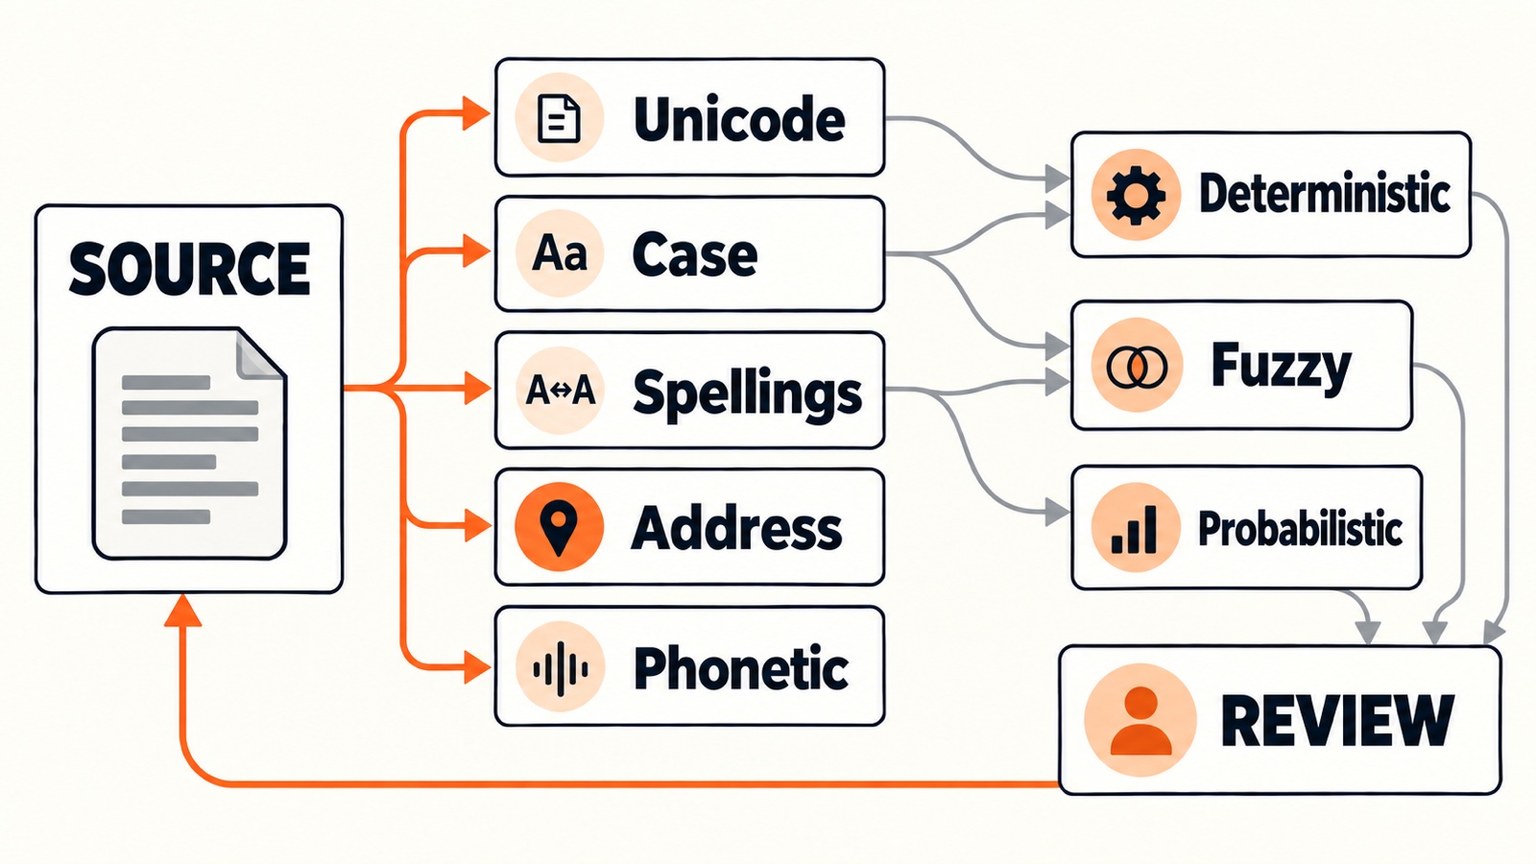
Fünf umkehrbare Vergleichsprüfungen gehen von einem unveränderten synthetischen Quelldatensatz aus. Deterministische, fuzzy und probabilistische Methoden bleiben getrennt und führen unsichere Kandidaten in die Prüfung.
Wie gelangen normalisierte Felder in Entity Resolution?
Nutzen Sie die abgeleiteten Werte für Candidate Generation und Scoring, nicht als endgültigen Kundenstamm. Eine deterministische Regel kann auf einer vertrauenswürdigen eindeutigen Kennung beruhen, wenn die Quelle deren Eigentum und Eindeutigkeit garantiert. Fuzzy Matching kann ähnliche Familien- oder Straßennamen als Kandidaten finden, benötigt aber unterstützende Merkmale. Ein probabilistischer Ansatz kann mehrere teilweise Übereinstimmungen gewichten. Jede Methode braucht eigene Tests und eine nachvollziehbare Begründung.
| Methode | Bankbeispiel | Erforderliche Sicherung |
|---|---|---|
| Deterministisch | Dieselbe geprüfte Kennung aus einer maßgeblichen Quelle. | Eindeutigkeit und Quellverantwortung bestätigen. |
| Fuzzy | Ähnliche Familiennamen oder Straßennamen. | Weitere Merkmale verlangen und häufige Namen separat auswerten. |
| Probabilistisch | Teilweise Übereinstimmungen bei Name, Geburtsdatum und Anschrift. | An beschrifteten Paaren kalibrieren und Komponenten dokumentieren. |
Die Bank legt fest, welche Kombination für welchen Anwendungsfall genügt. Ein Kandidat für eine manuelle Dublettenprüfung muss nicht dieselbe Freigabeschwelle haben wie eine Beziehung, die Zahlungs- oder Zugriffsentscheidungen beeinflusst. Lassen Sie einen nicht geklärten Fall ausdrücklich offen, wenn die verfügbaren Belege keine belastbare Zuordnung erlauben. Eine erzwungene Ja-oder-Nein-Entscheidung versteckt Unsicherheit im Datensatz.
Tilores kann Datensätze über eine API verarbeiten und einen vereinheitlichten Kundenkontext für berechtigte Anwendungen bereitstellen. Die Anleitung zur Abfrage eines Unified Customer Profile zeigt diese technische Grenze. Die Bank behält jedoch die Verantwortung für Quellen, Matching-Policy, Zugriff und Entscheidungen. Eine API macht aus einer schwachen Identitätshypothese keine gesicherte Kundenbeziehung.
Wo gehören Sanktionen, PEP und Adverse Media hin?
Vor Screening kann Entity Resolution helfen, zusammengehörige Kundenunterlagen auffindbar zu machen und widersprüchliche Angaben sichtbar zu halten. Die Europäische Kommission erläutert den EU-Rahmen zur Geldwäscheprävention; ihre Übersicht zu Sanktionen führt zu den einschlägigen restriktiven Maßnahmen. Diese Seiten begründen keinen bestimmten Algorithmus für deutsche Banknamen. Sie zeigen, warum Datenherkunft und getrennte Kontrollprozesse relevant bleiben.
Normalisierte Vergleichswerte können zusätzliche Trefferkandidaten für eine berechtigte Screening-Prüfung liefern. Der Originalname, die Quelle, die angewandte Umformung und die Gründe für eine mögliche Übereinstimmung müssen dabei sichtbar sein. Eine Ähnlichkeit ist kein Sanktions- oder PEP-Treffer. Die jeweilige Screening-Policy bestimmt ihre eigenen Listen, Zuständigkeiten, Eskalationen und Entscheidungen. Dokumentieren Sie, ob der Prüfer einen Datensatz, eine Personenbeziehung oder einen Screening-Hinweis bewertet.
Auch die KYC- und Compliance-Seite von Tilores beschreibt Identitätsauflösung als Unterstützung präziseren Screenings. Lesen Sie das nicht als Ersatz für KYC, AML oder Sanktionen. Die Grenze zwischen besserem Identitätskontext und einer rechtlichen Bewertung muss im Prozess ausdrücklich erhalten bleiben.
Woran erkennen Sie, ob die Normalisierung hilft?
Bauen Sie einen beschrifteten Testsatz aus tatsächlichen Quellvarianten und schwierigen Nicht-Treffern auf. Vergleichen Sie vor und nach jeder Regeländerung, wie viele richtige Kandidaten hinzukommen, wie viele falsche Kandidaten zusätzlich entstehen und wie viel menschliche Arbeit die neue Regel auslöst. Messen Sie Precision und Recall für den gewählten Anwendungsfall. Ein allgemeiner Prozentwert ohne Population, Testset und Konsequenz einer Fehlverknüpfung hilft einer Bank nicht.
Prüfen Sie besonders Namen, die häufig vorkommen, Haushalte mit gemeinsamer Adresse, geänderte Nachnamen und unterschiedliche Schriftsysteme. Kontrollieren Sie, ob die Regel Originalwerte bewahrt und alte Entscheidungen nach einer Korrektur erneut berechnet werden können. Dokumentieren Sie Regelversion, Freigabe, Testfälle und Rücknahmeweg. Für eine Bank ist die Fähigkeit, einen falschen Link zu erklären und zurückzunehmen, ebenso wichtig wie die Zahl der gefundenen Kandidaten.
Ein erster Versuch sollte begrenzt bleiben. Nehmen Sie einen klar benannten Quellmix und eine Entscheidung, deren Folgen die Fachseite versteht. Legen Sie vor dem Versuch fest, wer beschriftet, wer die Matching-Policy genehmigt, wer schwierige Fälle prüft und wann der Versuch gestoppt wird. Wenn die Regel nur mit versteckter Handarbeit oder unklaren Quellen gut aussieht, ist das ein Ergebnis des Tests und kein Grund, die Definition von Erfolg nachträglich zu ändern.
Häufige Fragen
Sollte eine Bank Umlaute vor dem Namensabgleich ersetzen?
Nein, nicht im Originalwert. Testen Sie beobachtete Varianten in getrennten, versionierten Vergleichsfeldern und messen Sie die Folgen für richtige und falsche Kandidaten.
Sind Straße und Strasse immer identisch?
Nein. Die Schreibweisen können in bestimmten Datensätzen eine plausible Vergleichshypothese sein. Eine Identitätsentscheidung braucht zusätzliche Merkmale und eine dokumentierte Regel.
Beweisen ein normalisierter Name und eine normalisierte Adresse dieselbe Person?
Nein. Beide können Kandidaten stützen. Besonders häufige Namen, gemeinsame Anschriften und unvollständige Angaben machen weitere Belege oder menschliche Prüfung nötig.
Soll Screening den normalisierten oder den originalen Wert verwenden?
Die zuständige Screening-Policy entscheidet über die Suche. Der Originalwert, jede abgeleitete Variante, ihre Herkunft und der Entscheidungsgrund müssen für eine berechtigte Prüfung nachvollziehbar bleiben.
Quellen
- Unicode Normalization Forms, Unicode Consortium.
- Addressing Solutions and S42, Universal Postal Union.
- Stationäre Einrichtungen: Anschriftenfelder, Bundesnetzagentur.
- Anti-money laundering and countering the financing of terrorism at EU level, Europäische Kommission.
- Overview of sanctions and related resources, Europäische Kommission.
- How to Query a Unified Customer Profile Through an API in Real Time, Tilores.
- KYC & Compliance, Tilores.
Sehen Sie, was aufgelöste Entitätsdaten für Ihr Unternehmen — und Ihre KI — leisten.