Data Contracts für Entity Resolution: 7 Regeln vor dem Matching (2026)

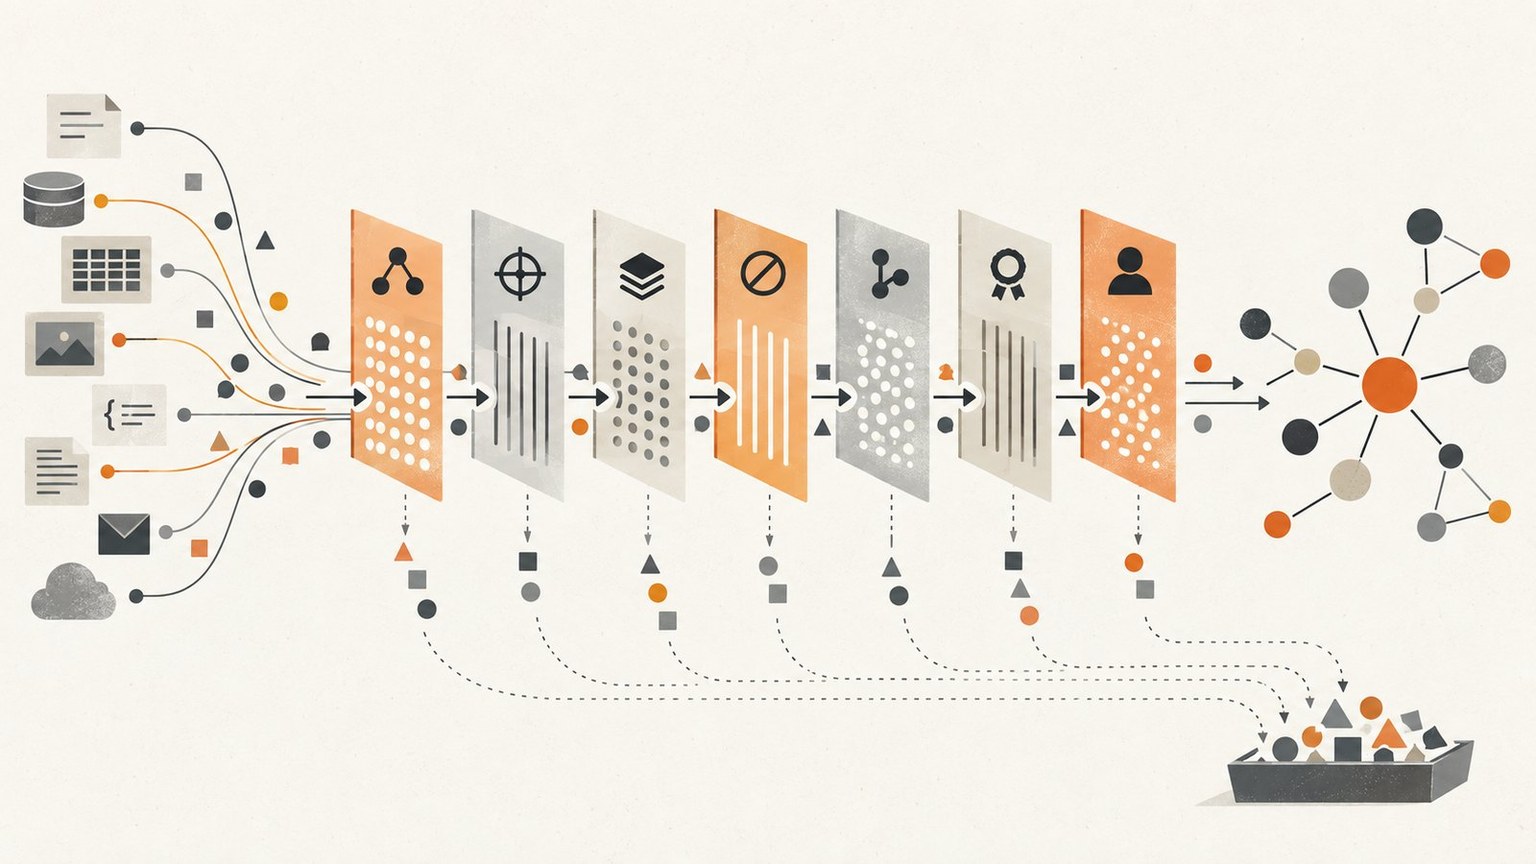
Kurzfassung: Ein Data Contract für Entity Resolution definiert Feldbedeutung, Gültigkeitsbereich von Kennungen, Original- und Normalisierungswerte, Null- und Löschsemantik, Ereignisidentität, kompatible Änderungen und Qualitätsverantwortung. Er zwingt Quellen nicht in dieselbe Form. Er gibt der Resolution-Schicht genügend stabile Bedeutung, um bewusst zu vergleichen, ein Match zu reproduzieren und unsichere Eingaben abzulehnen, statt still zu raten.
Prüfen Sie Ihre Matching-Konfiguration mit einem kontrollierten Datenausschnitt. Demo buchen · Tilores Studio kostenlos testen.
Auf dieser Seite
- Was muss ein Data Contract für Entity Resolution enthalten?
- Was sind die sieben Regeln?
- Kompakte Vertragsübersicht für Identitätsdaten
- Den Vertrag an drei Grenzen durchsetzen
- Wie bewahrt der Vertrag Bedeutung durch das Matching?
- Wie erfüllt ein Data Contract die Tilores Grenze?
- Häufige Fragen
- Quellen
Was muss ein Data Contract für Entity Resolution enthalten?
Ein guter Vertrag beantwortet Fragen, die ein Matcher nicht lösen kann. Identifiziert customer_id eine Person weltweit, ein Konto innerhalb einer Quelle oder eine wiederverwendbare Beziehung? Bedeutet eine leere Adresse unbekannt, gelöscht oder unverändert? Bezeichnet ein Zeitstempel Beobachtung, Speicherung oder Export? Zwei Quellen können dieselben Spaltennamen verwenden und fachlich völlig unterschiedliche Aussagen treffen. Dann kann exaktes Matching präzise falsch sein.
Der Vertrag muss für Quellenverantwortliche, Identity Engineers und Downstream-Consumer verständlich sein. Ein maschinenlesbares Schema erzwingt Form. Textbeispiele und benannte Verantwortliche schaffen Bedeutung. Der Open Data Contract Standard deckt Struktur, Semantik, Qualität, Verantwortung und Serverangaben ab. Für Entity Resolution kommen Gültigkeitsbereich von Kennungen, Änderungsereignisse und Provenienz der Identitätsevidenz hinzu.
Der Vertrag ist kein einmaliges Intake-Dokument. Er ist eine versionierte Schnittstelle zwischen Systemen, die sich unabhängig ändern. Ein Quellteam ergänzt Felder, definiert einen Status neu, ändert Zeichenbehandlung oder wechselt von Snapshots zu Events. Jede Änderung kann Kandidatensuche und Entitätszugehörigkeit beeinflussen, obwohl die Pipeline technisch weiterläuft. Kompatibilität braucht deshalb Verhaltenstests und nicht nur einen erfolgreichen Parser.
Was sind die sieben Regeln?
- Fachliche Bedeutung vor Format definieren. Beschreiben Sie, was jedes Identitätsfeld darstellt, wann es erfasst wird und zu welchem realen Objekt es gehört. Positive und negative Beispiele verhindern, dass etwa ein Haushaltslabel als Personenname in das Matching gelangt.
- Jede Kennung begrenzen. Nennen Sie ausgebendes System, Namespace, Eindeutigkeitsbereich, Lebenszyklus und mögliche Wiederverwendung. Zusammengesetzte Schlüssel listen ihre Bestandteile. Eine intern stabile ID ist nicht automatisch global eindeutig.
- Originale bewahren und Normalisierung festlegen. Quellwerte bleiben für Audit und Debugging unverändert. Vergleichstransformationen für Locale, Transliteration, Interpunktion, Adressen und Telefonnummern werden getrennt definiert und versioniert. Ein neuer Normalisierer kann Kandidaten verändern, ohne dass eine Matching-Regel geändert wurde.
- Nullwert, Löschung und Abwesenheit unterscheiden. Ein fehlendes Feld kann unverändert, unbekannt, nicht erhoben, nicht anwendbar oder bewusst entfernt bedeuten. Definieren Sie Tombstones und Datensatzlöschung. Sonst wird gute Evidenz gelöscht oder zurückgezogene Information ungewollt bewahrt.
- Jedem Ereignis Identität und Zeitmodell geben. Event-ID, Quelle, Typ, Schemaversion, Subject sowie Beobachtungs- oder Wirksamkeitszeit gehören dazu. CloudEvents bietet einen neutralen Kern. Idempotenz und Reihenfolge verhindern doppelte Effekte und das Überschreiben neuer Fakten durch verspätete alte Events.
- Änderungen kompatibel versionieren. Unterscheiden Sie additive, veraltende und brechende Änderungen. Entfernte Kennungen oder Feldnummern werden reserviert, wenn die Serialisierung dies erfordert. Neue und alte Producer-Consumer-Kombinationen werden vor dem Rollout getestet.
- Qualitätsverantwortung und Stop-Bedingungen benennen. Semantik, Produktion und Identity-Interpretation brauchen eigene Ansprechpartner. Vollständigkeit, Gültigkeit und Aktualität werden je Quelle messbar. Eine Warnung ohne Verantwortlichen und definierte Reaktion ist keine Kontrolle.
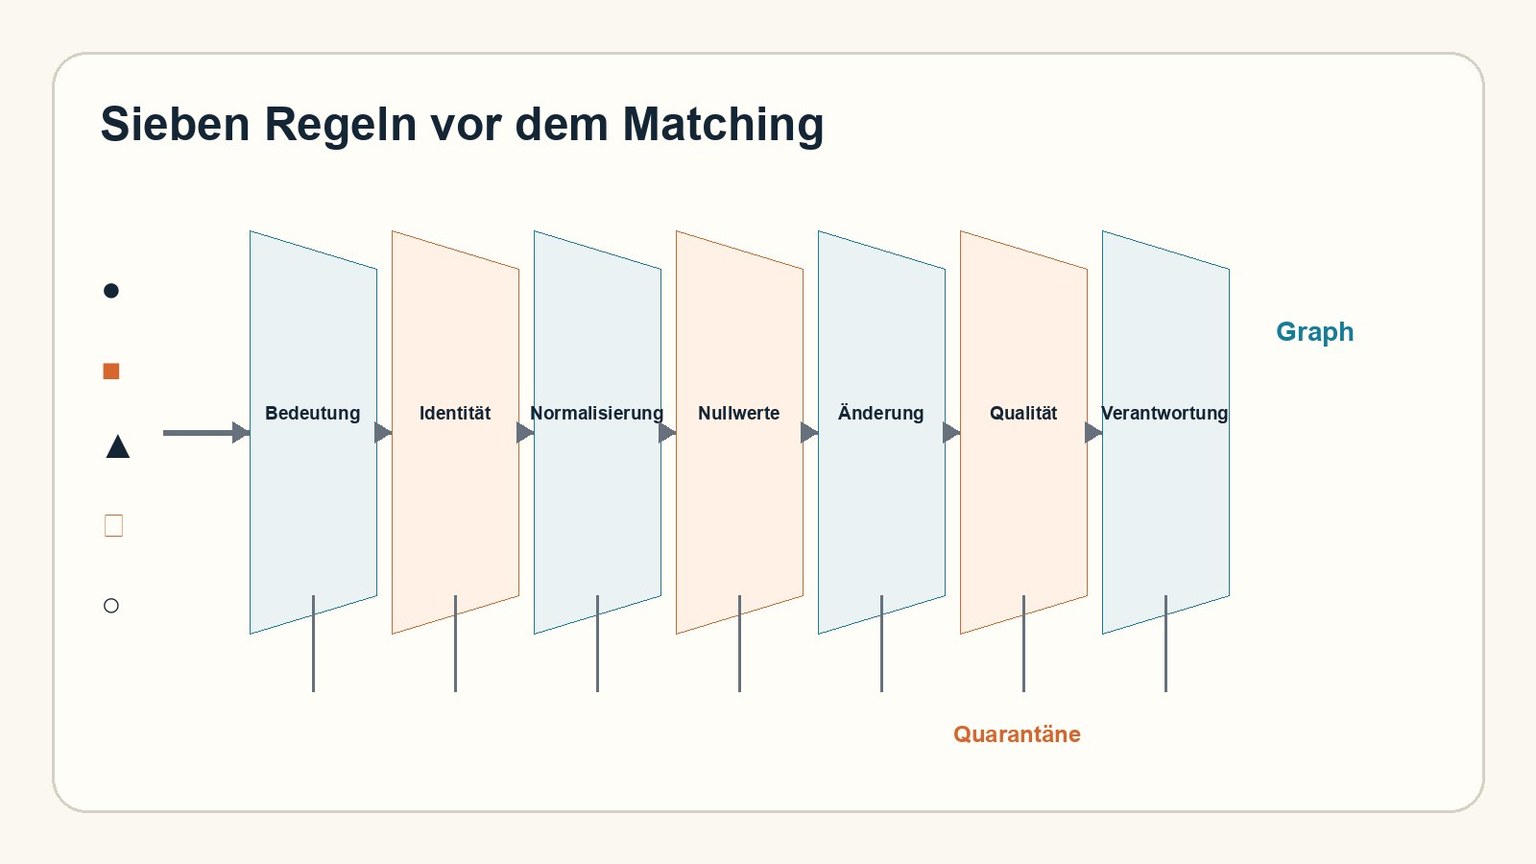
Der Vertrag kontrolliert Bedeutung und Änderung, bevor ein Datensatz in Kandidatensuche oder Matching gelangt.
Neue Beiträge zu Entity Resolution, Identitätsdaten und KI. Kein Spam, Abmeldung jederzeit möglich.
Kompakte Vertragsübersicht für Identitätsdaten
Die folgenden Felder bilden kein universelles Schema. Sie sind eine Prüffläche. Zu jeder Aussage im Vertrag sollte das Team einen Test, einen Verantwortlichen und ein bekanntes Fehlerverhalten nennen können. Erst diese Verbindung macht aus Dokumentation eine betriebliche Grenze.
| Vertragsbereich | Zu klärende Frage | Unsichere Standardeinstellung |
|---|---|---|
| Feldsemantik | Welche reale Tatsache stellt das Feld dar? | Bedeutung aus Name oder Datentyp ableiten. |
| Kennungsbereich | Wo und wie lange ist der Wert eindeutig? | Jede Quellen-ID als Personen-ID behandeln. |
| Normalisierung | Welche gespeicherte Transformation nutzt der Matcher? | Original überschreiben oder Transformation still ändern. |
| Update-Semantik | Wie werden unbekannt, unverändert, entfernt und gelöscht dargestellt? | Jeden fehlenden Wert auf null setzen. |
| Ereignismodell | Wie funktionieren Wiederholung, Reihenfolge und Wirksamkeitszeit? | Ankunftszeit als Wahrheit nehmen und Dopplungen zulassen. |
| Kompatibilität | Welche Producer- und Consumer-Versionen arbeiten zusammen? | Jedes zusätzliche Feld ungeprüft als harmlos bezeichnen. |
| Verantwortung | Wer löst Semantik- und Qualitätsvorfälle? | Unverantwortete Warnungen bei laufender Ingestion senden. |
Den Vertrag an drei Grenzen durchsetzen
Beim Build des Producers werden Schemabeispiele und Kompatibilität geprüft. Bei der Ingestion folgen Payload-Form, semantische Pflichtmetadaten, Ereignisidentität und quellspezifische Qualitätsgrenzen. In der Resolution-Schicht wird geprüft, ob die von aktiven Regeln erwarteten Felder und Transformationsversionen vorhanden sind. Ein Payload kann ein JSON-Schema erfüllen und trotzdem ungeeignet sein, weil sein Identifier-Namespace fehlt.
Für jede Verletzung gibt es einen sicheren Fehlerpfad. Fehlerhafte Datensätze werden mit verständlichem Grund in Quarantäne gestellt. Optionale Felder dürfen nur fehlen, wenn das Regelwerk für diesen Fall getestet wurde. Bricht die Vollständigkeit einer Pflichtkennung ein, wird die Quelle gestoppt. Ziel ist nicht maximale Ablehnung, sondern Schutz vor einer stillen Neupartitionierung von Entitäten bei grünen Pipeline-Dashboards.
Vertragsmetriken werden nach Quelle und Version segmentiert. Eine Gesamtvollständigkeit von 99 Prozent kann einen neuen Producer mit leerem Schlüsselfeld verbergen. Gemessen werden Verteilung fehlender und ungültiger Werte, Schemaversionen, verspätete oder doppelte Events und Ausschlüsse aus Matchern. Jeder Alarm führt zu einem benannten Quellenverantwortlichen und einem dokumentierten Wiederanlauf.
Vor der Freigabe bestätigt ein gemeinsamer Contract-Test außerdem, dass Producer und Resolution-Schicht dieselben Beispiele gleich interpretieren. Dabei zählt nicht nur, ob ein Feld vorhanden ist, sondern ob Namespace, Zeitbezug und Löschbedeutung übereinstimmen. Das Ergebnis wird zusammen mit der Vertragsversion gespeichert.
Wie bewahrt der Vertrag Bedeutung durch das Matching?
Ein Vertrag hält Feldbedeutung, Kennungsraum und Änderungssemantik bei den Werten, die er steuert. Speichern Sie ursprüngliche und normalisierte Formen, damit der Matcher konsistent vergleichen kann, ohne die Quellenbeobachtung zu löschen. Ändert ein Producer ein Feld, entscheidet die Vertragsversion über Kompatibilität, Quarantäne oder Migration.
Null, leer, nicht vorhanden und gelöscht sind verschiedene Zustände. Werden sie zusammengelegt, kann falsche Übereinstimmung entstehen oder ein Wert trotz Rücknahme durch die Quelle erhalten bleiben. Ereignisidentität, effektiver Zeitpunkt und Löschregel gehören deshalb ebenso in den Vertrag wie Typ und Format.
Zur Vertragsevidenz gehören Producer, Owner, Version, Validierungsergebnis und sicheres Fehlerverhalten. Diese Angaben begleiten den ingestierten Record und die resultierende Identity Decision, damit eine Korrektur schlechte Quellenbedeutung von einer schlechten Matching-Regel unterscheiden kann.
Wie erfüllt ein Data Contract die Tilores Grenze?
Wir modellieren Records als Knoten und Matching-Beziehungen als Kanten. Vor der Einreichung validiert der Adapter den Quellenvertrag und bildet akzeptierte Felder auf das konfigurierte GraphQL-Schema ab. Unsere Regeln können dann deterministische, Fuzzy- und probabilistische Verfahren kombinieren, ohne die Bedeutung einer Kennung oder eines fehlenden Werts zu erraten.
Über GraphQL reichen wir aufgelöste Daten ein, suchen und fragen sie ab. An dieser API-Grenze bleiben Quellenidentität, Ereignisidentität und Vertragsversion erhalten, während jeder Consumer nur seine zulässige Sicht bekommt. Ein abgelehnter Payload erhält Owner und Retry-Bedingung, statt still in den Entitätsgraphen gezwungen zu werden.
Der Leitfaden zum End-to-End-Rollout beschreibt das breitere Onboarding. Für diesen Vertrag zählt der engere Nachweis: inkompatible Änderungen scheitern sicher, akzeptierte Records bleiben reproduzierbar und jeder Entitätsfehler lässt sich zur konkreten Quellenbedeutung und Vertragsversion zurückverfolgen.
Häufig gestellte Fragen
Müssen alle Quellen dasselbe Schema verwenden?
Nein. Quellen dürfen unterschiedliche Strukturen behalten, wenn Bedeutung und Mapping explizit sind. Der Vertrag macht Unterschiede vor dem Vergleich bewusst und testbar.
Soll die Normalisierung upstream stattfinden?
Das ist möglich. Die Identity-Schicht braucht trotzdem Originalwert, Transformationsdefinition und Version. Beides zu speichern macht den tatsächlichen Matching-Input reproduzierbar.
Wer verantwortet den Vertrag?
Quellverantwortliche besitzen Bedeutung und Produktion ihrer Felder. Das Identity-Team besitzt die quellenübergreifende Interpretation und Matching-Tests. Ein benannter gemeinsamer Eskalationsweg klärt Mehrdeutigkeit.
Ist ein neues optionales Feld immer abwärtskompatibel?
Nicht zwingend. Es kann Transformationsauswahl, Kandidatensuche oder Consumer-Verhalten ändern. Kompatibilität wird durch Tests beobachtet und nicht allein aus der Syntax abgeleitet.
Was geschieht bei einem Vertragsbruch?
Der dokumentierte Stop-, Quarantäne- oder Degraded-Modus wird aktiviert, der Verantwortliche informiert und betroffene Events für ein kontrolliertes Replay nach der Korrektur bewahrt. Eine vermutete Bedeutung wird nicht still erzwungen.
Quellen
- Linux Foundation: Open Data Contract Standard. Maschinenlesbare Struktur, Semantik, Qualität, Verantwortung und Server-Erwartungen.
- UK Government Data Quality Framework. Verantwortung für Datenqualität, Kommunikation und Lebenszyklus-Kontrollen.
- Protocol Buffers: Programming Guide. Kompatible Schema-Evolution und Reservierung entfernter Felder.
- CloudEvents specification: JSON format. Pflichtattribute für Event-Identität, Quelle, Version und Typ.
- Tilores documentation: Rules Configuration. Produktspezifisches Verhalten von Regeln, Transformationen, Matchern und Simulation.
- Tilores documentation: Matcher Reference. Funktionsweise deterministischer, unscharfer und probabilistischer Matcher.
- Tilores documentation: API. GraphQL-Operationen und der Entity-Event-Stream.
- Tilores: Wie ein Entity-Resolution-Rollout 2026 wirklich abläuft – von Anfang bis Ende. Interner Kontext zu gelabelter Wahrheit, Parallelbetrieb und operativer Verantwortung.
Hinweis zum Umfang: Die Beispiele sind Implementierungsmuster. Aufbewahrung, Zugriff und Änderungssteuerung müssen an die eigenen rechtlichen und betrieblichen Anforderungen angepasst werden.
Sehen Sie, was aufgelöste Entitätsdaten für Ihr Unternehmen — und Ihre KI — leisten.