Architektur für Echtzeit-Entity-Resolution: Wie eine Bank die API in ihren bestehenden Stack integriert

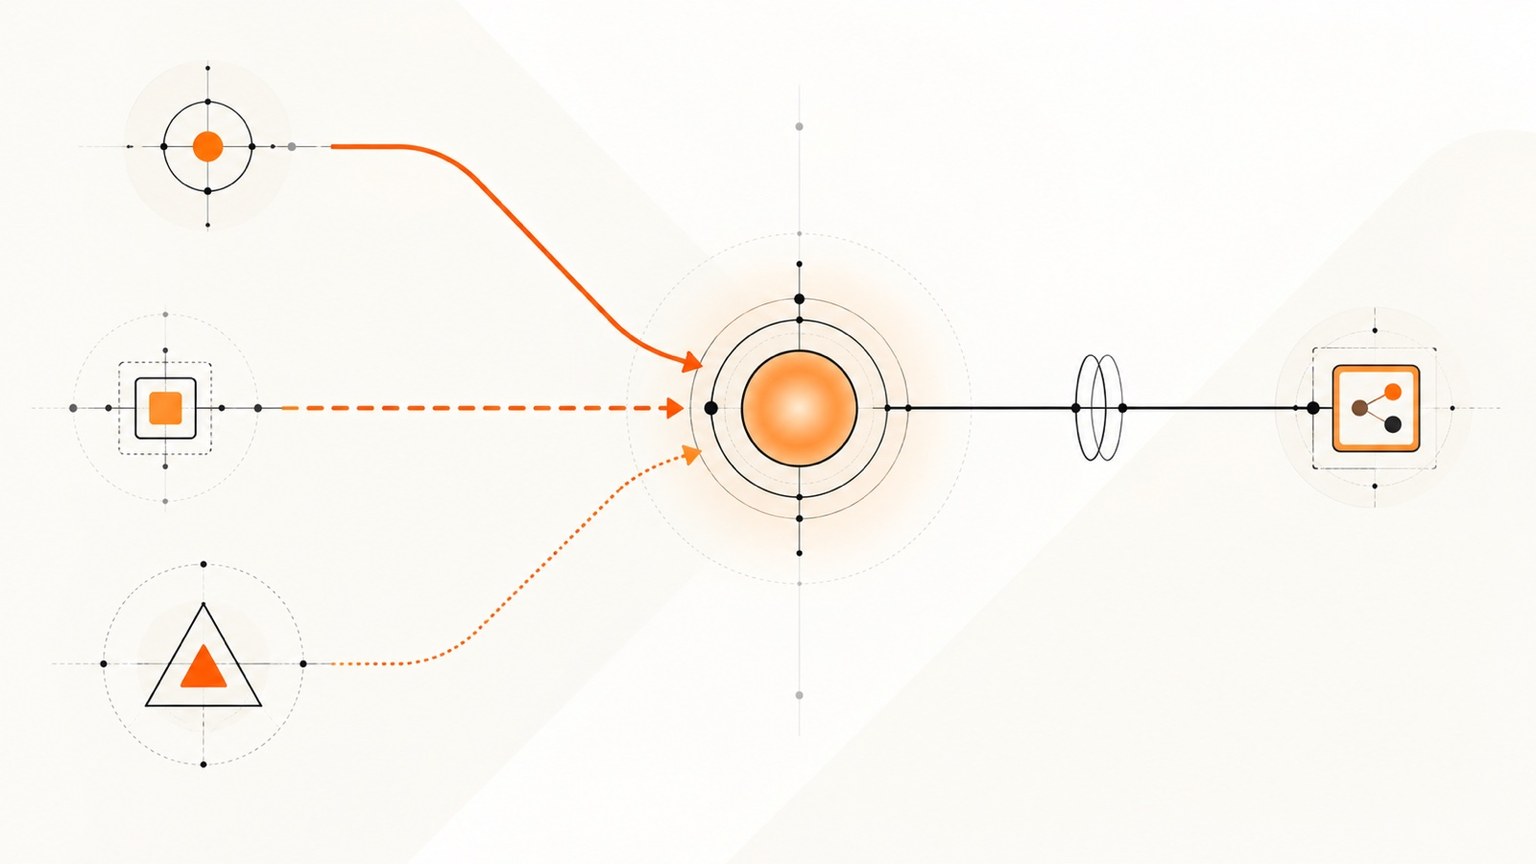
Kurzfassung: Eine Bank integriert Echtzeit-Entity-Resolution über drei unterschiedliche Aufrufmuster: eine synchrone Abfrage zum Entscheidungszeitpunkt innerhalb einer Transaktion, eine ereignisgesteuerte Neuauflösung nach einer vorgelagerten Datenänderung und einen Abrufaufruf durch einen KI-Agenten. Jedes Muster hat sein eigenes Latenzbudget und Retry-Design. Wir stellen alle drei über eine einzige GraphQL-API bereit, je nachdem, welches Muster ein Workflow benötigt.
Demo buchen · Tilores Studio kostenlos testen
Auf dieser Seite
- Welches Integrationsmuster braucht eine Bank wirklich?
- Wo sitzt die API im bestehenden Banking-Stack?
- Wie werden Quelldaten auf die aufgelöste Entität abgebildet?
- Welches Latenzbudget braucht ein synchroner Aufruf zum Entscheidungszeitpunkt?
- Wie hält ereignisgesteuerte Neuauflösung einen Kundendatensatz aktuell?
- Wie ruft ein KI-Agent ein aufgelöstes Profil ab?
- Wann ist eine direkte API-Integration nicht der richtige nächste Schritt?
- Häufig gestellte Fragen
- Quellen
Ein API-Diagramm ist noch kein Integrationsplan für eine Bank. Dieselbe Entity-Resolution-Funktion kann eine unmittelbare Transaktionsentscheidung, eine Neuauflösung nach einer vorgelagerten Datenänderung oder den Abruf durch einen KI-Agenten unterstützen, doch jeder Weg hat andere Zeit- und Wiederanlaufgrenzen.
Die Bank muss daher entscheiden, wo der GraphQL-Aufruf im bestehenden Stack liegt und was bei Verzögerung, Wiederholung oder einer Prüfung geschieht. Authentisierung, Datenzuordnung, Ereignisverarbeitung, Beobachtbarkeit und die Ownership des Deployments machen aus der API einen Betriebsentwurf, den Teams testen können, bevor sie sich darauf verlassen.
Welches Integrationsmuster braucht eine Bank wirklich?
Die meisten Integrationsgespräche beginnen mit einer Frage: Wie rufen wir die API auf? Diese Frage kommt zu früh. Eine Bank muss zuerst benennen, welches von drei Mustern der Workflow braucht, denn jedes hat einen anderen Platz im Stack, ein anderes Latenzbudget und einen anderen Ausfallmodus.
Eine synchrone Abfrage zum Entscheidungszeitpunkt sitzt innerhalb einer Transaktion: Kontoeröffnung, Freigabe einer Zahlung, Prüfung eines Falls. Der Aufrufer wartet auf die aufgelöste Antwort, bevor er fortfahren kann. Eine ereignisgesteuerte Neuauflösung läuft im Nachhinein: eine Aktualisierung im Kernbankensystem, ein neues Dokument, eine korrigierte Adresse trifft ein, und die Entität muss ohne wartende Person neu geprüft werden. Ein Abrufaufruf durch einen KI-Agenten sitzt innerhalb eines dialog- oder agentenbasierten Ablaufs, in dem ein Modell das aufgelöste Kundenprofil braucht, bevor es antworten oder handeln kann.
Alle drei greifen auf dieselben aufgelösten Daten zu. Wir betreiben eine GraphQL-API über jedes Deployment-Modell hinweg, sodass die Wahl des Musters eine Entscheidung der Anwendungsarchitektur ist, keine Frage der Anbieterfähigkeit. Die folgende Tabelle zeigt, wo jedes Muster sitzt, bevor die späteren Abschnitte Budget und Designdetails für jedes einzeln durchgehen.
| Muster | Wo es sitzt | Typischer Auslöser | Latenzbudget | Benötigtes Retry-Design | Beispiel-Workflow im Banking |
|---|---|---|---|---|---|
| Synchrone Abfrage zum Entscheidungszeitpunkt | Innerhalb einer Transaktion, blockiert den nächsten Schritt | Nutzeraktion: Kontoeröffnung, Zahlungsfreigabe, Fallprüfung | Eng; teilt sich das SLA der Transaktion | Idempotenter Aufruf mit clientseitiger Anfrage-ID; Circuit Breaker für eine langsame oder ausfallende Abhängigkeit | Auflösung des Antragstellers, bevor eine Onboarding-Entscheidung zurückgegeben wird |
| Ereignisgesteuerte Neuauflösung | Außerhalb der Transaktion, durch eine Änderung ausgelöst | Vorgelagerte Aktualisierung: neues Dokument, korrigiertes Feld, neuer Quelldatensatz | Locker; kann ohne wartende Nutzer in eine Warteschlange gestellt und wiederholt werden | Zustellung mit mindestens einmaliger Garantie und idempotenter Verarbeitung; Dead-Letter-Behandlung für wiederholt fehlschlagende Fälle | Erneute Prüfung der aufgelösten Identität eines Kunden nach Eingang eines KYC-Aktualisierungsdokuments |
| Abruf durch KI-Agenten | Innerhalb des Kontextaufbaus eines Modells | Ein Agent oder Assistent braucht das aktuelle aufgelöste Profil, bevor er handelt | Eng, teilt sich das Antwortbudget des Modells | Idempotenter Lesevorgang; der Agent soll nicht zweimal auf eine aufgelöste Tatsache reagieren | Ein Assistent bestätigt die verifizierten Angaben eines Kunden, bevor er eine Anfrage abschließt |
Wo sitzt die API im bestehenden Banking-Stack?
Wir trennen die Matching-Engine von der darunterliegenden Infrastruktur. Jedes Deployment-Modell, das eigene AWS-Konto einer Bank, eine andere Cloud, On-Premise oder unser verwalteter AWS-Dienst, läuft auf denselben drei generischen Komponenten: einem Key-Value-Store, einer Message-Queue und einem Objektspeicher. Es gibt keine proprietäre Datenbank und keine anbieterspezifische Laufzeitumgebung, sodass dieselbe GraphQL-API, dieselben Matching-Regeln, Audit-Trails und Compliance-Funktionen überall identisch sind, wo das Deployment läuft.
Diese Trennung macht die drei Integrationsmuster portabel. Eine Bank muss ihren synchronen Aufruf, ihren Event-Handler oder ihren Agenten-Abruf nicht neu gestalten, wenn sie später von einem verwalteten Cloud-Deployment in ihr eigenes AWS-Konto oder eine On-Premise-Umgebung wechselt. Unser Leitfaden zur infrastrukturunabhängigen Bereitstellung behandelt diese Entscheidung vollständig. Betrachten Sie die Deployment-Entscheidung hier als getroffen und schauen Sie stattdessen darauf, was die Anwendungsschicht mit der API macht, sobald sie live ist.
Intern betreiben wir eine dreistufige Pipeline: Extract and Transform, Match and Resolve, dann Search and Insights. Der erste Schritt bildet das eigene Schema einer Bank ab, normalisiert Felder wie Namen, Telefonnummern und Adressen und reichert den Datensatz vor dem Matching an. Der zweite Schritt wendet deterministisches, unscharfes (fuzzy) und probabilistisches Matching an, um eine aufgelöste Entität mit erklärbaren Kanten zu erzeugen. Der dritte Schritt stellt rangiertes Suchen, quellenübergreifende Aggregation und What-if-Analysen über dieselbe GraphQL-Oberfläche bereit. Eine Integration muss nur den dritten Schritt aufrufen; die ersten beiden laufen innerhalb unserer Pipeline.
Neue Beiträge zu Entity Resolution, Identitätsdaten und KI. Kein Spam, Abmeldung jederzeit möglich.
Wie werden Quelldaten auf die aufgelöste Entität abgebildet?
Eine Integration scheitert seltener daran, dass die API schwer aufzurufen ist, und häufiger daran, dass die Abbildung von Quellfeldern auf den Entitätsgraphen nie entworfen wurde. Jeder Feldtyp verhält sich im Matching-Schritt anders, und die Integration sollte damit im Blick gebaut werden, statt jede Spalte als austauschbaren Text zu behandeln.
| Quellfeldtyp | Was die Normalisierung vor dem Matching tut | Folge für die Integration |
|---|---|---|
| Name | Kanonisiert Groß-/Kleinschreibung und Abstände; fließt in deterministischen, unscharfen und phonetischen Vergleich ein | Den ursprünglichen lesbaren Wert senden; ihn nicht clientseitig vor dem Aufruf abschneiden oder hashen |
| Telefonnummer | Normalisiert auf das E.164-Format | Den roh eingegebenen Wert senden, wo möglich; die Normalisierung innerhalb der Pipeline laufen lassen, statt einen Parser clientseitig zu duplizieren |
| Adresse | Komponentenzerlegung und kanonische Form | Strukturierte Komponenten senden, falls das Quellsystem sie bereits hat; ein einzelnes Freitextfeld funktioniert weiterhin, verliert aber etwas Genauigkeit beim Parsen |
| Interne ID oder Konto-ID | Bleibt als stabiler deterministischer Schlüssel erhalten | Dieses Feld für den idempotenten Anfrageschlüssel verwenden, wo das Quellsystem Eindeutigkeit bereits garantiert |
Ist diese Abbildung falsch, läuft die Integration trotzdem, sie löst nur weniger genau auf, was sich später als Problem in der Prüfwarteschlange oder als Falschzusammenführung zeigt, nicht als Integrationsfehler. Die Felder vor dem Schreiben des Aufrufs abbilden, nicht erst nach dem ersten Produktionsvorfall.
Welches Latenzbudget braucht ein synchroner Aufruf zum Entscheidungszeitpunkt?
Ein synchroner Aufruf leiht sich aus dem eigenen Zeitbudget der Transaktion, sodass die Integration wissen muss, was übrig bleibt, wenn die übrigen Schritte dieser Transaktion berücksichtigt sind. Die folgenden Zahlen sind veranschaulichende, klar benannte Annahmen für einen hypothetischen Kontoeröffnungs-Ablauf, nicht das gemessene SLA einer realen Bank.
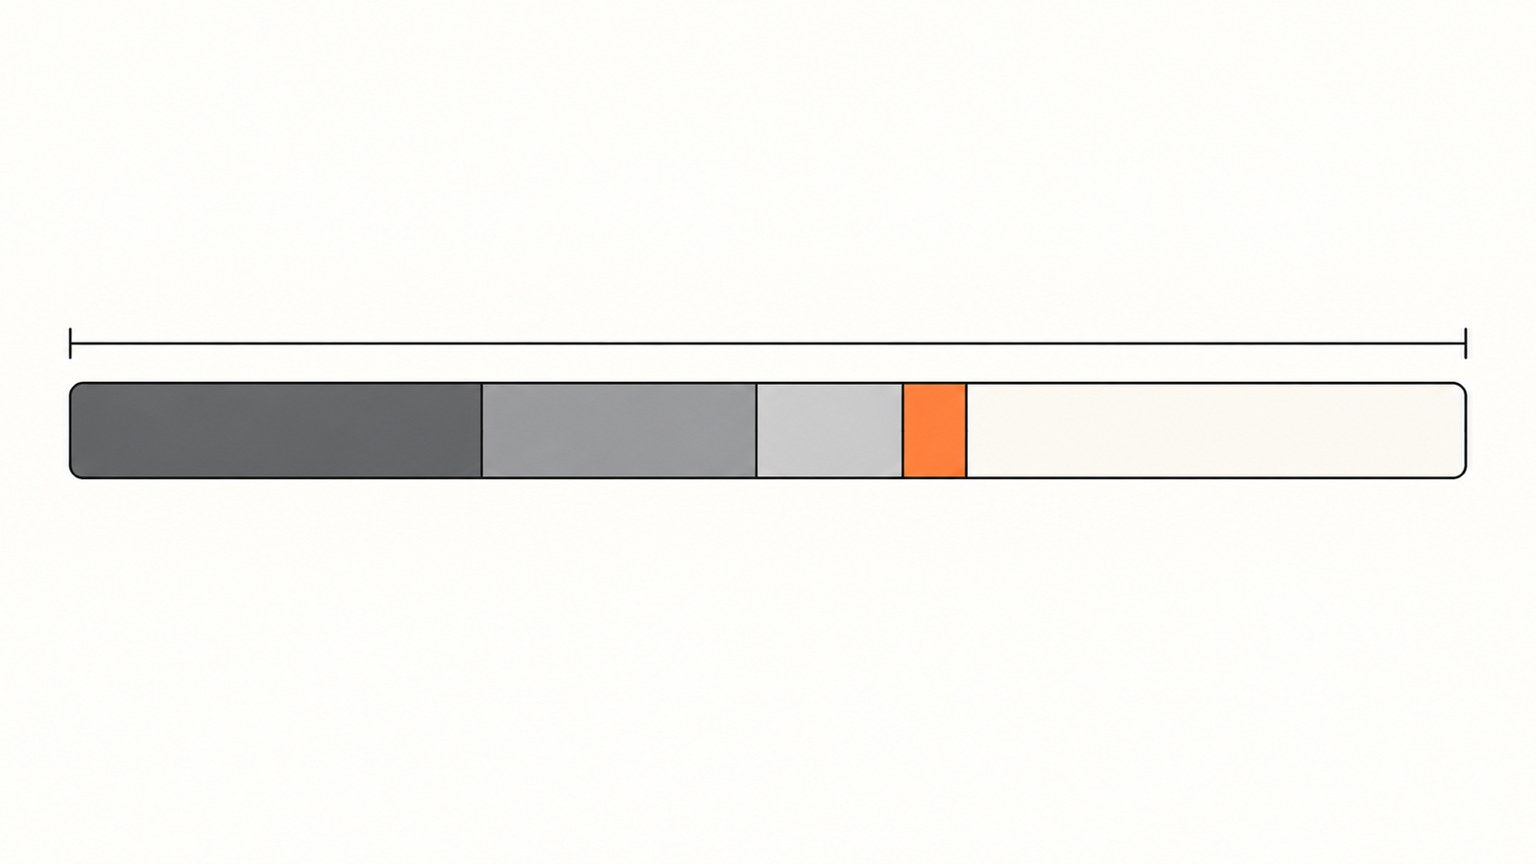
Ein veranschaulichendes Entscheidungsbudget von 2.000 ms für eine Kontoeröffnung, aufgeteilt auf die übrigen Prüfungen der Transaktion, mit verbleibendem Raum für die Entity Resolution.
- Das gesamte Entscheidungsbudget festlegen. Angenommen, die Bank setzt ein Budget von 2.000 ms für die gesamte Kontoeröffnungsentscheidung, Ende zu Ende.
- Die übrigen Schritte der Transaktion abziehen. Angenommen, die Sanktions-, PEP- und Adverse-Media-Prüfung braucht 400 ms, ein Betrugsscore 300 ms und der Schreibvorgang im Kernbankensystem 200 ms. Zusammen bleiben 1.100 ms.
- Den Aufruf zur Entity Resolution gegen das Verbleibende setzen. Unser Aufruf im verwalteten AWS-Betrieb bei rund 150 ms nutzt etwa 14 % des verbleibenden Budgets. Ein selbst gehosteter Aufruf bei rund 1 ms nutzt praktisch nichts davon, was besonders zählt, wenn die Transaktion ohnehin wenig Spielraum hat.
- Den Aufruf so gestalten, dass er einen Retry innerhalb dieses Budgets übersteht. Ein synchroner Aufruf braucht eine clientseitig mitgegebene Anfrage-ID, damit ein Retry nach einem Timeout keinen doppelten Auflösungsversuch erzeugt. Die Amazon Builders’ Library beschreibt einen idempotenten Vorgang als einen, der “retransmitted or retried with no additional side effects” werden kann, eine Eigenschaft, die ein synchroner Aufruf zum Entscheidungszeitpunkt braucht, wenn er sich ein enges Budget mit allem anderen in der Transaktion teilt.
- Die Transaktion vor einer langsamen Abhängigkeit schützen. Martin Fowlers Beschreibung des Circuit-Breaker-Musters ist die Standardantwort auf einen entfernten Aufruf, der “fail, or hang without a response until some timeout limit is reached” kann. Den Aufruf zur Entity Resolution genauso einpacken wie jede andere entfernte Abhängigkeit in der Transaktion, damit ein langsamer Aufruf nicht die ganze Entscheidung blockiert.
Die Sanktions-, PEP- und Adverse-Media-Prüfung gehört bei der Kontoeröffnung und ähnlichen Onboarding-Entscheidungen in denselben synchronen Schritt. Der PEP-Datensatz von OpenSanctions umfasst rund 1,96 Millionen Entitäten, darunter etwa 717.580 individuelle PEP-Ziele in 264 Ländern, abfragbar über eine eigene API. Die Prüfung der Kundensorgfaltspflichten durch die FCA ergab, dass Firmen standardmäßige und verstärkte Sorgfaltspflichten anhand eines risikobasierten Ansatzes unterscheiden, mit eigenen Kontrollrahmen zur Identifizierung von PEPs. Den Kunden vor diesem Prüfschritt korrekt aufzulösen, hält das Prüfergebnis am richtigen Menschen fest, nicht an einem beinahe identischen Duplikatdatensatz.
Banken kennen solche festen Fristen bereits an anderer Stelle im eigenen Betrieb. Die Zusammenfassung des Europäischen Parlaments zur EU-Verordnung über Sofortzahlungen hält fest, dass “the money must arrive into the recipient’s account within ten seconds” und dass eine Sofortüberweisung “supposed to be executed regardless of the day or hour” ist. Ein synchroner Identitätsabgleich innerhalb eines Ablaufs mit einer solchen Frist hat keinen Raum, Latenz als Detail zu behandeln, das sich später beheben lässt.
Wie hält ereignisgesteuerte Neuauflösung einen Kundendatensatz aktuell?
Ein Kundendatensatz bleibt nicht für immer aufgelöst. Ein neues Quellsystem geht in Betrieb, eine Dokumentkorrektur trifft ein, oder ein bestehender Datensatz wird bearbeitet, und die Entität muss neu geprüft werden, ohne dass ein Nutzer wartet. Das ist ein anderes Designproblem als der synchrone Aufruf.
Eine ereignisgesteuerte Integration hört auf die vorgelagerte Änderung, stellt eine Neuauflösungsanfrage in eine Warteschlange und verarbeitet sie über dieselbe GraphQL-API, die auch das synchrone Muster nutzt. Weil niemand auf das Ergebnis wartet, ist das Latenzbudget locker, aber die Zustellgarantie zählt mehr. Eine Message-Queue, die mindestens einmalige Zustellung garantiert, kann dasselbe Ereignis erneut zustellen, sodass der Handler dasselbe idempotente Design braucht wie der synchrone Aufruf, verankert an der Quellereignis- oder Datensatz-ID statt an einer neuen Anfrage-ID bei jedem Versuch.
Ausfälle brauchen einen definierten Pfad, nicht ein stilles Verwerfen. Eine Dead-Letter-Queue für wiederholt fehlschlagende Neuauflösungsereignisse, regelmäßig überprüft, verhindert, dass ein festhängender Datensatz unbemerkt veraltet bleibt. Dieses Muster ist auch der Ort, an dem sich die Normalisierungsentscheidungen einer Bank aus dem Abschnitt zur Schema-Abbildung aufsummieren: Wurde ein Feld bei der ersten Erfassung inkonsistent abgebildet, wiederholt jedes spätere Neuauflösungsereignis diese Inkonsistenz, bis die Abbildung an der Quelle korrigiert wird.
Wie ruft ein KI-Agent ein aufgelöstes Profil ab?
Ein KI-Agent oder Assistent, der Kundendaten bestätigen oder darauf handeln muss, stellt eine dritte Art von Aufruf: einen Abruf, der innerhalb des eigenen Antwortbudgets des Modells abgeschlossen sein muss, mit Daten, die der Agent als gesicherte Tatsache behandeln sollte, nicht als etwas, das er aus dem umgebenden Text erraten kann.
Unser IdentityRAG verbindet sich mit LangChain und Amazon Bedrock, sodass ein LLM ein einheitliches Kundenprofil abruft, bevor es eine Antwort erzeugt, bei derselben Latenz unter 150 ms für die Entity Resolution wie bei den anderen Mustern. Die Designanforderung hier ähnelt eher dem synchronen Muster als dem ereignisgesteuerten: Der Aufruf braucht weiterhin einen idempotenten Lesevorgang, damit ein Agent, der einen Abruf wiederholt, nicht zweimal auf eine aufgelöste Tatsache reagiert, und der Aufruf braucht weiterhin eine Budgetprüfung gegen das eigene Latenzziel des Modells.
Wir veröffentlichen außerdem einen MCP-Server, der einem Assistenten hilft, eine Konfiguration zu entwerfen oder eine GraphQL-Abfrage zu erzeugen. Er führt selbst keine Live-Auflösung durch; die von ihm erzeugte Abfrage läuft weiterhin über unsere GraphQL-API. Diese Grenze beim Entwurf einer Agenten-Integration klar halten: Der MCP-Server ist eine Hilfe zur Entwurfszeit, die GraphQL-API ist der Laufzeitpfad, den alle drei oben genannten Muster letztlich aufrufen.
Das Protokoll hinter diesem MCP-Server behandelt Retry-Sicherheit als etwas, das sich ein Tool-Aufruf verdienen muss, nicht als Standardannahme. Der eigene Leitfaden des Model Context Protocol zu Tool-Annotationen fasst sein idempotentHint in einer Frage zusammen, “Can you safely call it again with the same arguments?”, und erst ein Hinweis mit dem Wert true sagt einem Client, dass ein fehlgeschlagener Aufruf “safe to retry on failure” ist. Ein Auflösungsaufruf, den ein Agent wiederholen kann, braucht dieselbe Antwort, dieselbe clientseitig mitgegebene Kennung und dasselbe idempotente Design wie die synchronen und ereignisgesteuerten Muster oben.
Wann ist eine direkte API-Integration nicht der richtige nächste Schritt?
Eines dieser drei Muster in die Produktion einzubauen, bevor das Matching-Design steht, ist die falsche Reihenfolge. Hat eine Bank noch keinen begrenzten Proof of Concept durchgeführt, keinen gelabelten Wahrheitsdatensatz und noch keinen Konfidenzschwellenwert festgelegt, muss der jetzt investierte Integrationsaufwand später wiederholt werden, sobald diese Antworten die Abbildung oder die Arbeitslast ändern.
Unser Leitfaden zu den PoC-Inputs, die eine Bank braucht, beschreibt, wie diese Vorarbeit aussieht, und unser Leitfaden zu Precision und Recall erklärt, warum der Konfidenzschwellenwert ein bewusster Kompromiss ist, keine Standardeinstellung. Ein Team, das diese Arbeit noch nicht gemacht hat, ist besser bedient, wenn es in Tilores Studio beginnt, das Entity Resolution lokal mit bis zu 100.000 Datensätzen ausführt, ohne Anmeldung außer einer E-Mail-Adresse und ohne dass Daten das Gerät verlassen, statt Produktionsintegrationscode gegen ein noch nicht festgelegtes Matching-Design zu schreiben.
Häufig gestellte Fragen
Unterstützt Tilores einen Aufruf ohne GraphQL?
Nein. Wir stellen eine GraphQL-API über jedes Deployment-Modell und jedes hier beschriebene Integrationsmuster bereit. Ein MCP-Server hilft, eine Konfiguration zu entwerfen oder eine GraphQL-Abfrage zu erzeugen, doch die Abfrage läuft weiterhin über unsere GraphQL-API.
Brauchen die drei Integrationsmuster drei unterschiedliche API-Aufrufe?
Sie rufen dieselbe GraphQL-API und dieselbe aufgelöste Entität auf, aber jedes Muster braucht seinen eigenen Transport, sein eigenes Latenzbudget und sein eigenes Retry-Design um diesen Aufruf herum: einen blockierenden Aufruf innerhalb einer Transaktion, einen Handler mit Warteschlange für Ereignisse und einen modellseitigen Abruf für einen Agenten.
Mit welcher Latenz sollte eine Integration rechnen?
Unsere veröffentlichten Werte liegen bei rund 150 ms im verwalteten AWS-Betrieb und rund 1 ms selbst gehostet. Diese Werte als den Anteil der Entity Resolution an einem größeren Transaktionsbudget behandeln, nicht als das gesamte Budget; das vorangegangene Rechenbeispiel zeigt, wie die übrigen Schritte darum herum bemessen werden.
Ändert ein Wechsel des Deployment-Modells, zum Beispiel vom verwalteten AWS-Betrieb zum eigenen AWS-Konto einer Bank, den Integrationscode?
Nein. Die GraphQL-API, die Matching-Regeln, Audit-Trails und Compliance-Funktionen sind über unsere Deployment-Modelle hinweg identisch, weil die Matching-Engine in jedem Fall auf denselben drei generischen Infrastrukturkomponenten sitzt. Die Integrationsschicht ruft dieselbe API auf, unabhängig davon, wo das Deployment läuft.
Quellen
- Tilores Product: Entity Resolution Infrastructure, Tilores.
- Tilores Deployment Options, Tilores.
- Tilores Studio herunterladen: Kostenlose Evaluierung, Tilores.
- Infrastrukturunabhängige Entity Resolution, Tilores.
- Entity Resolution Proof of Concept: 7 PoC-Inputs für Banken im Jahr 2026, Tilores.
- Precision und Recall in der Entity (Identity) Resolution, Tilores.
- Making Retries Safe with Idempotent APIs, Amazon Builders’ Library.
- CircuitBreaker, Martin Fowler.
- Politically Exposed Persons Dataset, OpenSanctions.
- Firms’ Customer Due Diligence Processes and Controls: Our Findings, Financial Conduct Authority.
- Ensuring Euro Money Transfers Arrive Within Ten Seconds, European Parliament.
- Tool Annotations as Risk Vocabulary: What Hints Can and Can’t Do, Model Context Protocol.
Sehen Sie, was aufgelöste Entitätsdaten für Ihr Unternehmen — und Ihre KI — leisten.