Entity Merges, Splits und stabile IDs in Downstream-Systemen handhaben (2026)

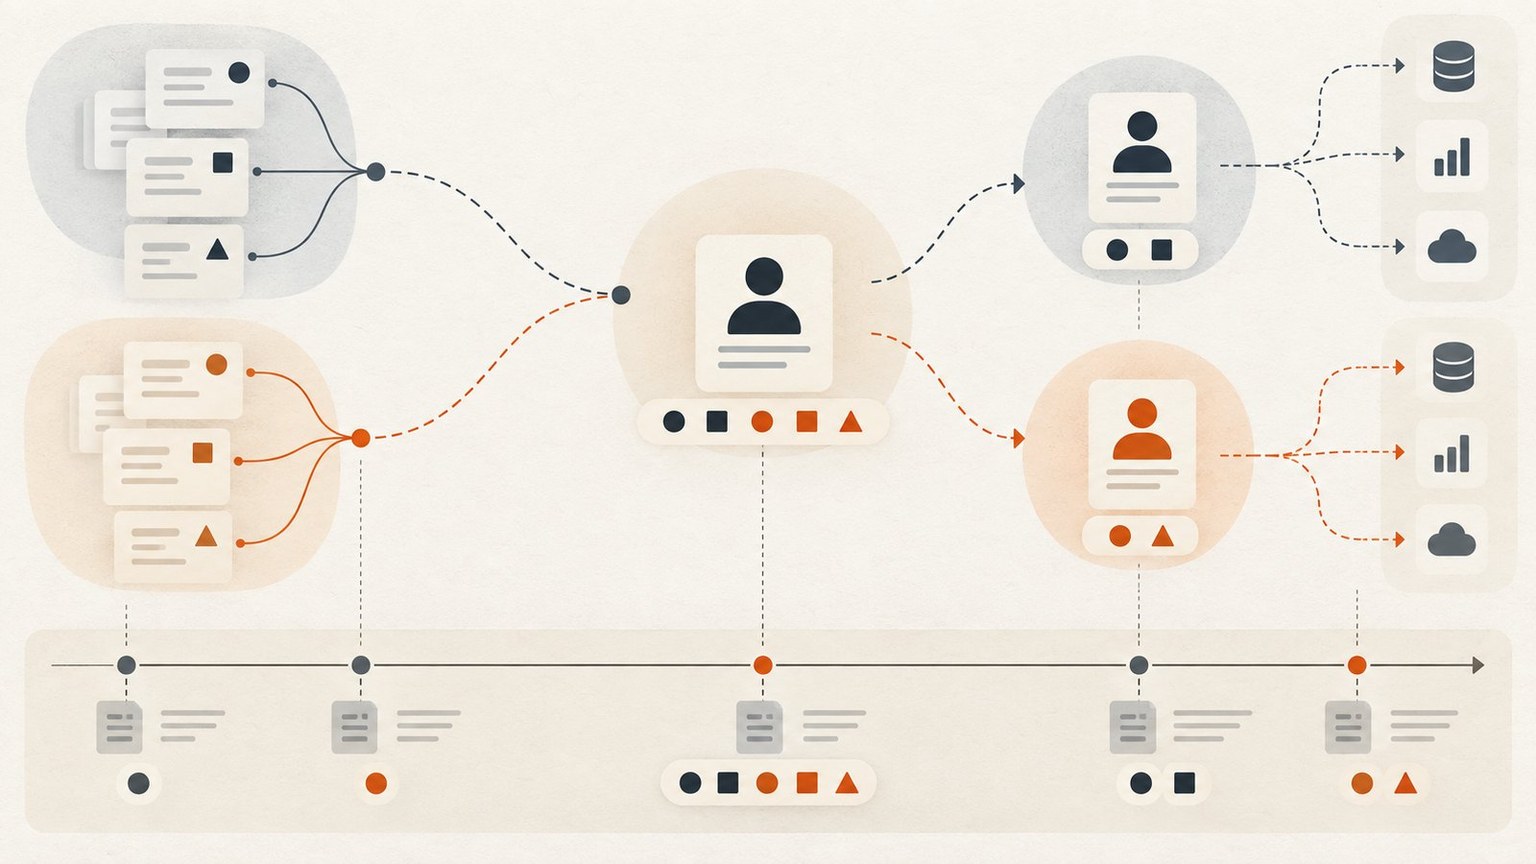
Kurzfassung: Die Korrektheit eines Consumers darf nie davon abhängen, dass sich eine Entity-ID niemals ändert. Bewahren Sie unveränderliche Quellen-IDs, pflegen Sie kanonische und Alias-Mappings, senden Sie idempotente Merge- und Split-Events und lösen Sie Referenzen über eine Identity-Grenze auf. Bei uns bleiben IDs möglichst stabil. Merges, Splits und Löschung können sie dennoch ändern, weshalb Consumer diesen Lebenszyklus ausdrücklich verarbeiten müssen.
Prüfen Sie Ihre Matching-Konfiguration mit einem kontrollierten Datenausschnitt. Demo buchen · Tilores Studio kostenlos testen.
Auf dieser Seite
- Warum kann sich eine Entity-ID ändern?
- Wie werden Record-, Entity- und fachliche Identität getrennt?
- Merges und Splits als öffentlichen Event-Vertrag behandeln
- Checkliste für Downstream-Consumer
- Drei Fehlermuster vor dem Release testen
- Welche Evidenz hält eine Entitätsänderung reversibel?
- Wie verhalten sich Entitätsänderungen in Tilores?
- Häufige Fragen
- Quellen
Warum kann sich eine Entity-ID ändern?
Eine Entität ist eine Schlussfolgerung aus den zu einem Zeitpunkt verfügbaren Records. Ein späterer Datensatz kann zwei bisher getrennte Cluster verbinden. Das Entfernen eines falschen Records oder einer abgelaufenen Kante kann zeigen, dass ein Cluster zwei Identitäten enthält. Wird der letzte Record gelöscht, verschwindet die Entität. Jede korrigierbare Plattform muss diese Änderungen zulassen, auch wenn sie bekannte IDs so weit wie möglich bewahrt.
Wir vergeben eine UUID, wenn eine neue Entität entsteht, und behalten sie bei, während Records derselben Entität hinzukommen. Unsere Dokumentation zu Entitäten beschreibt Ausnahmen. Bei einem Merge bleibt eine relevante ID bestehen. Bei einem Split behält gewöhnlich ein Teil die alte ID, andere erhalten neue IDs. Nach der Löschung der Entität mit ihrem letzten Record stellt eine erneute Ingestion die alte ID nicht wieder her. Das ist Lebenszyklus und kein Verfügbarkeitsfehler.
Eine Downstream-Tabelle mit nur entity_id, aber ohne Quellen-Records, Wirksamkeitszeit oder Alias-Auflösung kann diesen Lebenszyklus nicht deuten. Nach einem Merge verweisen Zeilen auf eine alte ID. Nach einem Split bezeichnet die frühere ID möglicherweise nur einen Nachfolger. Historische Zeilen einfach zu überschreiben wirkt leicht, zerstört aber die Erklärung dessen, was ein Bericht oder eine Entscheidung damals wusste.
Wie werden Record-, Entity- und fachliche Identität getrennt?
Eine Quellen-Record-ID bleibt innerhalb ihres deklarierten Namespace unveränderlich. Die Entity-ID repräsentiert die aktuelle Gruppierung unter einer versionierten Resolution-Richtlinie. Ein Auftrag, Fall oder Gespräch besitzt eine eigene fachliche ID und kann auf die zu einem Zeitpunkt genutzte Entitätssicht verweisen. Diese Trennung verhindert, dass eine Matching-Korrektur die Identität einer Transaktion umschreibt.
Zwischen Consumer und rohen Entity-IDs gehört eine Auflösungsgrenze. Sie liefert die aktuelle kanonische ID für einen Alias, die Lineage von Merge oder Split und die zu einem Zeitpunkt wirksame Entitätsversion. Consumer einer aktuellen Kundensicht folgen dem kanonischen Mapping. Audit, Abrechnung und historische Analysen brauchen möglicherweise eine As-of-Version. Der Vertrag legt die jeweilige Semantik fest.
Aliase sind dauerhafte Referenzen und keine doppelten Entitäten. Wenn B in A aufgeht, bleibt B als Alias für A mit Merge-Event und Wirksamkeitszeit auflösbar. B wird niemals neu vergeben. Ein Split ist schwieriger, weil eine alte Referenz mehrere Nachfolger haben kann. Dann braucht es eine Regel: retained successor, erneute Auflösung aus Quellen-Records oder eine explizite mehrdeutige Antwort. Eine willkürliche Auswahl erzeugt den Fehler erneut im Consumer.
| Kennung | Bedeutung | Lebenszyklusregel |
|---|---|---|
| Quellen-Record-ID | Ein Datensatz in einem Producer-Namespace. | Unveränderlich; Korrekturen kommen als versionierte Events oder Ersatz-Records. |
| Entity-ID | Aktuelle Gruppierung unter einer Resolution-Richtlinie. | Möglichst stabil; kann bewahrt, aliasiert, ersetzt oder gelöscht werden. |
| Entity-Version | Gruppierung und Attribute zu einem Wirksamkeitszeitpunkt. | Append-only oder aus geordneten Events rekonstruierbar. |
| Fachliche Objekt-ID | Auftrag, Fall, Konto oder anderes Domänenobjekt. | Ändert sich nicht allein wegen neuer Identitätsevidenz. |
| Alias | Frühere Entity-ID mit Verweis auf aktuelle Lineage. | Wird nie wiederverwendet und bewahrt Korrekturhistorie. |
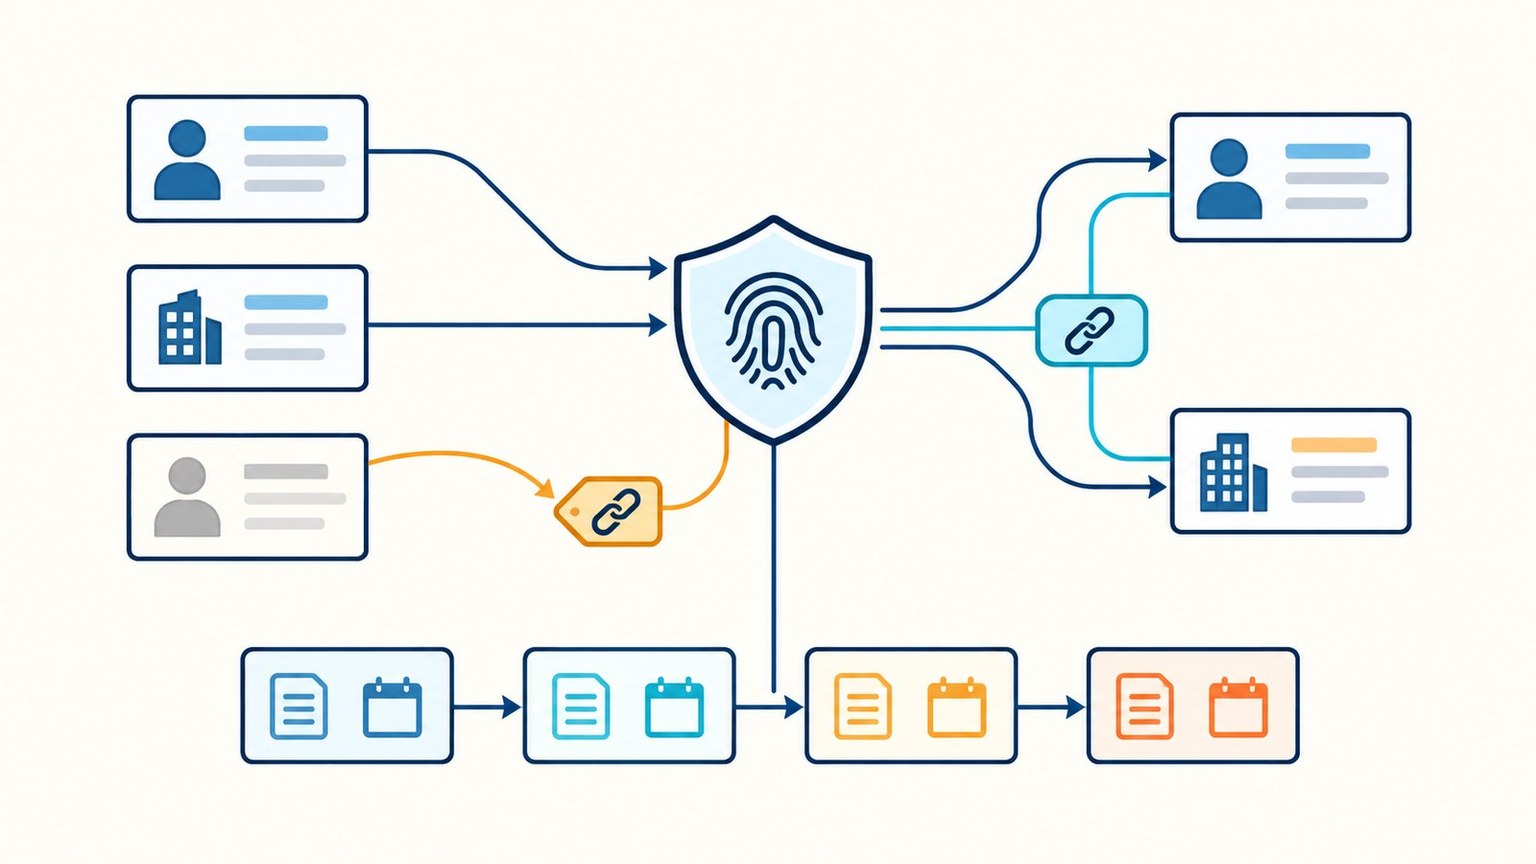
Consumer verarbeiten Identitätsänderung als Ereignis mit Lineage und nicht als stilles Überschreiben einer Kennung.
Neue Beiträge zu Entity Resolution, Identitätsdaten und KI. Kein Spam, Abmeldung jederzeit möglich.
Merges und Splits als öffentlichen Event-Vertrag behandeln
Ein gutes Entity-Change-Event enthält global eindeutige Event-ID, Quelle, Typ, Schemaversion, Ereignis- und Wirksamkeitszeit, betroffene sowie resultierende IDs, Resolution-Richtlinienversion und Idempotenzregel. CloudEvents bietet einen neutralen Umschlag für Identität, Quelle und Typ. Die Domänen-Payload trägt die Lineage. Personenattribute werden nicht gesendet, wenn der Consumer nur Referenzen pflegt.
Events werden erst nach dauerhafter Speicherung der Identitätsänderung veröffentlicht und für jede Lineage geordnet. Consumer speichern die letzte Version oder Event-ID und arbeiten idempotent. Wird Event 42 zweimal geliefert, darf keine Zeile doppelt entstehen und keine fachliche Aktion wiederholt werden. Trifft Event 41 danach ein, muss es als veraltet erkannt werden.
Event Sourcing passt gut, weil Änderungen als geordnete Reihe statt als überschriebenen Zustand erfasst werden. Die AWS Guidance betont unveränderliche Events, Replay und Versionierung. Eine vollständige Event-Sourcing-Architektur ist nicht zwingend. Gleichwertige Evidenz zu Änderung, Grund, Zeit und Wiederaufbau des aktuellen Zustands ist es schon.
Checkliste für Downstream-Consumer
- Alle Consumer inventarisieren. Finden Sie Tabellen, Caches, Features, Suchindizes, Fälle und Modelle mit gespeicherter Entity-ID. Ordnen Sie jedem aktuelle, historische oder Event-Time-Semantik zu.
- Kanonische Auflösung bereitstellen. Eine kontrollierte GraphQL- oder Service-Grenze löst Entity-ID und Alias zur aktuellen Lineage auf. Gelöscht und mehrdeutiger Nachfolger sind explizite Zustände und kein allgemeines Not Found.
- Merge- und Split-Schema definieren. Event-Identität, betroffene und neue IDs, Wirksamkeitszeit, Richtlinienversion und Lineage werden versioniert und mit jedem unterstützten Consumer getestet.
- Consumer idempotent machen. Processing Ledger oder Versionscursor verhindern Dopplungen. Referenzänderungen laufen möglichst transaktional, Retries sind sicher, irreparable Fehler gehen in eine sichtbare Recovery Queue.
- Aliase und Tombstones bewahren. Frühere IDs bleiben mit Status auflösbar. Ein Tombstone unterscheidet Löschung von einem vorübergehenden Lookup-Fehler und verhindert Wiederverwendung.
- Nach einem Split neu auflösen. Bei mehreren Nachfolgern entscheidet Quellen-Record-Evidenz oder autorisierte Prüfung. Historische Objekte wechseln nicht pauschal zu dem Teil, der die alte ID behalten hat.
- Regelmäßig abgleichen. Vergleichen Sie Consumer-Referenzen mit dem kanonischen Dienst, reparieren Sie verpasste Events und messen Sie Verzögerung, veraltete Aliase und ungeklärte Split-Referenzen.
Drei Fehlermuster vor dem Release testen
Testen Sie erstens einen Merge bei offline geschaltetem Consumer. Nach seiner Rückkehr muss er das verpasste Alias-Update vor einer Aktion auf die alte ID anwenden. Testen Sie zweitens einen Split, bei dem historische Aufträge verschiedenen Nachfolgern gehören. Alle Aufträge dürfen nicht allein aus Bequemlichkeit zur retained ID wechseln. Testen Sie drittens Löschung und spätere Re-Ingestion. Die neue ID ist ohne explizite Lineage keine Wiederauferstehung.
Zusätzlich gehören Cache-Ablauf, doppelte Events, vertauschte Reihenfolge, partieller Datenbankfehler und Schemaversionskonflikt in die Tests. Ein perfekter Happy Path ist keine Lebenszyklusimplementierung. Recovery-Evidenz zeigt das zuletzt angewendete Event, die verbliebene veraltete Referenz und mögliche doppelte fachliche Effekte eines Retries.
Ziel ist nicht, Veränderung abzuschaffen. Ziel ist sichere Korrektur. Ein System mit dem Versprechen unveränderlicher IDs kann Referenzen retten, indem es einen falschen Merge bewahrt. Zuverlässige Identity-Infrastruktur lässt Gruppierungen weiterentwickeln und gibt Downstream-Teams einen stabilen Vertrag zum Verständnis dieser Entwicklung.
Welche Evidenz hält eine Entitätsänderung reversibel?
Eine Entity-ID bezeichnet einen Resolution-Zustand, während Quellen-IDs die zugrunde liegenden Beobachtungen bezeichnen. Halten Sie beide Ebenen getrennt. Ein Merge braucht Vorgängerentitäten, erhaltene ID, betroffene Records, Ereigniszeit und aktive Entscheidungsversion. Ein Split braucht zusätzlich die Nachfolger und ihre jeweilige Record-Zuordnung.
Normalisierte Werte helfen beim Matching. Die ursprünglichen Werte bleiben nötig, wenn ein Downstream Owner verstehen muss, warum sich eine Zuordnung geändert hat. Mit beiden Formen kann das Team eine Beziehung erneut abspielen, eine falsche Kante prüfen und ein Fachobjekt nach einem Split dem richtigen Nachfolger zuordnen.
Das Lebenszyklus-Ledger erfasst Erstellung, Merge, Split, Löschung und Alias-Auflösung als versionierte Ereignisse. Operative Consumer erhalten eine aktuelle kanonische Referenz, historische Consumer eine Sicht zum damaligen Zeitpunkt.
Wie verhalten sich Entitätsänderungen in Tilores?
Wir erzeugen eine Entity-ID, wenn ein eingereichter Record zu keiner bestehenden Entität passt, und halten sie stabil, solange weitere Records nur dieser Entität beitreten. Bei einem Merge behalten wir die relevanteste, typischerweise zuerst erzeugte ID. Verursacht eine Entfernung einen Split, bleibt die ursprüngliche ID nach Möglichkeit bei einer Ergebnisentität und die übrigen erhalten neue IDs.
Unser Entity Event Stream stellt Create-, Update-, Merge-, Split- und Delete-Änderungen für nachgelagerte Systeme bereit. Consumer verarbeiten sie idempotent, behalten Aliase und nutzen die betroffene Record-Zuordnung für fachliche Referenzen. GraphQL bleibt die Grenze für Einreichung, Suche und Abfrage des aktuellen Entitätszustands.
Der Leitfaden zum End-to-End-Rollout beschreibt Verantwortung und Cutover. Der Lebenszyklus besteht den engeren Test, wenn Merge, Consumer-Ausfall, Replay und Split vollständig durchlaufen und aktuelle sowie historische Zustände danach stimmen.
Häufig gestellte Fragen
Sind unsere Entity-IDs stabil?
Wir halten IDs nach Möglichkeit stabil. Unsere Dokumentation beschreibt Merges, Splits und Löschung als Fälle, in denen IDs wechseln oder verschwinden. Consumer sollten deshalb den Lebenszyklus implementieren.
Welche ID bleibt bei einem Merge bestehen?
Wir bewahren normalerweise die relevanteste Entity-ID, typischerweise die älteste. Consumer nutzen das veröffentlichte oder abgefragte kanonische Mapping und bauen diese Auswahlregel nicht separat nach.
Welche ID bleibt bei einem Split bestehen?
Gewöhnlich behält eine resultierende Entität die frühere ID, meist der Teil mit den meisten Daten. Andere Teile erhalten neue IDs. Historische Objekte müssen trotzdem anhand ihrer Quellenevidenz neu aufgelöst werden.
Sollen historische Fakten auf die neueste Entity-ID umgeschrieben werden?
Nicht pauschal. Aktuelle Sichten können Aliase auflösen. Historische und auditierte Sichten benötigen oft die Entity-Version, die zum Zeitpunkt des Fakts oder der Entscheidung wirksam war.
Was geschieht bei einem verpassten Entity-Event?
Nutzen Sie Replay und regelmäßigen Abgleich mit dem kanonischen Zustand. Cursor und idempotente Handler sorgen dafür, dass eine Reparatur keine fachlichen Effekte wiederholt.
Quellen
- Tilores documentation: What is an Entity?. Entity-IDs sowie Verhalten bei Merge, Split und Löschung.
- Tilores documentation: Frequently Asked Questions. Aktuelle ID-Stabilität und Folgen von Regeländerungen für bereits ingestierte Records.
- Tilores documentation: API. GraphQL-Operationen und der Entity-Event-Stream.
- Tilores: Ihr eigenes Identity-Resolution-System aufbauen. Interner Kontext zu Anforderungen an Merges und Splits.
- W3C: PROV Constraints. Revision, Invalidierung und Provenance-Regeln über Versionen hinweg.
- CloudEvents specification: JSON format. Pflichtattribute für Event-Identität, Quelle, Version und Typ.
- AWS Prescriptive Guidance: Event sourcing pattern. Unveränderliche, geordnete Events, Replay und Versionierung.
- Tilores: Wie ein Entity-Resolution-Rollout 2026 wirklich abläuft – von Anfang bis Ende. Interner Kontext zu gelabelter Wahrheit, Parallelbetrieb und operativer Verantwortung.
Die Lebenszyklusmuster sind Architekturhinweise. Konkrete Aufbewahrungs- und Korrekturpflichten hängen von Daten, Zweck und Richtlinie ab.
Sehen Sie, was aufgelöste Entitätsdaten für Ihr Unternehmen — und Ihre KI — leisten.