Entity-Resolution-Anbieter mit echten Bankdaten vergleichen: Ein belastbarer Bake-off

Kurzfassung: Ein fairer Bake-off zwingt jeden Anbieter durch denselben kontrollierten Datensatz, dieselbe gelabelte Wahrheit und dieselben Entscheidungsregeln. Bewerten Sie falsche Zusammenführungen, übersehene Treffer, Review-Aufwand, Nachvollziehbarkeit und Betriebsfähigkeit getrennt, bevor Sie einen gewichteten Gesamtentscheid treffen.
Demo buchen · Tilores Studio kostenlos testen
Auf dieser Seite
- Was macht den Vergleich fair?
- Wie bauen Sie den kontrollierten Datensatz?
- Welche Bankfälle gehören in den Test?
- Welche Kennzahlen entscheiden?
- Wie prüfen Menschen Grenzfälle?
- Wie läuft der Bake-off ab?
- Wie entsteht eine belastbare Entscheidung?
- Wie wird Tilores vergleichbar getestet?
- Welche Fachbegriffe sollten alle gleich verwenden?
- Welche Fragen bleiben vor der Unterschrift?
- Welche Quellen stützen die Methode?
Eine Bank kann mehrere Anbieter für Entity Resolution durch dieselbe Präsentation schicken und trotzdem wenig über die tatsächliche Entscheidung erfahren. Der belastbare Vergleich beginnt erst, wenn jeder Anbieter denselben kontrollierten Datensatz, dieselbe verborgene Wahrheit, dieselben Betriebsgrenzen und dieselben Nachweispflichten erhält.
Dann wird der Bake-off zu einem Beschaffungskontrollpunkt statt zu einer Verkaufsdemonstration. Die Bank muss falsche Zusammenführungen von übersehenen Treffern trennen, den Review-Aufwand sichtbar machen und die Testakte so vollständig halten, dass sie ein Ergebnis später erklären kann. Die Auswahl beruht dann auf wiederholbarer Leistung und Betriebsfähigkeit, nicht auf dem besten Vorführfall eines Anbieters.
Was macht den Vergleich fair?
Ein Vendor-Bake-off ist ein kontrollierter Anbieterwettbewerb. Er ist keine Folge von Produktdemos. Fair wird er erst, wenn jeder Anbieter dieselbe Aufgabe unter vorher festgelegten Bedingungen löst. Geben Sie deshalb allen Teilnehmern denselben eingefrorenen Datenstand, dieselben zulässigen Felder, dieselbe Definition einer korrekten Entität und dasselbe Zeitfenster.
Trennen Sie drei Dinge, die in vielen Auswahlverfahren vermischt werden: die Qualität der Auflösung, den Aufwand bis zu diesem Ergebnis und die Eignung für den späteren Bankbetrieb. Ein Anbieter kann auf einem kleinen Datenausschnitt hohe Trefferraten liefern und trotzdem unverhältnismäßig viel manuelles Tuning benötigen. Ein anderer kann schnell integrierbar sein, aber zu viele kritische Kundenbeziehungen falsch zusammenführen. Eine einzige Gesamtnote würde diese Unterschiede verdecken.
Für Banken im Anwendungsbereich der Aufsichtsmitteilung erwartet die Bank of England, dass Institute den Einsatz von Anbietermodellen selbst validieren und die Leistung anhand eigener Ergebnisse überwachen. Dieselbe Supervisory Statement SS1/23 verlangt zudem klare Kriterien für die Auswahl zwischen Kandidatenmodellen. Ein Beschaffungsteam kann diese Disziplin anwenden, ohne jedes Entity-Resolution-System wie ein regulatorisches Kapitalmodell zu behandeln: Es übernimmt die Fragestellung, die Labels und die Nachweispflicht selbst.
Die gemeinsame Leitlinie der US-Bankenaufsichten ordnet das Drittparteienrisiko als Lebenszyklus aus Planung, Due Diligence und Auswahl, Vertragsverhandlung, laufender Überwachung und Beendigung. Ein Bake-off sollte daher nicht nur einen Sieger bestimmen. Er sollte verwertbare Nachweise für die spätere Due Diligence, den Vertrag und die laufende Kontrolle erzeugen. Diese Einordnung folgt der gemeinsamen Leitlinie von OCC, Federal Reserve und FDIC.
Wie bauen Sie den kontrollierten Datensatz?
Beginnen Sie mit einer klaren Zielpopulation. Legen Sie fest, welche Kundentypen, Rechtsträger, Länder, Schriftsysteme, Produkte und Quellsysteme die spätere Nutzung tatsächlich abbilden soll. Ziehen Sie danach eine repräsentative Stichprobe und ergänzen Sie gezielt seltene, aber folgenschwere Fälle. Ein Test nur mit häufigen und sauberen Datensätzen belohnt die einfache Mitte und verschweigt die Grenzfälle, an denen ein Bankprozess scheitert.
Erstellen Sie eine unveränderliche Eingabekopie und dokumentieren Sie für jedes Feld Herkunft, Bedeutung, Format und bekannte Qualitätsprobleme. Prüfen Sie gemeinsam mit Datenschutz, Informationssicherheit und den verantwortlichen Fachbereichen, welche echten Daten erforderlich sind, welche Felder transformiert werden können und welche Zugriffsbeschränkungen gelten. Der Bake-off braucht genug Realität, um Matching-Verhalten sichtbar zu machen, aber keine unkontrollierte Kopie der gesamten Produktionslandschaft. Nach dem Grundsatz der Datenminimierung der ICO müssen personenbezogene Daten angemessen, erheblich und auf das für den Zweck notwendige Maß beschränkt bleiben; das gibt vor, welche Felder in den Testdatensatz gehören und welche nicht.
Nach der ICO-Leitlinie zur Pseudonymisierung bleiben pseudonymisierte Daten für die Stelle mit den zusätzlichen Informationen personenbezogene Daten. Gibt die Bank pseudonymisierte Daten ohne diese Zusatzinformationen weiter, können sie für den Empfänger anonym sein; entscheidend ist laut ICO zur Wirksamkeit der Anonymisierung, ob er Personen vernünftigerweise aus diesen oder anderen Informationen identifizieren kann. Die Bank hält die Zusatzinformationen getrennt und sicher und prüft zugleich, ob die Transformation gerade die Merkmale entfernt, die der Matcher testen soll.
Bauen Sie die gelabelte Wahrheit unabhängig von den Anbietern. Ein kleines, erfahrenes Team entscheidet für jedes relevante Datensatzpaar oder jeden Cluster zwischen Match, Non-Match und Unklar. Kritische Fälle sollten zwei Prüfer unabhängig bewerten. Uneinigkeit geht in eine dokumentierte Adjudikation. Unklare Fälle bleiben eine eigene Klasse und werden nicht nachträglich so umetikettiert, dass ein Ergebnis besser aussieht.
Teilen Sie die Fälle vor Testbeginn in einen Kalibrierungsanteil und einen versiegelten Holdout. Anbieter dürfen am Kalibrierungsanteil Regeln oder Schwellen einstellen. Der Holdout bleibt bis zur finalen Ausführung verborgen.
Neue Beiträge zu Entity Resolution, Identitätsdaten und KI. Kein Spam, Abmeldung jederzeit möglich.
Welche Bankfälle gehören in den Test?
Stratifizieren Sie den Datensatz, damit ein gutes Ergebnis nicht nur aus vielen leichten Fällen entsteht. Nehmen Sie exakte Kennungen, Namensvarianten, transliterierte Namen, frühere Adressen, gemeinsame Haushaltsdaten, wechselnde Kontaktdaten, juristische Personen, wirtschaftlich Berechtigte und absichtlich ähnliche Nicht-Treffer auf. Ergänzen Sie fehlende Werte, widersprüchliche Quellen und zeitlich überholte Attribute.
Der Testkatalog muss Fälle für Sanktionen, PEP und Adverse Media enthalten. Diese Fälle prüfen nicht, ob die Entity-Resolution-Engine die Entscheidung eines Compliance-Teams ersetzt. Sie prüfen, ob Identitäten, Aliase und Quellen so zusammengeführt werden, dass ein nachgelagerter Kontrollprozess die richtigen Belege sieht. Nutzen Sie dafür bankfreigegebene Watchlist- und Fallquellen wie den OpenSanctions-Standarddatensatz, jeweils mit den erforderlichen Lizenzen und Kontrollen. Unser KYC- und Compliance-Workflow folgt genau dieser Reihenfolge: zuerst auflösen, danach prüfen.
Fügen Sie harte negative Paare hinzu. Dazu gehören zwei Personen mit gleichem Namen und Geburtsjahr, Familienmitglieder an derselben Adresse sowie Unternehmen mit ähnlichen Handelsnamen. Solche Fälle machen falsche Zusammenführungen sichtbar. Ergänzen Sie harte positive Paare, bei denen Schreibweise, Sprache, Adresse oder Quellsystem voneinander abweichen. So messen Sie übersehene Beziehungen. Beide Fehlerarten brauchen getrennte Schwellen und getrennte Eigentümer.
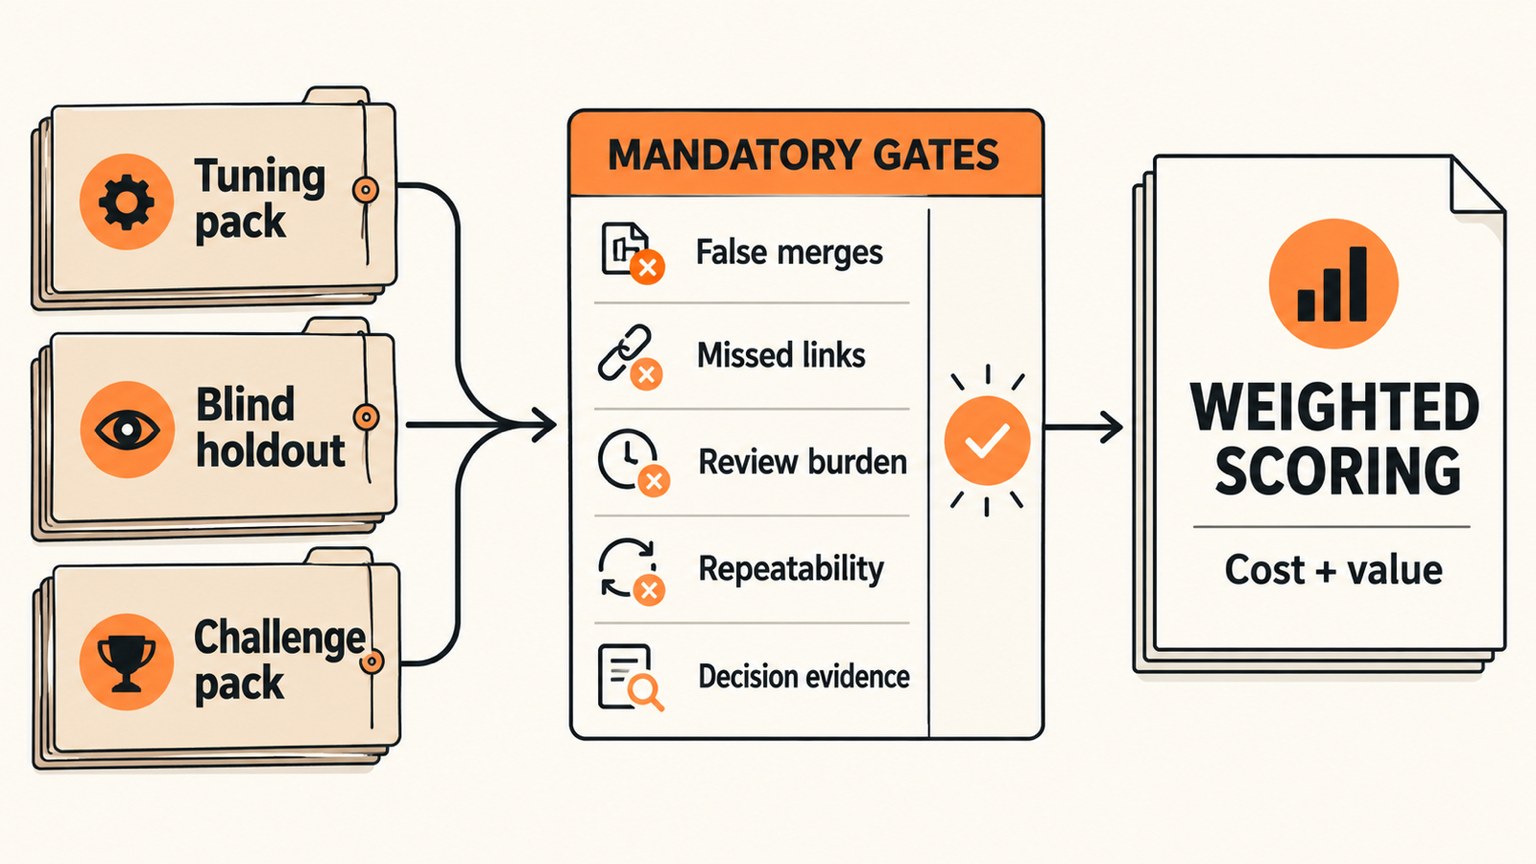
Drei Datenpakete durchlaufen fünf Pflichtprüfungen, bevor die gewichtete Bewertung entscheidet.
Welche Kennzahlen entscheiden?
Bewerten Sie mindestens auf Paar-, Cluster- und Arbeitskorbebene. Nach einer Arbeitspapier-Definition des US Census Bureau ist Precision der Anteil korrekt ausgewählter Verknüpfungen an allen ausgewählten Verknüpfungen, Recall der Anteil korrekter Verknüpfungen, die das System tatsächlich findet. Paarmetriken zeigen, ob einzelne Verknüpfungen stimmen. Clustermetriken zeigen, ob eine ganze Kundenentität korrekt zusammengesetzt wurde. Der Arbeitskorb zeigt, wie viele Fälle Menschen prüfen müssen und ob die bereitgestellten Belege eine schnelle, konsistente Entscheidung erlauben.
| Kriterium | Messung | Entscheidungsfrage |
|---|---|---|
| Precision | Korrekte Matches geteilt durch alle vorgeschlagenen Matches | Wie häufig führt der Anbieter zwei verschiedene Kunden fälschlich zusammen? |
| Recall | Gefundene echte Matches geteilt durch alle gelabelten echten Matches | Wie viele zusammengehörige Datensätze bleiben getrennt? |
| Cluster-Qualität | Vollständig korrekte Entitäten und Art der Clusterfehler | Entsteht eine nutzbare Kundensicht statt nur guter Paarwerte? |
| Review-Last | Anzahl, Dauer und Uneinigkeit manueller Prüfungen | Ist der Grenzfallprozess im vorgesehenen Betriebsmodell tragbar? |
| Erklärbarkeit | Verfügbare Felder, Regeln, Scores, Quellen und Versionsinformationen | Kann ein Prüfer die Entscheidung nachvollziehen und anfechten? |
| Betriebsfähigkeit | Einrichtung, Wiederholung, Änderungen, Export und Fehlerbehebung | Kann die Bank den Prozess kontrolliert betreiben? |
Gewichten Sie diese Kriterien vor der Ergebnisöffnung. Wenn eine falsche Zusammenführung schwerer wiegt als ein übersehener Treffer, muss dies in einer Mindestschwelle für Precision und nicht nur in einem späteren Gespräch erscheinen. Messen Sie die Werte auch je Segment. Ein Gesamtergebnis kann einen schwachen PEP-Fall, ein bestimmtes Schriftsystem oder eine einzelne Datenquelle verdecken.
Für disjunkte Segmente legen Sie Zähler, Nenner und Quote einzeln offen. Die Gesamtrate falscher Zusammenführungen und übersehener Verknüpfungen berechnen Sie aus den gepoolten Zählern und Nennern, nicht als Durchschnitt der Segmentprozente. Definieren Sie vor dem gewichteten Vergleich Mindestgrenzen: etwa kontaminierte vorhergesagte Nicht-Einzelcluster geteilt durch alle vorhergesagten Nicht-Einzelcluster, fehlende Audit-Belege oder einen nicht bestandenen Löschtest. Nur Anbieter, die jede Pflichtgrenze erfüllen, werden anschließend nach den vorher festgelegten Gewichten verglichen.
Wie prüfen Menschen Grenzfälle?
Ein Anbieter darf nicht selbst festlegen, welche eigenen Grenzfälle als richtig gelten. Stellen Sie allen denselben Review-Arbeitskorb bereit und verbergen Sie nach Möglichkeit die Anbieteridentität. Zeigen Sie den Prüfern nur die zulässigen Belege. Erfassen Sie Entscheidung, Begründung, Dauer und Eskalation. Prüfer dürfen einen Fall als unentscheidbar zurückgeben, statt zu einer künstlichen Ja-oder-Nein-Antwort gedrängt zu werden.
Der US Census Bureau nennt die manuelle Prüfung als Verfahren zur Bewertung automatisierter Verknüpfungen. Der zugehörige Statistical Quality Standard C4 verlangt außerdem definierte Kriterien, Verknüpfungsparameter, Tests und reproduzierbare Dokumentation. Für einen Bank-Bake-off bedeutet das: Bewahren Sie Regeln, Schwellen, Transformationen, Softwareversionen und Adjudikationsentscheidungen zusammen mit den Resultaten auf.
Führen Sie eine zweite Review-Runde für Stichproben aus scheinbar sicheren Matches und Non-Matches durch. Sonst untersucht das Team nur die vom System selbst erkannten Unsicherheiten. Gerade selbstbewusste Fehlentscheidungen können außerhalb des Arbeitskorbs liegen und würden ohne diese Kontrollstichprobe unsichtbar bleiben.
Wie läuft der Bake-off ab?
- Entscheidung und Risiken festlegen. Benennen Sie Nutzung, Fehlerkosten, Mindestschwellen und verantwortliche Entscheider.
- Datenvertrag einfrieren. Dokumentieren Sie Quellen, Felder, Formate, zulässige Transformationen und Zugriffsregeln.
- Wahrheit labeln. Erstellen Sie Match-, Non-Match- und Unklar-Klassen mit unabhängiger Adjudikation.
- Kalibrierung erlauben. Geben Sie jedem Anbieter denselben offenen Anteil und dasselbe Zeitbudget.
- Holdout versiegeln. Führen Sie die finale Prüfung auf einem unveränderten, zuvor verborgenen Anteil aus.
- Ausgaben normalisieren. Überführen Sie Anbieterresultate in ein gemeinsames Schema für Links, Cluster, Scores und Belege.
- Blind bewerten. Berechnen Sie segmentierte Kennzahlen und lassen Sie Grenzfälle ohne Anbieterkennzeichnung prüfen.
- Entscheidung dokumentieren. Halten Sie Schwellen, Ausnahmen, Betriebskosten, offene Risiken und Vertragsbedingungen fest.
Erlauben Sie nach Testbeginn keine stillen Änderungen. Jede Regelanpassung, Datenbereinigung oder manuelle Korrektur erhält Zeitstempel, Verantwortlichen und Grund. Wenn ein Anbieter einen Fehler behebt, wird der komplette versiegelte Lauf wiederholt. Ein korrigierter Einzelfall ist kein neues Gesamtergebnis.
Wie entsteht eine belastbare Entscheidung?
Nutzen Sie zuerst Ausschlusskriterien und erst danach eine gewichtete Bewertung. Ein Anbieter, der eine vereinbarte Maximalrate kritischer False Positives überschreitet, sollte nicht durch eine schnelle Integration oder eine gute Präsentation gewinnen. Dasselbe gilt für fehlende Reproduzierbarkeit, unzureichende Zugriffskontrollen oder einen nicht prüfbaren Review-Pfad.
Bewerten Sie nach dem fachlichen Ergebnis den Weg in den Betrieb. Prüfen Sie Verantwortlichkeiten, Änderungsprozess, Monitoring, Datenexport, Exit, Support und die Fähigkeit, denselben Test nach einem Regel- oder Datenwechsel erneut auszuführen. Verknüpfen Sie jede Zusage mit einem konkreten Nachweis aus dem Bake-off oder einer offenen Due-Diligence-Aufgabe.
Der Entscheidungsausschuss sollte am Ende drei Artefakte erhalten: eine segmentierte Scorecard, ein Register der kritischen Fehlerfälle und einen Umsetzungsplan mit offenen Bedingungen. So bleibt sichtbar, warum ein Anbieter ausgewählt wurde und welche Annahmen vor Produktionsfreigabe noch bestätigt werden müssen.
Wie wird Tilores vergleichbar getestet?
Wir lösen Datensätze über deterministische, Fuzzy- und probabilistische Verfahren auf; die produktive Einreichung und Abfrage erfolgt über GraphQL. Für den Bake-off behandeln Sie uns trotzdem wie jeden anderen Teilnehmer: gleicher Datensatz, gleiche Wahrheit, gleiche Zeitgrenzen und keine Sonderwertung für produktspezifische Funktionen.
In unserem Vergleich muss deshalb sichtbar bleiben, wie deterministische Regeln, Fuzzy Matching und probabilistisches Scoring jeweils beitragen. Fuzzy Matching und probabilistisches Scoring sind getrennte Methoden. Die produktive Einreichung und Abfrage erfolgt bei uns ausschließlich über GraphQL. Eingehende Daten werden normalisiert und persistiert; die Originalwerte bleiben erhalten.
Exportieren Sie für jeden bewerteten Fall die verknüpften Datensätze, die verwendeten Belege, relevante Scores und die Konfiguration. Testen Sie anschließend, ob ein unabhängiger Prüfer denselben Fall erklären und der technische Besitzer den Lauf wiederholen kann. Mit Tilores Studio können Anwender eine lokale, auf ihrem Computer ausgeführte und gespeicherte Evaluation vornehmen. Der lokale Modus ist auf 100.000 Datensätze pro Deployment begrenzt; der verbundene Modus dient dem Betrieb und Monitoring einer Live-Entity-Resolution. Eine lokale Stichprobe ersetzt deshalb weder den Produktionsmaßstab noch die separate Prüfung der Ziel-Deployment-Grenze. Die spätere Bereitstellung ist eine eigene Beschaffungsentscheidung. Prüfen Sie die verfügbaren Modelle auf der Seite zu den Deployment-Optionen, ohne das Matching-Ergebnis mit der Hosting-Entscheidung zu vermischen.
Welche Fachbegriffe sollten alle gleich verwenden?
- Bake-off: Ein kontrollierter Vergleich mehrerer Anbieter auf derselben Aufgabe.
- Holdout: Ein versiegelter Testanteil, den Anbieter nicht zur Kalibrierung verwenden.
- Precision: Der Anteil korrekter Treffer an allen vorgeschlagenen Treffern.
- Recall: Der Anteil gefundener Treffer an allen tatsächlich vorhandenen Treffern.
- False Positive: Eine fälschlich hergestellte Verbindung zwischen verschiedenen Entitäten.
- False Negative: Eine übersehene Verbindung zwischen Datensätzen derselben Entität.
- Entity Resolution: Das Erkennen und Zusammenführen von Datensätzen, die dieselbe Person oder Organisation beschreiben.
Welche Fragen bleiben vor der Unterschrift?
Reicht ein guter F1-Wert für die Auswahl?
Nein. Prüfen Sie Precision, Recall, Clusterfehler, Segmente, Review-Last und kritische Einzelfälle getrennt. Eine kombinierte Kennzahl kann die Fehlerart verbergen, die für Ihren Bankprozess am teuersten ist.
Darf jeder Anbieter die Daten selbst bereinigen?
Nur innerhalb vorher deklarierter Regeln. Geben Sie allen dieselbe Rohbasis und protokollieren Sie jede Transformation. Sonst vergleichen Sie verschiedene Datenaufbereitungen statt verschiedener Entity-Resolution-Systeme.
Wie groß muss der Datensatz sein?
Groß genug, um häufige Fälle stabil und seltene Risikofälle gezielt zu messen. Entscheidend sind repräsentative Segmente, gelabelte Grenzfälle und ausreichend viele kritische Negative, nicht eine willkürliche Gesamtzahl.
Kann synthetische Datenbasis den Test mit echten Bankdaten ersetzen?
Nein. Synthetische Daten eignen sich zur Probe der Pipeline und für seltene konstruierte Fälle, ersetzen aber nicht die genehmigte, repräsentative Stichprobe der Bedingungen, unter denen das System später arbeiten soll.
Wem gehören die Referenzlabels?
Der Bank. Anbieter dürfen Ergebnisse erklären oder Eingabefehler melden; bankseitig benannte Prüfer legen den Referenzentscheid und die Adjudikationsregel fest, ohne sie für einen Anbieter nachträglich zu ändern.
Sollte der günstigste Anbieter gewinnen, wenn mehrere Schwellen erfüllen?
Nicht automatisch. Vergleichen Sie nach bestandenen Mindestschwellen die Gesamtkosten für Integration, Review, Tuning, Betrieb, Änderungen und Exit. Dokumentieren Sie dabei, welche Kosten gemessen und welche nur geschätzt wurden.
Welche Quellen stützen die Methode?
- Model risk management principles for banks, Supervisory Statement SS1/23, Prudential Regulation Authority.
- Agencies Issue Final Guidance on Third-Party Risk Management, Office of the Comptroller of the Currency, Federal Reserve und FDIC.
- Principle (c): Data minimisation, Information Commissioner’s Office.
- Pseudonymisation, Information Commissioner’s Office.
- How do we ensure anonymisation is effective?, Information Commissioner’s Office.
- OpenSanctions Default dataset, OpenSanctions.
- KYC & Compliance, Tilores.
- Statistical Quality Standard C4: Linking Data Records, United States Census Bureau.
- Machine Learning and Multiple Imputation for Record Linkage, United States Census Bureau.
- Tilores Studio Download, Tilores.
- Deployment Options: Run Tilores Where Your Data Is, Tilores.
- Über Tilores, Tilores.
Sehen Sie, was aufgelöste Entitätsdaten für Ihr Unternehmen — und Ihre KI — leisten.