Erkennt Entity Resolution zwei Kunden mit demselben Namen als unterschiedliche Personen? Konsistenzregeln für Banken

Kurzfassung: Eine Übereinstimmung bei Name und Adresse reicht nie aus, um zwei Bankkunden zusammenzuführen, so hoch der Wert auch ausfällt. Erst eine Konsistenzregel auf Entitätsebene, ein Feld wie das Geburtsdatum oder eine Steuer-ID, das bei jedem Datensatz übereinstimmen muss, entscheidet, ob zwei fast identische Profile dieselbe Person sind oder zwei verschiedene Personen, die sich nur ähnlich sehen.
Demo buchen, um ein Szenario mit gleichem Namen gegen Ihre eigenen Konsistenzregeln zu testen, oder Tilores Studio kostenlos testen, um die Prüfung mit eigenen Daten auszuführen.
Auf dieser Seite
- Was lässt zwei Bankdatensätze wie denselben Kunden aussehen?
- Warum reicht ein hoher Match Score nicht aus?
- Was ist eine Konsistenzregel, und wie verhindert sie eine falsche Zusammenführung?
- Wie unterscheidet sich das Verhindern einer falschen Zusammenführung von der Erklärung einer bereits erfolgten?
- Wo passt Tilores hier hinein?
- Erkennt Ihre Matching-Konfiguration diese beiden Kunden als unterschiedlich?
- FAQ
- Quellen
In der Onboarding-Warteschlange einer Bank liegen zwei Anträge aus derselben Woche. Gleicher Vor- und Nachname, gleiche Postleitzahl, Adressen nah genug, um dasselbe Gebäude zu sein. Eine Matching-Konfiguration, die Duplikate erkennen soll, würde dieses Paar als offensichtliche Verknüpfung durchlassen.
Nur sind es möglicherweise nicht dieselbe Person. Es könnte sich um ein Elternteil und ein erwachsenes Kind an derselben Adresse handeln, oder um zwei fremde Kunden, die sich einen gewöhnlichen Namen und eine Straße teilen. Eine Bank, die beide allein wegen Name und Adresse zusammenführt, erhält ein Profil mit den Kontoständen, Bonitätshistorien und Risikobildern zweier Personen, und niemand merkt es, bis ein Kontoauszug, eine Kreditentscheidung oder ein Sanktionstreffer bei der falschen Person landet.
Die Frage, die für eine Bank bei der Bewertung von Entity-Resolution-Software zählt, ist nicht, wie hoch der Ähnlichkeitswert ausfiel. Es ist, welche konkrete Regel, wenn überhaupt eine, verhindert hat, dass das System zwei verschiedene Personen zusammenführt, die auf dem Papier wie eine fast perfekte Übereinstimmung aussahen.
Was lässt zwei Bankdatensätze wie denselben Kunden aussehen?
Zwei Quelldatensätze wirken wie eine Person, wenn genug Felder übereinstimmen: ein Name, der ganz oder fast ganz übereinstimmt, eine Adresse, die identisch oder nur eine kurze Strecke entfernt ist, ein Datum in einem anderen Format, sich überschneidende Kontaktdaten. Keines dieser Signale beweist für sich allein eine Identität. Jedes ist ein Nachweis, und Nachweise müssen gegeneinander abgewogen werden, nicht einfach addiert.
Die britische Joint Money Laundering Steering Group macht denselben Punkt für Banken ganz unmittelbar: Die Wohnadresse eines Kunden ist zentral, um von dessen Identität überzeugt zu sein, besonders bei Kunden mit gebräuchlicheren Namen, weil ein Name und ein Geburtsdatum nur zwei von mehreren abzuwägenden Aspekten sind.
Wir halten drei Matching-Methoden in jeder Konfiguration getrennt, weil sie unter einer Bezeichnung zusammenzufassen verschleiert, wie viel Sicherheit ein Ergebnis tatsächlich trägt.
| Methode | Was sie prüft | Was sie liefert |
|---|---|---|
| Deterministisch | Exakte Übereinstimmung bei einem kontrollierten Wert, etwa einer Steuer-ID oder Kontonummer | Ein festes Ja-oder-Nein-Ergebnis ohne Unschärfe |
| Fuzzy | Werte, die in ihrer Form legitim variieren können: phonetische Ähnlichkeit, Levenshtein-Distanz für Tippfehler, Kosinus-Ähnlichkeit für Token-Überlappung, geografische Distanz zwischen Koordinaten, zeitliche Distanz zwischen Datumsangaben | Ein Näherungsmaß zwischen zwei Werten, keine Bestätigung, dass sie identisch sind |
| Probabilistisch | Ein auf Beispieldaten trainiertes statistisches Modell, das das kombinierte Gewicht mehrerer Teilsignale bewertet | Einen Ähnlichkeitswert, der einen konfigurierten Schwellenwert überschreiten muss, bevor zwei Datensätze als Kandidatenpaar gelten |
Fellegi und Sunter beschrieben in ihrer grundlegenden Arbeit von 1969 zum Record Linkage die Verknüpfung zweier Datensätze als eine Entscheidung nach einem Likelihood-Verhältnis zwischen der Hypothese, dass sie übereinstimmen, und der Hypothese, dass sie es nicht tun, nicht als eine einmal angewandte feste Regel. Ein hoher Ähnlichkeitswert erhöht diese Wahrscheinlichkeit. Er entscheidet sie nicht, weil derselbe Wert ein echtes Duplikat mit unsauberen Daten beschreiben kann oder zwei verschiedene Personen, die zufällig einen Namen, eine Adresse und einige übereinstimmende Details teilen.
Warum reicht ein hoher Match Score nicht aus?
Außerhalb des Bankwesens hat eine Aufsichtsbehörde dieses genaue Fehlverhalten bereits unter einem anderen Namen entschieden. Das Advisory Opinion der US-Behörde CFPB vom November 2021 zum reinen Namensabgleich kommt zu dem Schluss, dass der Abgleich eines Verbraucherdatensatzes mit einer Person allein anhand von Vor- und Nachname keine angemessene Methode ist, um größtmögliche Genauigkeit zu gewährleisten, weil eine bestimmte Namenskombination von Tausenden von Menschen geteilt werden kann. Eine Bank, die Entity-Resolution-Software bewertet, trägt dasselbe Risiko, sobald eine Konfiguration sich allein auf Name und Adresse stützt, wie auch immer der Anbieter diesen Schritt nennt.
Sanktions- und Watchlist-Screening trifft auf dieselbe Unschärfe unter einem anderen Namen. Die Leitlinie der Wolfsberg Group zum Sanctions Screening bezeichnet die Entscheidung über eine echte Übereinstimmung als komplex, sobald Alphabete, Sprachen, Kulturen, Schreibweisen, Abkürzungen, Akronyme und Aliase ins Spiel kommen, weshalb sich ein Screening oder eine Matching-Konfiguration nicht allein auf den Namen stützen kann.
PEP-Prüfungen und Adverse-Media-Screening erben dasselbe Problem. Die PEP-Leitlinie der Wolfsberg Group verlangt von Banken, PEP-Kunden auf negative Presseberichte und Adverse Media zu prüfen und jeden Treffer zu bewerten, und jeder dieser Treffer ist ein Namensabgleich, den jemand bestätigen oder verwerfen muss. Auch die Listen bewegen sich: OpenSanctions aktualisiert Sanktionslisten alle 4 bis 12 Stunden und PEP- sowie regulatorische Watchlists täglich oder wöchentlich, daher muss eine einmal getroffene Entscheidung über denselben Namen auch dann halten, wenn sich die Daten darunter ändern.
Die übliche Praxis beim Record Linkage beschreibt eine ehrliche Zwischenstufe statt eines einzigen Grenzwerts. Eine Klassifizierung mit zwei Schwellenwerten stuft sichere Verknüpfungen oberhalb des oberen Schwellenwerts ein, sichere Nicht-Übereinstimmungen unterhalb des unteren, und hält alles dazwischen für eine menschliche Entscheidung zurück. Unsere Regel-Engine baut diese Zwischenstufe direkt ein. Nehmen Sie ein Konfigurationsmuster, das uns häufig begegnet: Ein Kandidatenpaar erreicht einen Wert von 0,71, unterhalb eines Schwellenwerts von 0,85 für die automatische Zusammenführung und oberhalb eines Schwellenwerts von 0,55 für die automatische Ablehnung. Nachname und Adresse stimmen nach der Normalisierung überein. Das Geburtsdatum fehlt bei einem der Datensätze, sodass die Konsistenzregel das Paar weder bestätigen noch blockieren kann, und die E-Mail-Adressen der beiden Datensätze liegen elf Jahre auseinander. Diese Kombination gehört vor eine prüfende Person und nicht in eine automatische Zusammenführung, und wie auch immer die Entscheidung ausfällt, sie wird protokolliert und ist umkehrbar.
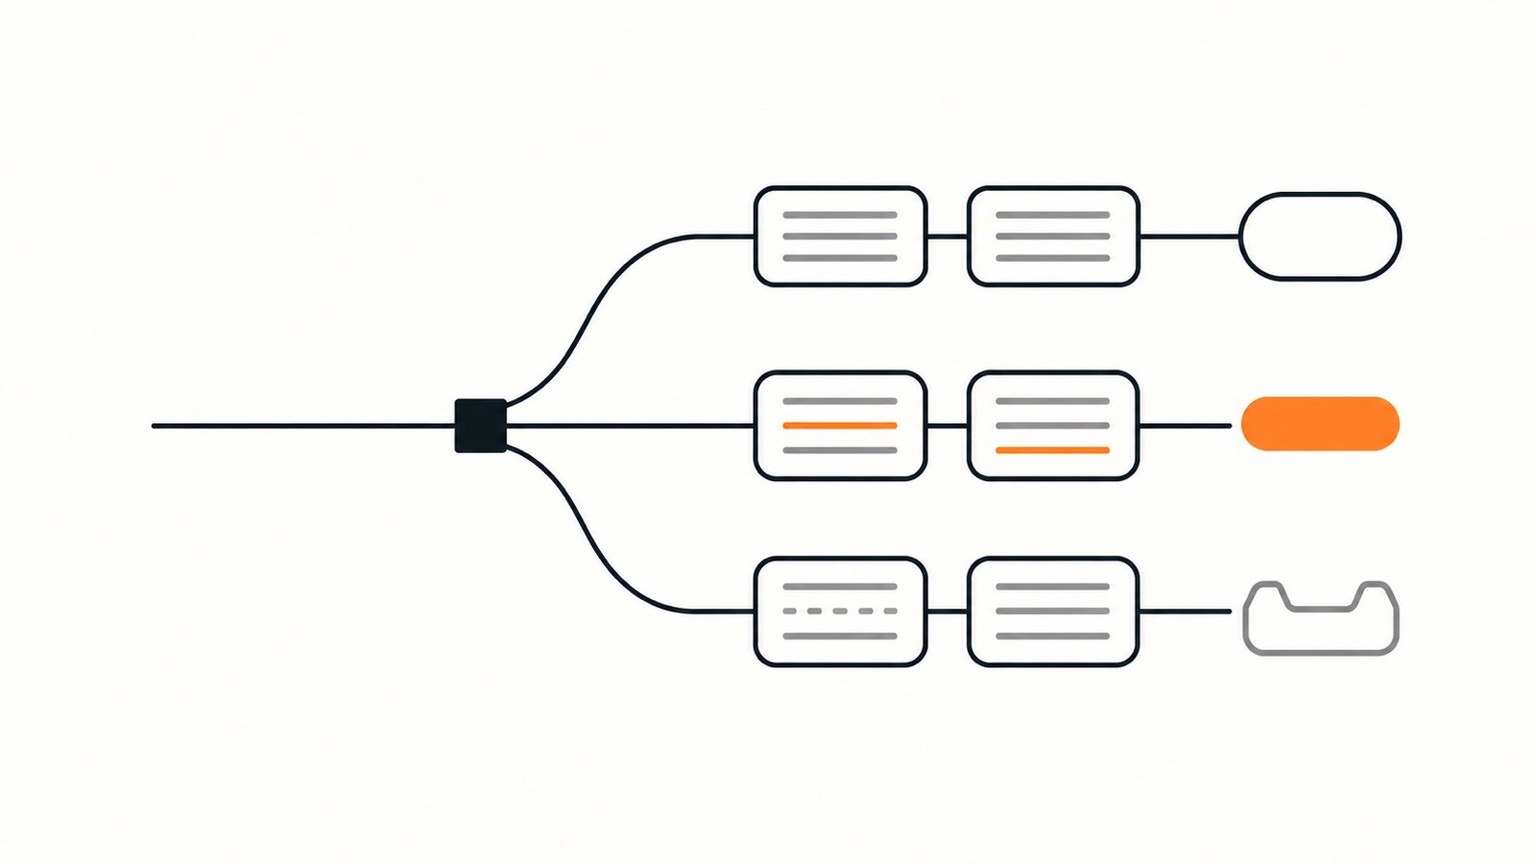
Ein echtes Duplikat wird zusammengeführt, ein Paar mit gleichem Namen wird durch einen Konflikt beim Geburtsdatum blockiert, und ein unvollständiges Paar geht zur Prüfung an eine prüfende Person.
Hier einen Fehler zu machen ist keine bloße Unannehmlichkeit bei der Datenqualität. Werden zwei verschiedene Kunden zusammengeführt, landen Kontostand, Adresshistorie und Risikomerkmale der einen Person im Profil einer anderen, was nach der Definition der britischen Datenschutzbehörde ICO eine unbefugte Offenlegung personenbezogener Daten an die falsche Partei und damit eine Verletzung des Schutzes personenbezogener Daten ist: eine Verletzung der Sicherheit, die zur unbeabsichtigten oder unrechtmäßigen Vernichtung, zum Verlust, zur Veränderung, zur unbefugten Offenlegung von oder zum unbefugten Zugang zu personenbezogenen Daten führt. Der Grundsatz der Richtigkeit in der DSGVO besteht aus demselben Grund: personenbezogene Daten müssen sachlich richtig und auf dem neuesten Stand sein, und unrichtige Daten müssen unverzüglich gelöscht oder berichtigt werden. Eine falsche Zusammenführung verstößt gegen diesen Grundsatz für beide Kunden zugleich, nicht nur für die Person, die es als Erste merkt, so kurz sie auch Bestand hat.
Neue Beiträge zu Entity Resolution, Identitätsdaten und KI. Kein Spam, Abmeldung jederzeit möglich.
Was ist eine Konsistenzregel, und wie verhindert sie eine falsche Zusammenführung?
Eine Matching-Regel fragt, ob zwei bestimmte Datensätze eng genug übereinstimmen, um verknüpft zu werden. Eine Konsistenzregel stellt eine andere Frage: Stimmt der neue Datensatz mit jedem Datensatz überein, der bereits zur Kandidaten-Entität gehört, bei einem Feld, das niemals im Widerspruch stehen darf? Unsere Konsistenzregeln prüfen den eingehenden Datensatz gegen jeden Datensatz, der bereits zu der Entität gehört, der er sich anschließen würde, nicht nur gegen den nächstliegenden. Widerspricht auch nur einer dieser Datensätze beim kontrollierten Feld, wird die gesamte Entität ausgeschlossen, so stark die Übereinstimmung bei Name oder Adresse an anderer Stelle auch aussieht. Würde ein Datensatz zwei Entitäten erfüllen, die sich bei diesem Feld widersprechen, schließt er sich der älteren Entität an, statt beide zusammenzuführen.
Für eine Bank ist das naheliegende Feld für diese Invariante eines, das sich ein Haushalt selten vollständig teilt: das Geburtsdatum oder eine staatliche Steuer-ID. Nehmen Sie die eigene Kundenakte einer Bank. Andreas Müller beantragte 2015 eine Karte, Musterstraße 12 in Frankfurt, geboren am 22.06.1979. Sein Datensatz im alten Kernbankensystem, “Andreas Mueller”, trägt dieselbe Adresse, jedoch kein Geburtsdatum. Ein Antrag von 2026 von “A. Müller-Schmidt” an einer neuen Adresse in Offenbach, seinem Namen nach der Heirat, trägt weiterhin das übereinstimmende Geburtsdatum 22.06.1979. Alle drei gehören zu demselben Kunden. Andrea Müller, ein Haushaltsmitglied an der ursprünglichen Frankfurter Adresse, geboren am 04.11.1983, teilt 92 Prozent der Namenszeichenfolge und dieselbe Adresse mit diesen drei Datensätzen. Ohne Konsistenzregel würde diese Übereinstimmung allein die meisten Matching-Konfigurationen passieren. Die Konsistenzregel zum Geburtsdatum widerspricht, und dieser einzelne Widerspruch übertrumpft jeden anderen Nachweis in diesem Fall.
Dieses Muster ist kein auf das Bankwesen beschränkter Einzelfall. Eine 2022 im Journal of the American Medical Informatics Association veröffentlichte, peer-reviewte Untersuchung von Patienten-Matching-Methoden fand denselben Fehlertyp bei Gesundheitsdaten: Familienmitglieder mit ähnlichen Namen und übereinstimmenden demografischen Daten sind eine bekannte Quelle falsch-positiver Übereinstimmungen, die sich nur durch zusätzliche Referenzdaten auflösen lässt.
- Schritt 1: Eine Matching-Regel schlägt eine Kandidatenverknüpfung vor. Ein neuer Datensatz erreicht bei Name, Adresse oder einem anderen Fuzzy- oder probabilistischen Maß einen so hohen Wert, dass er als Übereinstimmung mit einer bestehenden Entität vorgeschlagen wird.
- Schritt 2: Die Konsistenzregel liest das kontrollierte Feld überall, wo es vorkommt. Sie prüft das Geburtsdatum des vorgeschlagenen Datensatzes, oder welches Feld die Bank konfiguriert hat, gegen dasselbe Feld bei jedem Datensatz, der bereits zur Kandidaten-Entität gehört, nicht nur beim nächstliegenden.
- Schritt 3: Ein einziger Widerspruch schließt die gesamte Entität aus. Widerspricht der eingehende Datensatz auch nur einem bestehenden Datensatz bei diesem Feld, wird die Entität als Kandidat ausgeschlossen, unabhängig davon, wie hoch der Match Score ausfiel.
- Schritt 4: Ein echter Konflikt zwischen zwei Entitäten löst sich zugunsten der älteren. Würde der eingehende Datensatz sonst für zwei Entitäten gelten, die sich beim kontrollierten Feld widersprechen, schließt er sich der älteren Entität an, und die Regel, die das entschieden hat, wird auf der Verbindung selbst vermerkt.
Jede entstehende Verbindung in unserem Graphen wird als recordA:recordB:RULE_ID gespeichert, sodass eine prüfende Person sehen kann, welche konkrete Regel eine Verknüpfung erzeugt hat, nicht nur, wie sicher sich das System fühlte. Eine Regeländerung wird versioniert, und eine falsch gebildete Verbindung lässt sich über unsere Disassembly-Operation entfernen, die auch eine Sperre setzen kann, die verhindert, dass dieselben beiden Datensätze versehentlich erneut verbunden werden.
Wie unterscheidet sich das Verhindern einer falschen Zusammenführung von der Erklärung einer bereits erfolgten?
Eine andere Frage, die es wert ist, davon getrennt zu halten, ist, wie eine prüfende Person eine bereits erfolgte Zusammenführung rekonstruiert und begründet: die Datenherkunft, die Normalisierungshistorie und die menschliche Entscheidung hinter einer Entität, auf die sich eine Bank inzwischen verlässt. Das ist eine Audit-Frage, und sie setzt voraus, dass die Zusammenführung von Anfang an richtig gebildet wurde.
Die Kalibrierung von Konfidenzstufen für einen wirklich unklaren Fall ist eine verwandte, aber eigenständige Frage. Unser Artikel zu Konfidenzwerten, Match-Schwellenwerten und Audit-Trails beschreibt, wie eine Bank ihre eigenen Stufen für automatische Verknüpfung, Überprüfung und automatische Ablehnung festlegt, statt die Standardwerte eines Anbieters zu übernehmen.
Eine Konsistenzregel steht beiden Fragen vorgeschaltet. Sie entscheidet, ob zwei Datensätze überhaupt als Kandidat für eine Zusammenführung gelten dürfen, bevor überhaupt ein Score berechnet wird. Die Invariante richtig zu wählen, entfernt eine ganze Kategorie falscher Zusammenführungen aus dem Prozess, statt sich darauf zu verlassen, dass eine prüfende Person den Fehler erst nach einer bereits getroffenen Fehlentscheidung bemerkt.
Wo passt Tilores hier hinein?
Wir behandeln eine Konsistenzregel als festen, abfragbaren Bestandteil des Entitätsgraphen, nicht als nachträglich aufgesetzten Filter auf einem separaten Matching-Schritt. Entitäten sind Graphen; jede Kante hält die Regel fest, die sie erzeugt hat; Konsistenzregeln laufen, bevor eine Übereinstimmung entsteht, nicht danach; und Zusammenführen, Trennen und Aufspalten sind feste Operationen, die wir unterstützen, falls eine Bank eine Entscheidung später korrigieren muss.
| Option | Wie sie das Problem gleicher Namen behandelt | Wo sie an ihre Grenzen stößt |
|---|---|---|
| Eine vollständige MDM-Suite | Konsistenz und Matching liegen innerhalb eines deutlich größeren Stammdatenprogramms | Meist für ein großes Gesamtprogramm dimensioniert und bepreist, sodass viele Banken sie als ersten Anlaufpunkt betrachten und danach eine schlankere, fokussierte Option suchen |
| Die Prüfung auf einer bestehenden Datenplattform selbst bauen | Ein Team codiert intern ein Ähnlichkeitsmodell und eine Regel zum Feldvergleich | Die Invariante muss von der Bank gebaut, getestet und gepflegt werden, und ein rein probabilistisches Ergebnis lässt sich bei einer DSGVO-Auskunftsanfrage schwerer erklären als eine benannte Regel |
| Nur Name- und Adressabgleich, ohne Konsistenzprüfung | Am einfachsten zu konfigurieren und am schnellsten einsatzbereit | Genau das Muster, das die US-Behörde CFPB bereits als unzureichend für die Genauigkeit eingestuft hat; es lässt eine 92-prozentige Namensübereinstimmung ungeprüft durch |
| Eine Matching-Engine mit Konsistenzregeln als Eigenschaft des Graphen (unser Ansatz) | Die Invariante läuft, bevor eine Übereinstimmung entsteht, und eine benannte Regel, nicht allein die Zuversicht eines Modells, blockiert eine falsche Zusammenführung | Die Bank muss weiterhin das richtige kontrollierte Feld wählen und die Fälle in der Prüfwarteschlange durchsehen, die eine Konfiguration allein nicht lösen kann |
Braucht eine Bank nur eine einmalige Bereinigung einer Altdatei, ohne anschließenden laufenden Matching-Bedarf, kann ein zeitlich begrenztes Projekt mit einer Datenqualitätsberatung oder ein internes Einmalskript die verhältnismäßigere Wahl gegenüber der Lizenzierung einer dauerhaften Matching-Engine sein. Der Fall für eine Engine wird stärker, sobald laufend neue Datensätze eintreffen und dieselbe Frage jeden Tag erneut beantwortet werden muss, nicht nur einmal.
Demo buchen, um eine Konsistenzregel an einem Fall wie oben durchzugehen, oder Tilores Studio kostenlos testen, um eine an Ihren eigenen Beispieldaten zu konfigurieren.
Erkennt Ihre Matching-Konfiguration diese beiden Kunden als unterschiedlich?
Bevor Sie der Zusammenführungsentscheidung eines Anbieters bei einem Fall mit gleichem Namen vertrauen, prüfen Sie vier Dinge: eine benannte Konsistenzregel bei einem Feld, das die beiden Kunden wahrscheinlich nicht teilen, eine sichtbare mittlere Stufe, die unklare Fälle an eine Person weiterleitet statt sie automatisch zusammenzuführen, eine Aufzeichnung, welche konkrete Regel jede Verknüpfung erzeugt hat statt nur einen Score, und einen getesteten Weg, eine Zusammenführung zu trennen und eine erneute Verbindung zu sperren, falls sie sich als falsch erweist.
Demo buchen, um ein Szenario mit gleichem Namen an Ihren eigenen Daten durchzuspielen, oder Tilores Studio kostenlos testen, um selbst eine Konsistenzregel zu konfigurieren.
FAQ
Bedeutet eine 92-prozentige Namensübereinstimmung, dass zwei Bankkunden dieselbe Person sind?
Nein. Eine Übereinstimmung bei Name und Adresse, so hoch der Wert auch ausfällt, ist ein Hinweis auf eine mögliche Übereinstimmung, kein Beweis. Eine Konsistenzregel bei einem Feld wie dem Geburtsdatum oder einer Steuer-ID kann die Zusammenführung weiterhin blockieren, wenn dieses Feld widerspricht.
Was ist eine Konsistenzregel bei Entity Resolution?
Eine Konsistenzregel ist eine Prüfung auf Entitätsebene: Sie vergleicht ein kontrolliertes Feld eines eingehenden Datensatzes mit demselben Feld bei jedem Datensatz, der bereits zur Kandidaten-Entität gehört, und schließt die Entität aus, wenn auch nur einer dieser Datensätze widerspricht.
Welche Felder eignen sich am besten als Konsistenzregel im Bankwesen?
Geburtsdatum und eine staatliche Steuer-ID eignen sich gut, weil sie sich selten ändern und selten zufällig zwischen zwei verschiedenen Personen übereinstimmen, selbst innerhalb desselben Haushalts oder an derselben Adresse.
Was passiert, wenn das Konsistenzfeld eines Datensatzes fehlt?
Die Regel kann das Paar dann weder bestätigen noch blockieren. Ein Fall mit fehlendem Feld und einem Match Score im mittleren Bereich sollte deshalb an eine prüfende Person gehen, für eine protokollierte, umkehrbare Entscheidung statt einer automatischen Zusammenführung.
Kann ein Mensch noch eingreifen, bevor zwei Datensätze zusammengeführt werden?
Ja. Oberhalb und unterhalb einer mittleren Prüfstufe liegen Stufen für die automatische Zusammenführung und die automatische Ablehnung, und jeder Fall innerhalb dieser mittleren Stufe, wie auch jede bereits abgeschlossene Zusammenführung, die sich später als falsch herausstellt, lässt sich über eine Trennoperation mit einer Sperre gegen erneutes Verbinden korrigieren.
Quellen
- Consistency, Tilores
- Matcher Reference, Tilores
- API Reference, Tilores
- Deployment, Tilores
- Data Privacy Compliance, Tilores
- Erklärbare Entity Resolution: Konfidenzwerte, Match-Schwellen und Audit-Trails (2026), Tilores
- AML und KYC mit Entity Resolution in Echtzeit, Tilores
- A Theory for Record Linkage, Ivan P. Fellegi and Alan B. Sunter, Journal of the American Statistical Association, 1969
- Data Matching: Concepts and Techniques for Record Linkage, Entity Resolution, and Duplicate Detection, Peter Christen, Springer, 2012
- Fair Credit Reporting; Name-Only Matching Procedures, Consumer Financial Protection Bureau, 2021
- Personal Data Breaches: A Guide, Information Commissioner’s Office
- UK GDPR, Article 5, Principles Relating to Processing of Personal Data
- Wolfsberg Guidance on Politically Exposed Persons (PEPs), The Wolfsberg Group
- Downloading the Data and Keeping It Fresh, OpenSanctions
- Prevention of Money Laundering / Combating Terrorist Financing, Part I, Paragraph 5.3.29, Joint Money Laundering Steering Group, 2023
- Wolfsberg Guidance on Sanctions Screening, The Wolfsberg Group, 2019
- Evaluation of Real-World Referential and Probabilistic Patient Matching to Advance Patient Identification Strategy, Grannis et al., Journal of the American Medical Informatics Association, 2022
- One Woman Spent Seven Years Fighting Another Person’s Debt on Her Credit Report, Schmitdy Gadget, YouTube, 2026
Sehen Sie, was aufgelöste Entitätsdaten für Ihr Unternehmen — und Ihre KI — leisten.