So bauen Sie 2026 einen Ground-Truth-Datensatz für Entity Resolution auf

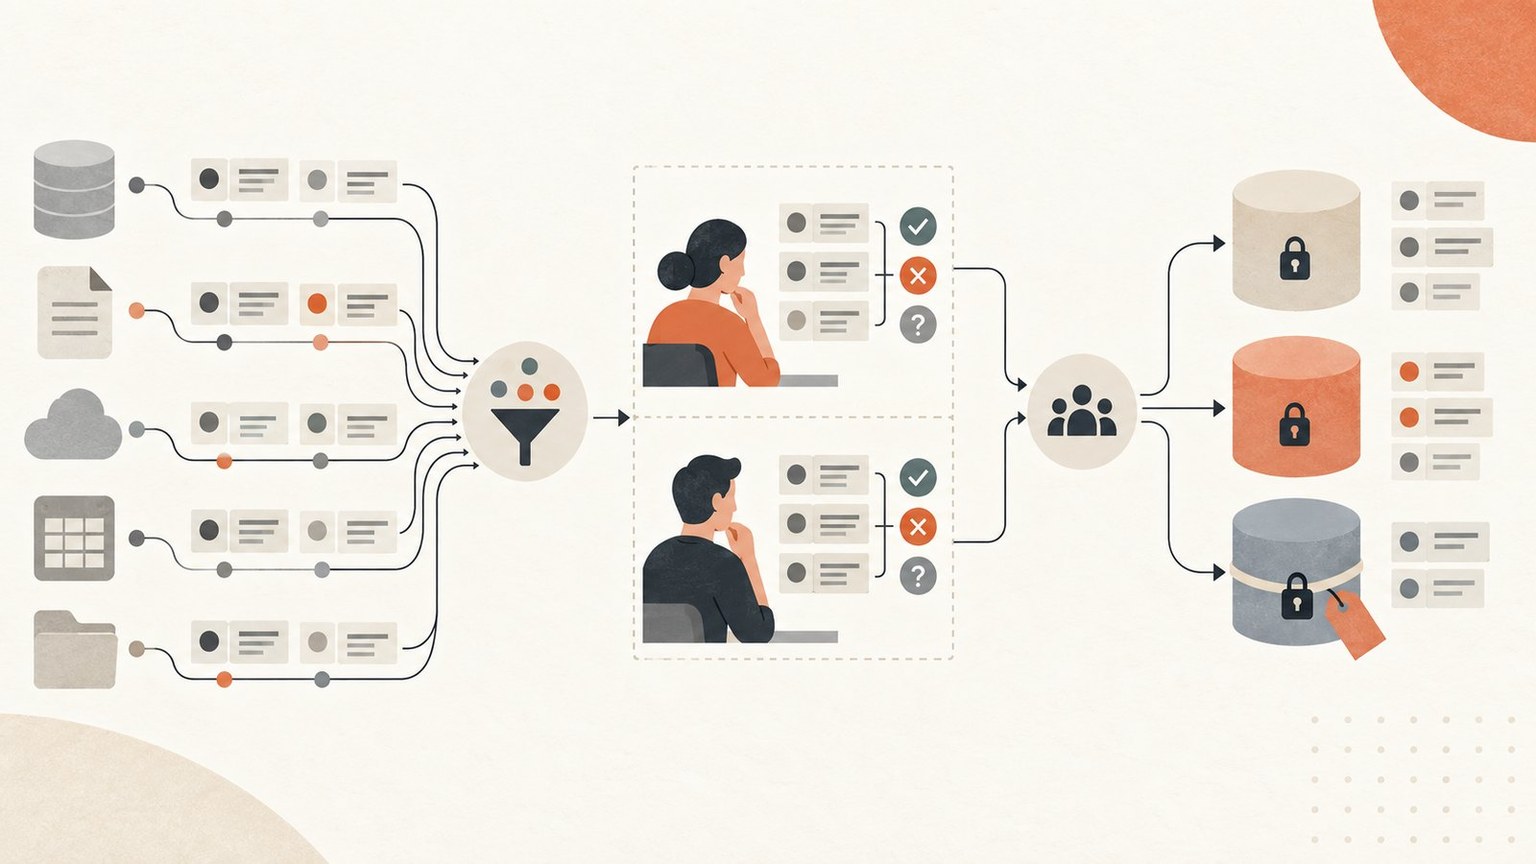
Kurzfassung: Ground Truth entsteht aus dem realen Quellenmix, gezielt ausgewählten Grenzfällen und klaren Kontrollen. Definieren Sie eine dreistufige Label-Richtlinie, lassen Sie unabhängig labeln, entscheiden Sie Uneinigkeit per Adjudikation, bewahren Sie Provenienz und sperren Sie eine unangetastete Testpartition. Messen Sie Paar- und Entitätsergebnisse nach Quelle und Risikosegment. Neue Fälle kommen versioniert hinzu, ohne historische Labels an das neueste Modell anzupassen.
Prüfen Sie Ihre Matching-Konfiguration mit einem kontrollierten Datenausschnitt. Demo buchen · Tilores Studio kostenlos testen.
Auf dieser Seite
- Was gilt bei Entity Resolution als Ground Truth?
- Wie folgen Stichproben den Entscheidungen statt der Bequemlichkeit?
- Aus Urteil wird ein reproduzierbares Label
- Aufbau in sieben kontrollierten Schritten
- Fehler messen, die fachlich spürbar sind
- Wie bleibt Ground Truth unabhängig vom aktuellen Matcher?
- Wie verbinden wir gelabelte Wahrheit mit Tilores Regeln?
- Häufige Fragen
- Quellen
Was gilt bei Entity Resolution als Ground Truth?
Ground Truth ist ein versionierter Satz von Identitätsentscheidungen mit genügend Evidenz für jedes Label. Auf Paarebene lauten die Klassen gewöhnlich Match, Non-Match und ungelöst. Auf Entitätsebene beschreibt der Datensatz außerdem, welche Records zusammengehören und welche getrennt bleiben müssen. Die ungelöste Klasse ist unverzichtbar. Wenn die Evidenz zwei Personen oder Organisationen nicht unterscheiden kann, erzeugt ein erzwungenes Label nur falsche Gewissheit.
Der Datensatz repräsentiert Population und Entscheidungen des späteren Systems. Eine saubere Stichprobe exakter Kennungsübereinstimmungen ist eine gute Kontrolle, sagt aber wenig über Transliteration, häufige Namen, Haushaltsadressen, veraltete Kontaktdaten oder widersprüchliche IDs. Ein Datensatz nur aus der heutigen Review Queue überbetont dagegen Mehrdeutigkeit, weil das aktuelle System diese Fälle bereits ausgewählt hat. Deshalb werden mehrere Stichprobenrahmen mit dokumentiertem Zweck kombiniert.
Die britische Regierung betont in ihrer Guidance zur Linkage-Qualität, dass sowohl falsche Matches als auch übersehene Matches zählen und die Bewertung von verfügbarer Referenzinformation abhängt. Ein einfacher Accuracy-Wert ist daher irreführend. Viele leichte Non-Matches können ein schwaches System gut aussehen lassen, während seltene, folgenreiche False Merges im Durchschnitt verschwinden.
Wie folgen Stichproben den Entscheidungen statt der Bequemlichkeit?
Beginnen Sie mit einem Inventar aus Quellen, Zeiträumen, Sprachen, Record-Typen, Missingness-Mustern und nachgelagerten Entscheidungen. Eine Zufallsstichprobe schätzt gewöhnliche Leistung. Ergänzen Sie geschichtete Stichproben für seltene, wichtige Bedingungen wie doppelte Kennungen, gemeinsame Adressen, quellspezifische Kürzungen und Fälle nahe aktueller Schwellenwerte. Der Auswahlgrund bleibt am Fall, damit später gewichtete Kennzahlen möglich sind.
Nehmen Sie Kandidatenpaare und Tests auf übersehene Kandidaten auf. Wer nur zurückgelieferte Paare prüft, erkennt keine Personen, die die Blocking-Strategie nie zusammengebracht hat. Bekannte Cluster, Quellenbeziehungen und kontrollierte Varianten prüfen die Candidate Recall. Synthetische Veränderungen diagnostizieren einzelne Transformationen, ersetzen für Produktionsschätzungen aber keine realen Beispiele mit ihrer korrelierten Missingness.
Verhindern Sie Leakage zwischen Partitionen. Tauchen Records derselben realen Entität in Training und Test auf, kann ein Modell die konkrete Identität statt des allgemeinen Musters lernen. Teilen Sie nach Entität, Quellgruppe oder Zeitgrenze. Die Testpartition wird vor der Schwellenwertwahl eingefroren. Ein zeitlicher Holdout zeigt, ob die Leistung auch für neue Records und wechselnde Quellenqualität trägt.
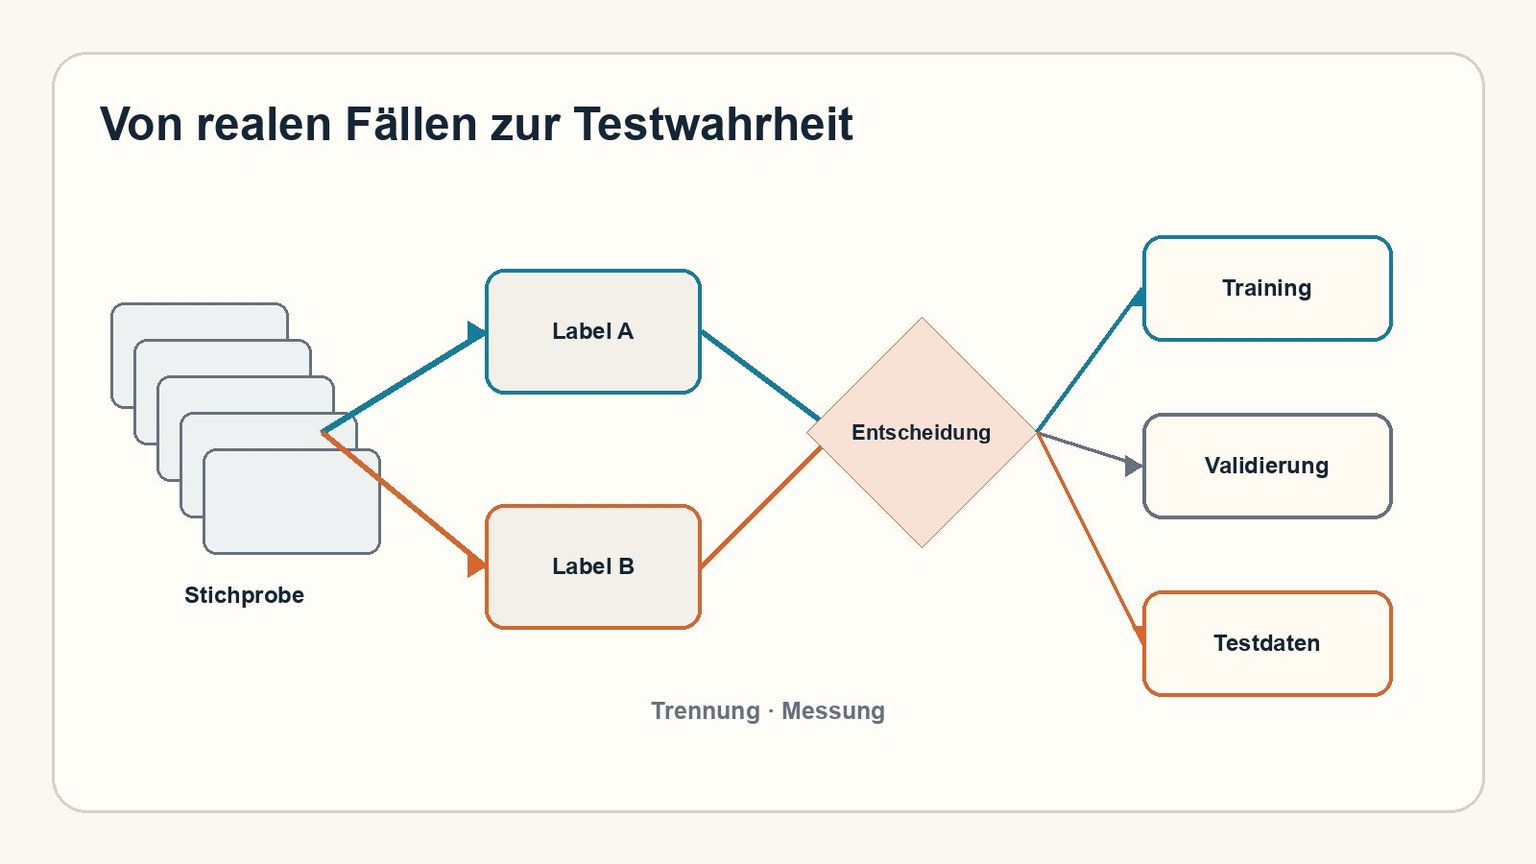
Ground Truth entsteht durch Stichprobe, unabhängiges Urteil, Adjudikation und geschützte Evaluation, nicht durch das Kopieren von Modellergebnissen.
Neue Beiträge zu Entity Resolution, Identitätsdaten und KI. Kein Spam, Abmeldung jederzeit möglich.
Aus Urteil wird ein reproduzierbares Label
Ein Label-Handbuch entsteht vor der Skalierung. Es definiert Match für den konkreten Anwendungsfall, zulässige Evidenz, den Umgang mit Konflikten und den ungelösten Ausgang. Grenzfälle sind wichtiger als nur offensichtliche Beispiele. Kundenkonto, natürliche Person und Haushalt sind verschiedene Entitätsdefinitionen. Ohne die Zieldefinition hat das Label keine eindeutige Bedeutung.
Schwierige Schichten benötigen mindestens zwei unabhängige Urteile. Prüfer sehen weder die Erstentscheidung der anderen Person noch das bevorzugte Modellergebnis. Eine Adjudikation löst Uneinigkeit mit derselben Evidenzrichtlinie und hält die Begründung fest. Hohe Übereinstimmung beweist nicht automatisch Richtigkeit, wenn beide Prüfer denselben fehlenden Kontext oder Bias teilen.
Personenbezogene und sensible Daten bleiben während des gesamten Prozesses geschützt. Angezeigt werden nur Attribute, die für den Label-Zweck zulässig sind. Zugriff und verfügbare Evidenzversion werden protokolliert. Redaction kann einen Fall erschweren und muss dokumentiert sein. So lässt sich später ein falsches Label von einem vertretbaren Urteil mit begrenzter Evidenz unterscheiden.
Aufbau in sieben kontrollierten Schritten
- Entitätsdefinition schreiben. Legen Sie fest, ob Person, Organisation, Konto, Haushalt oder ein anderes Objekt aufgelöst wird. Benennen Sie die Downstream-Entscheidung und die wichtigsten Fehlerarten.
- Population inventarisieren. Erfassen Sie Quelle, Zeitraum, Sprache, Schemaversion, Missingness und bekannte Qualitätsereignisse. Wichtige Segmente erhalten getrennte Messung statt eines Mischwerts.
- Stichprobenrahmen kombinieren. Nutzen Sie repräsentative Zufallsfälle, risikobasierte Schichten, aktuelle Grenzfälle und Proben auf übersehene Kandidaten. Bewahren Sie Auswahlwahrscheinlichkeiten für Aggregationen.
- Evidenzpakete vorbereiten. Zeigen Sie Original- und Normalisierungswerte, Quellenprovenienz und zulässigen Kontext, aber nicht die Modellprognose. Jeder Fall bekommt eine dauerhafte ID.
- Unabhängig labeln und adjudizieren. Verwenden Sie Match, Non-Match und ungelöst. Erstlabels, Uneinigkeit und finale Begründung bleiben erhalten. Richtlinienlücken werden eskaliert und nicht intuitiv gefüllt.
- Vor dem Tuning partitionieren. Trennen Sie Training, Validation und Holdout nach Entität und bei Bedarf nach Zeit. Hashes und Versionen schützen die Aufteilung. Schwierige Fehler wechseln nicht still vom Test ins Training.
- Dataset Record veröffentlichen. Dokumentieren Sie Zweck, Zusammensetzung, Erhebung, Verarbeitung, zulässige Nutzung, Grenzen und Pflege. Ein Change Log und benannte Verantwortung halten den Datensatz lebendig.
Fehler messen, die fachlich spürbar sind
Precision und Recall für Links sind nötig, aber nicht ausreichend. Ergänzen Sie False Merges, übersehene Links, ungeklärte Abdeckung, Candidate Recall und Kennzahlen auf Entitätsebene. Ergebnisse werden nach Quelle, Sprache, Datenvollständigkeit und Entscheidungsrisiko segmentiert. Konfidenzintervalle oder Stichprobengrößen verhindern Scheingenauigkeit in kleinen Hochrisikogruppen.
Auch der Betrieb wird evaluiert: Uneinigkeit der Prüfer, Gründe der Adjudikation, Zeit bis zur Entscheidung und spätere Label-Reversals. Ein Modell kann stabil wirken, während sich die menschliche Richtlinie verändert. Umgekehrt kann sinkende Precision von einer neuen Quelle mit schwierigeren Fällen stammen. Quellen- und Zeitmetadaten trennen diese Erklärungen.
Der Testdatensatz ist ein endliches Messinstrument und keine ewige Wahrheit. Neue Fehlermuster kommen in einer kontrollierten Version hinzu, während die alte Ausgabe vergleichbar bleibt. Ändert sich autoritative Evidenz, darf ein Label korrigiert werden. Originalentscheidung, Korrekturgrund und Wirksamkeitsversion bleiben gemeinsam erhalten.
| Kennzahl | Sichtbarer Fehler | Erforderliche Aufteilung |
|---|---|---|
| Link Precision | False Merges unter akzeptierten Links. | Quelle, Sprache und Folge. |
| Link Recall | Übersehene wahre Beziehungen. | Kandidatensuche und Matcher getrennt. |
| Ungelöste Abdeckung | Fälle ohne sicher tragfähige Antwort. | Reason Code und Entscheidungsworkflow. |
| Entity-Topologie | Überkombinierte oder fragmentierte Cluster. | Clustergröße und folgenreiche Entitätsklasse. |
Wie bleibt Ground Truth unabhängig vom aktuellen Matcher?
Speichern Sie Stichprobengrund, Quellenmix, ursprüngliche Werte und Kandidatenpfad mit jedem gelabelten Fall. Sonst lässt sich später nicht erkennen, ob ein Paar aus Zufallsstichprobe, schwierigem Segment, Review Queue oder bekanntem Fehler stammt. Diese Wege decken unterschiedliche Teile der Population ab und dürfen nicht in einer Kennzahl verschwinden.
Ein Label braucht außerdem Richtlinienversion, unabhängige Urteile, adjudiziertes Ergebnis und die damals verfügbare Evidenz. Die unangetastete Testpartition wird nach realer Entität getrennt und per Hash gesperrt. Damit gelangen Records derselben Person nicht zugleich in Training und Test.
Bei einer neuen Regel- oder Modellversion wird dieselbe geschützte Partition erneut ausgewertet. Paar- und Entitätsergebnisse werden nach Quelle und Folgewirkung berichtet. Neue Fälle erweitern eine neue Dataset-Version, ohne die historische Messlatte umzuschreiben.
Wie verbinden wir gelabelte Wahrheit mit Tilores Regeln?
Wir konfigurieren deterministische, Fuzzy- und probabilistische Matcher als getrennte Verfahren. Mit der Regelsimulation lassen sich ausgewählte Record-Paare vor dem Deployment prüfen. Ein gelabelter Korpus ergänzt die breitere Messung von verpassten Kandidaten, falschen Links und Änderungen der Entitätstopologie.
Bewahren Sie ursprüngliche Record-Werte neben den normalisierten Features auf. Reichen Sie kontrollierte Records über GraphQL ein, halten Sie das exakte Regelpaket fest und speichern Sie Paar- sowie Entitätsentscheidungen bei der Dataset-Version. So bleibt der Pfad vom Quellenfall zum Messergebnis reproduzierbar.
Unser Leitfaden zum End-to-End-Rollout setzt gelabelte Wahrheit vor den Parallelbetrieb. Für diesen Datensatz zählt, dass eine unangetastete Testpartition mehrere Releases übersteht und Leistung weiterhin nach Quelle, Schwierigkeit und fachlicher Folge sichtbar macht.
Häufig gestellte Fragen
Wie groß muss ein Ground-Truth-Datensatz sein?
Es gibt keine universelle Zahl. Größe hängt von Fehlerrate, gewünschter Präzision, Zahl wichtiger Segmente und Modellkomplexität ab. Ein kleinerer, gut geschichteter und konsistent adjudizierter Satz kann wertvoller sein als ein großer bequemer Export.
Dürfen Produktions-Matches als Labels dienen?
Sie können Fälle liefern, sind aber keine unabhängige Wahrheit. Werden sie direkt als Label genutzt, misst die Evaluation vor allem Übereinstimmung mit dem Altsystem und bewahrt dessen blinde Flecken.
Bleiben ungelöste Beispiele im Datensatz?
Ja. Sie messen Abdeckung und zeigen, wo verfügbare Evidenz keine sichere Entscheidung trägt. Ein Ausschluss lässt reale Mehrdeutigkeit aus der Evaluation verschwinden.
Was ist das größte Leakage-Risiko?
Records derselben realen Entität in Training und Test sind ein typisches Problem. Auch häufige Nutzung des Holdouts für Schwellenwertentscheidungen macht ihn faktisch zu einem weiteren Validation Set.
Wie oft müssen Labels erneuert werden?
Bei Änderungen an Quellen, Entitätsdefinition, Regeln oder wichtigen Fehlermustern. Nutzen Sie versionierte Ergänzungen und dokumentierte Korrekturen statt eines kalenderbasierten Überschreibens.
Quellen
- UK Government: Quality assessment in data linkage. Precision, Recall, Trainingsdaten, Grenzen manueller Prüfung und Bewertung von Verknüpfungsfehlern.
- Office for National Statistics: RIO data linkage pilot. Manuelle Prüfung als ressourcenintensive Goldstandard-Methode und Analyse von Verknüpfungsfehlern.
- Gebru et al.: Datasheets for Datasets. Dokumentation von Motivation, Zusammensetzung, Erhebung, Vorverarbeitung, Nutzung und Pflege eines Datensatzes.
- NIST AI Risk Management Framework Core. Die Funktionen Govern, Map, Measure und Manage für evidenzbasierte KI-Risikokontrollen.
- Tilores documentation: Matcher Reference. Funktionsweise deterministischer, unscharfer und probabilistischer Matcher.
- Tilores documentation: Rules Configuration. Produktspezifisches Verhalten von Regeln, Transformationen, Matchern und Simulation.
- Tilores: Wie ein Entity-Resolution-Rollout 2026 wirklich abläuft – von Anfang bis Ende. Interner Kontext zu gelabelter Wahrheit, Parallelbetrieb und operativer Verantwortung.
- Tilores documentation: API. GraphQL-Operationen und der Entity-Event-Stream.
Ground Truth ist durch Population, Zeitraum und Richtlinie begrenzt. Diese Grenzen gehören zu jeder Kennzahl, die aus dem Datensatz abgeleitet wird.
Sehen Sie, was aufgelöste Entitätsdaten für Ihr Unternehmen — und Ihre KI — leisten.