Warum wurden diese beiden Bankkundendatensätze zusammengeführt? Welche Auditnachweise Prüfer brauchen

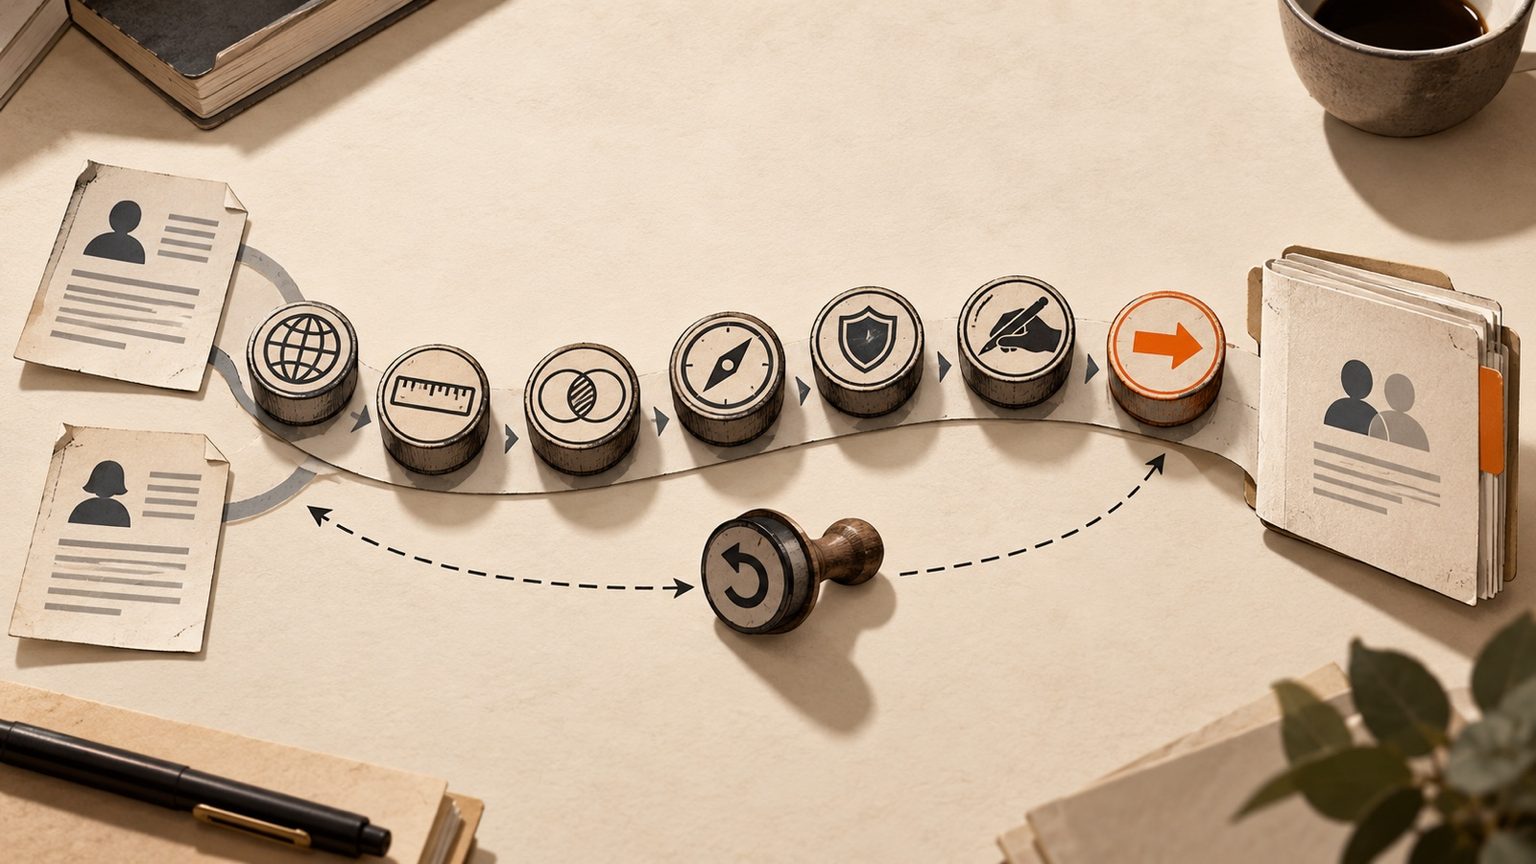
Kurzfassung: Zwei Bankkundendatensätze sollten nur zusammengeführt werden, wenn die Nachweise zeigen, dass sie nach der Richtlinie der Bank zu derselben Person oder Organisation gehören. Prüfende benötigen die ursprünglichen Eingaben, die Normalisierungshistorie, Nachweise auf Feldebene, die Matching-Methode, den Entscheidungsweg und einen getesteten Weg zur Korrektur einer falschen Zusammenführung.
Demo buchen, um zu prüfen, ob Ihre Nachweise zur Zusammenführung einer Überprüfung standhalten, oder Tilores Studio kostenlos testen, um eine Fallakte mit eigenen Daten nachzubilden.
Auf dieser Seite
- Was sollten Prüfende nachvollziehen können?
- Warum reicht ein Match Score nicht aus?
- Was gehört in das Nachweispaket auf Fallebene?
- Wie sollte eine Bank das Nachweispaket erstellen?
- Wie kann Tilores die zugrunde liegenden Nachweise offenlegen?
- Wie sollte die Zusammenführung mit Screening-Entscheidungen verknüpft werden?
- Was sollte geschehen, wenn jemand die Zusammenführung anficht?
- FAQ
- Kann Ihr Team eine angefochtene Zusammenführung lückenlos erklären?
- Quellen
Ein zusammengeführter Kundendatensatz kann Screening-, Service- und Risikoentscheidungen beeinflussen, lange nachdem das Matching abgeschlossen ist. Wenn jemand prüft, warum zwei Datensätze zu einer Entität wurden, zeigt ein Score allein weder die Eingaben noch die Richtlinie oder menschliche Eingriffe, die das Ergebnis tragen.
Die Nachweise müssen deshalb mit der Entscheidung weitergegeben werden. Datenherkunft, Normalisierung, Übereinstimmungen und Konflikte auf Feldebene, die Matching-Methode und jede spätere Korrektur sind nötig, um einen Fall zu rekonstruieren. Zugleich bleibt die Entity Resolution so von den nachgelagerten Prüfungen auf Sanktionen, PEP und Adverse Media getrennt, die die aufgelöste Identität verwenden können.
Was sollten Prüfende nachvollziehen können?
Prüfende sollten bei den beiden strittigen Quelldatensätzen beginnen und den Weg zum aufgelösten Kunden unabhängig nachvollziehen können. Dieser Weg sollte zeigen, was die Bank zum Entscheidungszeitpunkt wusste, welche Nachweise die Datensätze miteinander verbanden, welche Nachweise im Widerspruch standen, welche Richtlinie das Ergebnis akzeptierte und was anschließend in nachgelagerten Prozessen geschah.
Dies ist ebenso sehr eine Frage der Datenherkunft wie des Matchings. Der Basler Ausschuss beschreibt Data Lineage als die Rückverfolgbarkeit von Daten von ihrem Ursprung bis zu ihrer endgültigen Verwendung und bezeichnet sie als wichtig für die Bestätigung der Datenqualität. Bei Entity Resolution ist die endgültige Verwendung nicht nur das zusammengeführte Profil. Sie umfasst jede Kunden-, Risiko-, Screening- oder Serviceentscheidung, die dieses Profil verwendet hat.
Genauigkeit erfordert außerdem einen Weg zur Anfechtung. Die Leitlinien des ICO zur Richtigkeit besagen, dass Organisationen sicherstellen müssen, dass Quelle und Status personenbezogener Daten klar sind, und Einwände gegen die Richtigkeit sorgfältig prüfen müssen. Eine Bank sollte deshalb die Quelldatensätze und die Korrekturhistorie aufbewahren, statt die Vergangenheit mit einem nicht erklärten aktuellen Zustand zu überschreiben.
Diese Art von Rückverfolgbarkeit ist bereits regulatorisch beschrieben. Die Leitlinien des ICO zur Erklärung KI-gestützter Entscheidungen fragen Organisationen, wie sie Design- und Implementierungsprozesse über das gesamte Projekt hinweg nachvollziehbar und prüfbar gemacht haben. Die Nachweise einer Bank zu einer Zusammenführung sollten demselben Maßstab genügen: Prüfende sollten diesen Weg direkt nachvollziehen können, statt eine nachträglich verfasste Zusammenfassung zu akzeptieren.
Der Praxistest ist einfach: Könnten Prüfende sowohl die Frage „Warum wurden diese Datensätze verknüpft?“ als auch die Frage „Warum durfte sich diese Verknüpfung auf diesen Workflow auswirken?“ beantworten? Die erste Frage betrifft die Nachweise. Die zweite betrifft die Governance. Eine belastbare Fallakte benötigt beides.
Warum reicht ein Match Score nicht aus?
Ein Score verdichtet Nachweise. Er zeigt nicht, welche Felder übereinstimmten, welche Werte normalisiert wurden, welcher Widerspruch toleriert wurde oder ob derselbe Score in einem Workflow mit höherem Risiko zu einem anderen Ergebnis geführt hätte.
Zwei Datensätze könnten dasselbe Geburtsdatum und dieselbe normalisierte Adresse aufweisen, sich aber beim Nachnamen widersprechen. Ein anderes Paar könnte eine starke Kundenkennung gemeinsam haben, jedoch eine alte Telefonnummer enthalten. Prüfende benötigen diese Fakten getrennt voneinander. Eine einzige aggregierte Zahl kann den Unterschied zwischen diesen Fällen nicht erklären.
Die Nachweise sollten auch zwischen den Matching-Methoden unterscheiden. Deterministische, fuzzy und probabilistische Matching-Methoden beantworten unterschiedliche Fragen und dürfen nicht unter einer einzigen Bezeichnung zusammengefasst werden. Deterministische Nachweise können eine exakte Übereinstimmung bei einer kontrollierten Kennung zeigen. Fuzzy-Nachweise können die Ähnlichkeit zwischen Namens- oder Adresszeichenfolgen zeigen. Probabilistische Nachweise können mehrere Teilsignale zu einer gewichteten Schlussfolgerung verbinden. Die Fallakte sollte die beitragende Methode, die verwendete Konfigurationsversion und das erzeugte Ergebnis benennen.
Die Genauigkeit von Fuzzy-Matching hängt von der Konfiguration ab, nicht allein von der Methodenbezeichnung. Das britische Office for National Statistics berichtet, dass sein eigener Adressabgleichsdienst mehr als 97 % der eingegebenen Adressen der richtigen Referenzadresse zuordnet, ein Ergebnis, das aus den eigenen Vergleichsregeln und der Synonymliste dieses Dienstes stammt. Die Fallakte einer Bank sollte die Konfiguration festhalten, die zu ihrem Ergebnis geführt hat, statt anzunehmen, dass Fuzzy-Matching überall gleich funktioniert.
Wenn ein Mensch das Ergebnis genehmigt, abgelehnt oder korrigiert hat, benötigen Prüfende diese Entscheidung als separates Ereignis. Menschliches Urteilsvermögen sollte nicht im maschinellen Score verborgen werden. Das NIST AI Risk Management Framework besagt, dass Prozesse für menschliche Aufsicht definiert, bewertet und dokumentiert werden sollten. Dieselbe Disziplin ist immer dann sinnvoll, wenn eine Scoring- oder modellgestützte Komponente die Resolution-Richtlinie einer Bank beeinflusst.
Neue Beiträge zu Entity Resolution, Identitätsdaten und KI. Kein Spam, Abmeldung jederzeit möglich.
Was gehört in das Nachweispaket auf Fallebene?
Das Paket sollte kompakt genug sein, damit eine einzelne prüfende Person damit arbeiten kann. Gleichzeitig muss es vollständig genug sein, damit eine weitere prüfende Person die Erklärung reproduzieren kann, ohne das Engineering-Team um eine Rekonstruktion bitten zu müssen.
| Nachweisebene | Was aufzubewahren ist | Welche Frage sie beantwortet |
|---|---|---|
| Fallidentität | Fall-ID, ID der aufgelösten Entität, IDs der Quelldatensätze, Entscheidungszeitpunkt und aktueller Status | Welche konkrete Zusammenführung wird überprüft? |
| Datenherkunft | Ursprungssysteme, Zeitstempel der Quellen, Ingestion-Ereignisse und Datensatzversionen | Woher stammt jeder Wert? |
| Transformationshistorie | Ursprüngliche Werte, normalisierte Werte und Version der Transformationsregel | Was wurde vor dem Vergleich verändert? |
| Kandidatennachweise | Verglichene Felder, Übereinstimmungen, Konflikte, fehlende Werte und verworfene Alternativen | Warum wurden diese Datensätze gemeinsam betrachtet? |
| Match-Nachweise | Deterministische Regel, Fuzzy-Vergleich oder probabilistischer Beitrag sowie das daraus resultierende Konfidenzsignal | Warum bevorzugte das System eine Zusammenführung? |
| Entscheidungsrichtlinie | Schwellenwertbereich, Ausnahmeregel, Überprüfungsanforderung und Richtlinienversion | Warum waren die Nachweise für diesen Workflow ausreichend? |
| Menschliche Handlung | Identität und Befugnis der prüfenden Person, Zeitstempel, Begründungscode und Notiz | Hat eine Person eingegriffen und warum? |
| Nachgelagerte Auswirkungen | Benachrichtigte Systeme, erneut ausgeführte Prüfungen, betroffene Warnmeldungen und gewährter oder verweigerter Zugriff | Was hat sich aufgrund der Zusammenführung geändert? |
| Korrekturweg | Trennverfahren, Beschränkung der Verbindung, Replay-Plan und Korrekturhistorie | Kann die Bank eine falsche Entscheidung sicher beheben? |
Bewahren Sie positive und negative Nachweise gemeinsam auf. Wenn zwei Datensätze zusammengeführt wurden, weil mehrere Attribute übereinstimmten, sollten auch die Konflikte erhalten bleiben. Wenn ein dritter Datensatz berücksichtigt, aber verworfen wurde, bewahren Sie den Grund dafür auf. Ohne diese negativen Nachweise können Prüfende nicht erkennen, ob das System plausible Alternativen bewertet oder lediglich den ersten akzeptablen Kandidaten zurückgegeben hat.
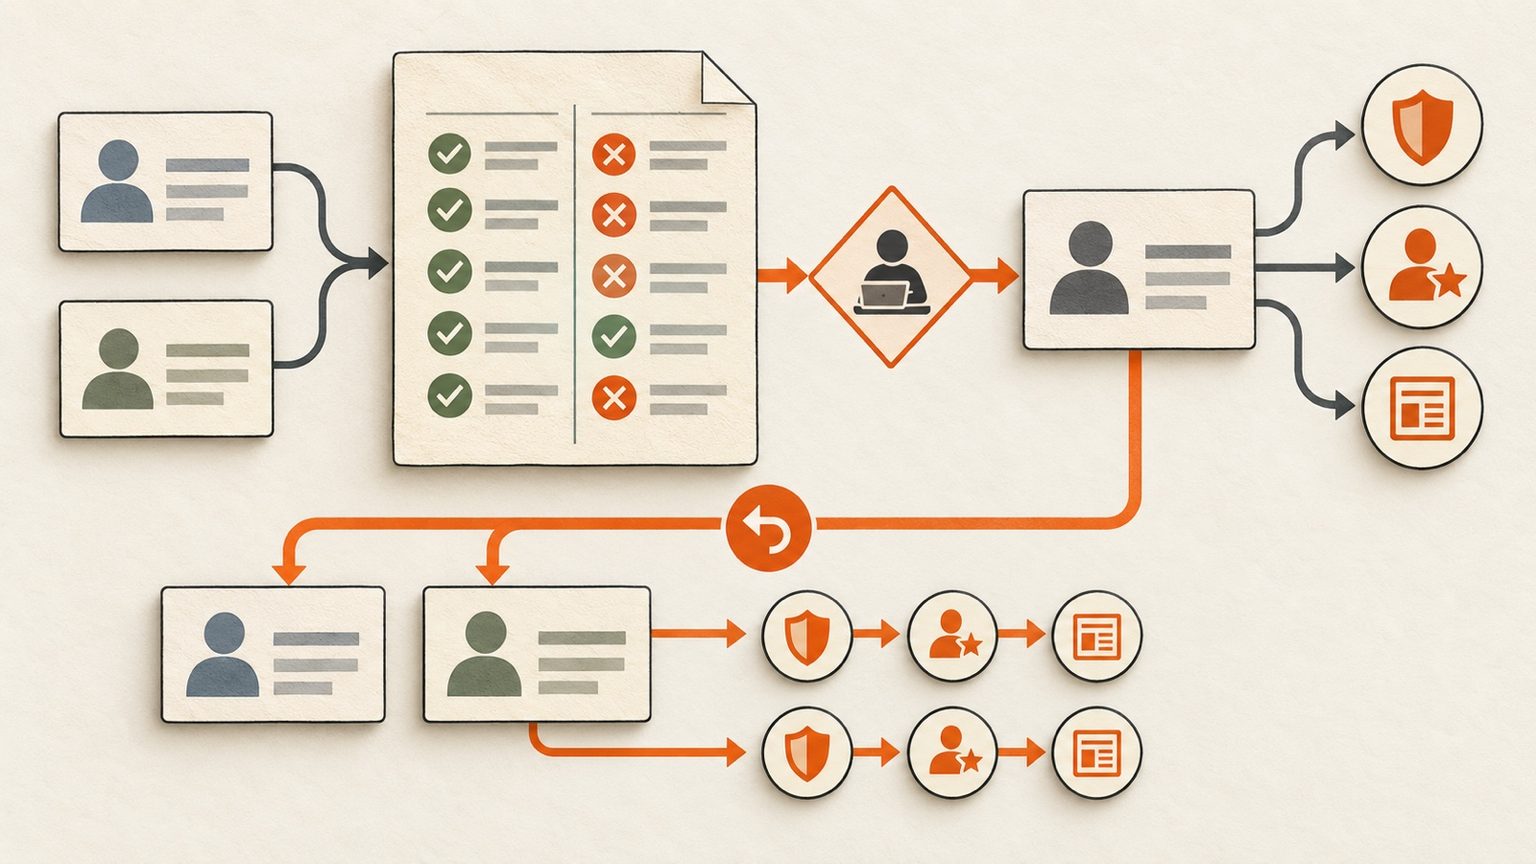
Bankprüfende untersuchen widersprüchliche Datensatznachweise, können eine vorgeschlagene Entität trennen und nachgelagerte Prüfungen erneut ausführen.
Wie sollte eine Bank das Nachweispaket erstellen?
- Schritt 1: Fallzustand einfrieren. Erfassen Sie die Entität, die beiden Quelldatensätze, deren Versionen und die zum Entscheidungszeitpunkt geltende Konfiguration. Eine spätere Datenaktualisierung darf die zu überprüfenden Nachweise nicht unbemerkt verändern.
- Schritt 2: Datenherkunft rekonstruieren. Führen Sie jedes Ursprungssystem und jedes Ingestion-Ereignis auf, das einen verglichenen Wert geliefert hat. Kennzeichnen Sie maßgebliche, historische und von Nutzern bereitgestellte Werte gemäß der eigenen Datenrichtlinie der Bank.
- Schritt 3: Normalisierung erneut ausführen. Zeigen Sie ursprüngliche und normalisierte Werte nebeneinander. Halten Sie fest, ob Groß- und Kleinschreibung, Transliteration, Telefonnummernformatierung, Adressparsing oder eine andere Transformation die Vergleichsgrundlage verändert hat.
- Schritt 4: Matching-Methoden getrennt darstellen. Identifizieren Sie jede deterministische Regel, jeden Fuzzy-Vergleich und jeden probabilistischen Beitrag unabhängig voneinander. Beschreiben Sie fuzzy und probabilistische Logik nicht so, als handele es sich um dieselbe Methode.
- Schritt 5: Entscheidungsrichtlinie anwenden. Verknüpfen Sie die Nachweise mit der Schwellenwert-, Ausnahme- und Überprüfungsrichtlinie, die für diesen Workflow galt. Die Richtlinienversion ist wichtig, weil eine spätere Kalibrierung bei denselben Datensätzen zu einem anderen Ergebnis führen kann.
- Schritt 6: Menschliche Aufsicht dokumentieren. Bewahren Sie die prüfende Person, ihre Befugnis, den Zeitstempel, die Handlung und den Grund auf. Wenn niemand den Fall überprüft hat, geben Sie an, welche Richtlinie die automatische Annahme autorisierte und unter welchen Bedingungen der Fall zur Überprüfung weitergeleitet worden wäre.
- Schritt 7: Auswirkungen und Reversibilität nachverfolgen. Führen Sie die nachgelagerten Systeme und Entscheidungen auf, die die zusammengeführte Entität verwendet haben. Testen Sie, wie die Bank die Datensätze trennen, eine sofortige erneute Zusammenführung verhindern, betroffene Prüfungen wiederholen und eine nicht irreführende Korrekturhistorie bewahren würde.
Diese Abfolge macht die Nachweise reproduzierbar. Sie trennt außerdem drei Ereignisse, die häufig miteinander verwechselt werden: Das System schlug eine Verknüpfung vor, die Richtlinie akzeptierte die Verknüpfung und ein nachgelagerter Prozess handelte auf Grundlage des aufgelösten Kunden.
Wie kann Tilores die zugrunde liegenden Nachweise offenlegen?
Unser Integrationspunkt zur Runtime ist die GraphQL API. Eine Entitätsabfrage kann die Entitätskennung, die beitragenden Datensätze, Edges und einen Entity Score offenlegen. Eine Suche kann außerdem einen Hit Score zurückgeben. Unsere Release Notes definieren den Score als die Gesamtqualität der Matches innerhalb einer Entität, während unsere API Reference den hitScore als Maß dafür definiert, wie genau ein Match mit dem angegebenen Suchparameter übereinstimmt.
Diese Signale sind Eingaben für das Nachweispaket der Bank, keine universellen Genehmigungsschwellen. Die Bank muss weiterhin ihr konfiguriertes Schema, die Regelkennungen, die Richtlinienversion, die Konsequenz für den Workflow und jede menschliche Handlung aufbewahren. Eine Zahl ohne diesen Kontext kann nicht erklären, warum eine Zusammenführung akzeptiert und eine andere eskaliert wurde.
Die Graphstruktur ist nützlich, weil sie die beitragenden Datensätze und ihre Verbindungen überprüfbar hält. Die Auditansicht sollte diese technischen Nachweise in eine Fallbeschreibung übersetzen: Datensatz A und Datensatz B wurden verglichen, diese Attribute stimmten überein, diese Attribute standen im Konflikt, diese Regel oder dieser Score kam zur Anwendung und diese Richtlinie führte zum aktuellen Zustand der Entität.
Die Korrektur muss Teil des Designs sein. Wir können Datensätze oder Edges über unsere GraphQL Disassembly Operation entfernen. Die Bank sollte eine Trennung jedoch in ihre eigenen Genehmigungs-, Downstream-Replay- und Korrekturhistorienkontrollen einbetten. Das Ziel besteht nicht nur darin, den Graphen zu verändern. Prüfende sollen eine vollständige Darstellung dessen erhalten, was geändert wurde und warum.
Wie sollte die Zusammenführung mit Screening-Entscheidungen verknüpft werden?
Bei der Auswirkungsprüfung sollte gefragt werden, ob die Zusammenführung verändert, welche Aliasse, wirtschaftlich Berechtigten oder Beziehungen an das Screening auf Sanktionen, PEP und Adverse Media übermittelt werden. Sie sollte außerdem zeigen, welcher Screening-Lauf den zusammengeführten Zustand verwendet hat und welche Version der Liste oder des Datensatzes dabei zum Einsatz kam.
Die Kalibrierung ist Teil der Kontrolle und keine nebensächliche Implementierungsfrage. Die EBA-Leitlinien zu restriktiven Maßnahmen enthalten technische Hinweise zur Auswahl des Screening-Systems, zum Screening von Kunden und Transaktionen und zur Kalibrierung dieses Systems. Eine Fallakte sollte daher Resolution-Nachweise und Screening-Nachweise miteinander verknüpft, aber getrennt aufbewahren. Die Resolution-Entscheidung identifiziert das Subjekt. Der Screening-Prozess wendet seine eigenen Listen, Einstellungen und Dispositionsregeln an.
Auch die Aktualität der Listen ist wichtig. OpenSanctions aktualisiert seine Daten regelmäßig, um Sanktions- und PEP-Listen aktuell zu halten. Wenn die Bank diese Quelle verwendet, sollten ihre Nachweise die für den Fall verwendete Datensatzversion oder Prüfsumme des Exports festhalten. Eine spätere Listenaktualisierung darf die historische Erklärung nicht mehrdeutig machen.
Ein umfassenderes Betriebsmuster finden Sie in unserem Leitfaden zu AML and KYC with real-time entity resolution. Er trennt Resolution, Screening, Analystenurteil und Entscheidungspfad voneinander. Diese Trennung ist hier wichtig: Die Zusammenführung von Datensätzen darf niemals so dargestellt werden, als sei sie selbst eine Sanktions- oder Kundenrisikoentscheidung.
Was sollte geschehen, wenn jemand die Zusammenführung anficht?
Behandeln Sie eine Anfechtung als Test des Nachweissystems und nicht als Ausnahme, die verborgen werden muss. Öffnen Sie den erhaltenen Fallzustand, reproduzieren Sie den Vergleich und stellen Sie fest, ob sich der Einwand auf einen Quellwert, eine Transformation, die Matching-Konfiguration, die Annahmerichtlinie oder eine spätere menschliche Handlung bezieht.
Wenn die Datensätze nicht hätten zusammengeführt werden dürfen, trennen Sie sie im Rahmen einer kontrollierten Änderung. Dokumentieren Sie den Grund, schützen Sie das System vor einer sofortigen Wiederholung derselben falschen Verknüpfung und identifizieren Sie jeden nachgelagerten Prozess, der den zusammengeführten Zustand verwendet hat. Screening, Kundenservice, Betrugskontrollen, Berichtswesen und Prozesse für Betroffenenrechte können jeweils eine andere Replay- oder Korrekturmaßnahme erfordern.
Löschen Sie nicht die Tatsache, dass der Fehler aufgetreten ist, wenn diese Historie zur Erklärung früherer Handlungen benötigt wird. Der aktuelle Datensatz sollte richtig sein, während die Ereignishistorie klar zwischen der ursprünglichen Entscheidung, der Anfechtung, der Korrektur und dem gegenwärtigen Zustand unterscheidet. Dadurch erhalten Prüfende eine ehrliche Chronologie, ohne dass überholte Daten als aktuelle Wahrheit dargestellt werden.
Neben dem Inhalt zählt auch die Aufbewahrungsdauer. Die britischen Geldwäschevorschriften verpflichten Unternehmen, Unterlagen zur Kundensorgfaltspflicht und Transaktionsnachweise fünf Jahre ab dem Ende einer Geschäftsbeziehung aufzubewahren, höchstens jedoch zehn Jahre. Die Korrektur- und Anfechtungshistorie einer Zusammenführung sollte mindestens so lange erhalten bleiben wie der zugrunde liegende Sorgfaltspflicht-Nachweis, den sie erklärt.
Ein nützlicher Abschlussvermerk beantwortet vier Fragen: War die Zusammenführung richtig? Was wurde geändert? Welche nachgelagerten Folgen wurden behoben? Welche Kontrolle soll eine Wiederholung unwahrscheinlicher machen? Fehlt eine dieser Antworten, wurde der Fall zwar operativ korrigiert, ist für das Audit aber noch nicht abgeschlossen.
FAQ
Beweist ein hoher Match Score, dass zwei Datensätze zu einem Kunden gehören?
Nein. Ein Score fasst konfigurierte Nachweise zusammen. Prüfende benötigen weiterhin die Übereinstimmungen und Konflikte auf Feldebene, die Datenherkunft, die Matching-Methode, die geltende Richtlinie und jede menschliche Entscheidung.
Muss jede Zusammenführung von Bankkundendatensätzen manuell überprüft werden?
Das hängt vom geltenden Recht, den aufsichtsrechtlichen Erwartungen, dem Anwendungsfall und der Richtlinie der Bank ab. Die Bank sollte dokumentieren, wann eine automatische Annahme zulässig ist und wann Mehrdeutigkeit oder Auswirkungen eine menschliche Überprüfung erfordern. Die Fallakte muss zeigen, welcher Weg angewandt wurde und warum.
Sollte eine Aufsichtsbehörde uneingeschränkten Zugriff auf alle Rohdaten von Kunden erhalten?
Das hängt von den gesetzlichen Befugnissen der Aufsichtsbehörde und vom Umfang der Anfrage ab. Die Bank sollte die für diesen Zweck erforderlichen Nachweise bereitstellen und dabei, soweit rechtlich zulässig, Zugriffs-, Datenminimierungs- und Vertraulichkeitskontrollen anwenden. Das Nachweisdesign sollte relevante Provenienz überprüfbar machen und zugleich die Möglichkeit bewahren, Rohdatensätze bereitzustellen, wenn dies gesetzlich vorgeschrieben ist.
Was sollte geschehen, wenn eine Zusammenführung falsch ist?
Die Bank sollte die Entität trennen oder anderweitig korrigieren, eine sofortige Wiederholung verhindern, betroffene nachgelagerte Prüfungen erneut ausführen und eine klare Historie der ursprünglichen Entscheidung und der Korrektur bewahren.
Wie sollten Prüfungen auf Sanktionen, PEP und Adverse Media im Paket erscheinen?
Sie sollten als nachgelagerte Prüfungen erscheinen, die mit dem Zustand der aufgelösten Entität, der Screening-Konfiguration, der Datensatzversion, dem Zeitstempel und der dokumentierten Entscheidung der prüfenden Person verknüpft sind. Sie dürfen nicht mit der Entity-Resolution-Entscheidung selbst verwechselt werden.
Kann Ihr Team eine angefochtene Zusammenführung lückenlos erklären?
Testen Sie die Frage an einem realen Fall. Beginnen Sie mit zwei Quelldatensätzen und bitten Sie eine prüfende Person, die Zusammenführung, ihre Richtliniengrundlage, ihre nachgelagerten Auswirkungen und ihren Rücknahmeweg ohne Hilfe des ursprünglich verantwortlichen Engineers zu reproduzieren.
Demo buchen, um das Nachweismuster mit unserem Team zu besprechen, oder Tilores Studio kostenlos testen, um das Entity-Resolution-Verhalten mit Ihren eigenen Daten zu untersuchen.
Quellen
- Implementation of the Principles for Effective Risk Data Aggregation and Risk Reporting, Basel Committee on Banking Supervision
- Principle (d): Accuracy, Information Commissioner’s Office
- Part 1: The Basics of Explaining AI, the Principles to Follow, Information Commissioner’s Office
- Guidelines on Internal Policies, Procedures and Controls to Ensure the Implementation of Union and National Restrictive Measures, European Banking Authority
- AI Risk Management Framework Core, National Institute of Standards and Technology
- Using Data Science for the Address Matching Service, Office for National Statistics
- The Money Laundering, Terrorist Financing and Transfer of Funds (Information on the Payer) Regulations 2017, Regulation 40, UK Legislation
- Release Notes, Tilores
- API Reference, Tilores
- Downloading the Data and Keeping It Fresh, OpenSanctions
- Data Privacy Compliance, Tilores
- AML and KYC With Real-Time Entity Resolution, Tilores
Sehen Sie, was aufgelöste Entitätsdaten für Ihr Unternehmen — und Ihre KI — leisten.