Wie Banken historische Kundendaten deduplizieren und das Matching 2026 im eigenen Haus fortführen

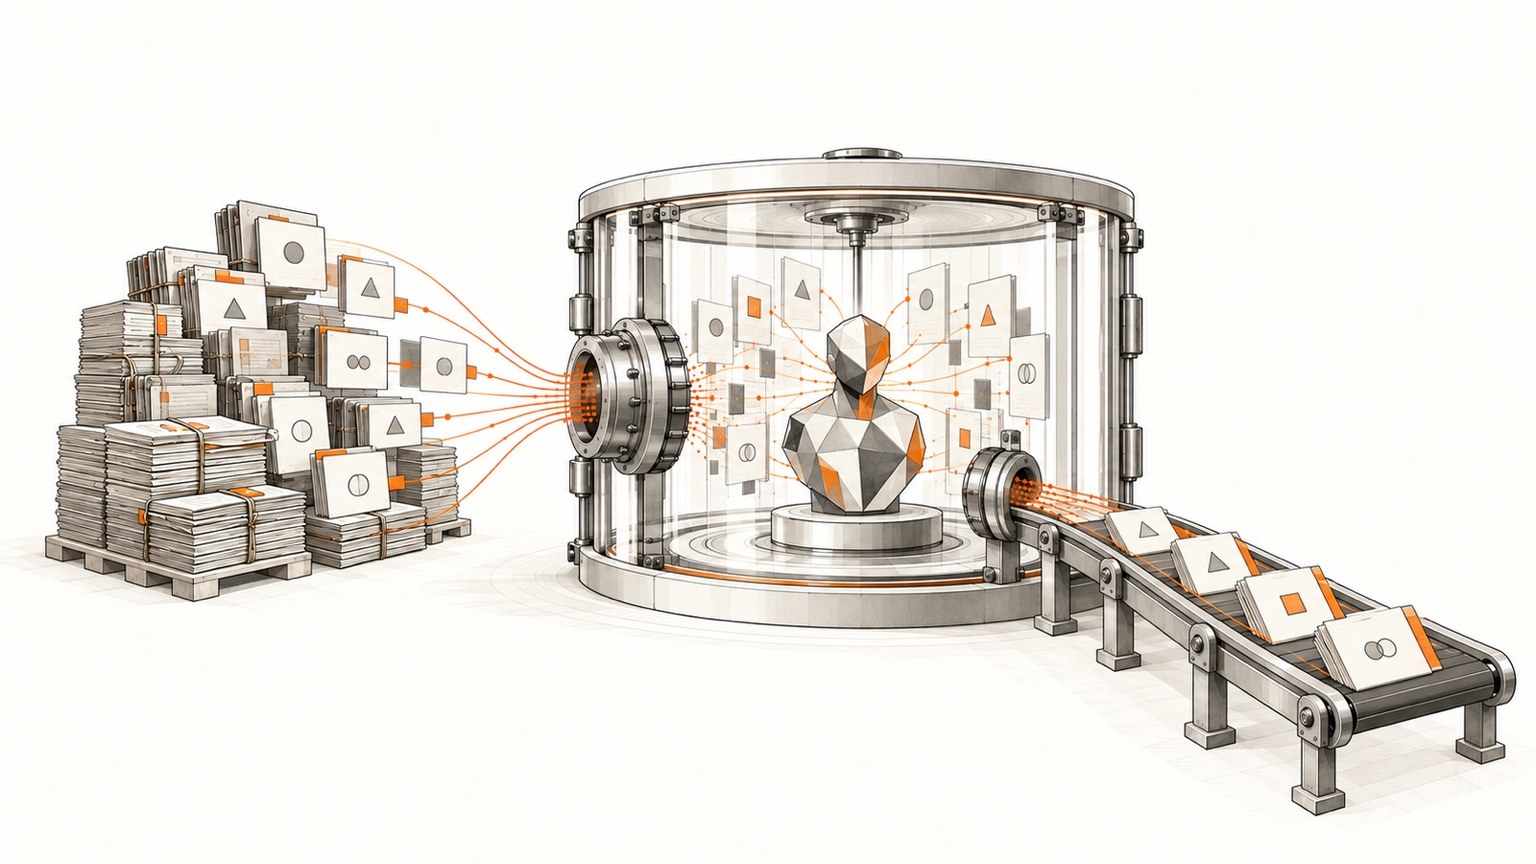
Kurzfassung: Eine Bank kann historische Kundendaten einmalig deduplizieren und aktuelle Datensätze anschließend innerhalb ihres eigenen Perimeters kontinuierlich matchen. Bewahren Sie Quelldatensätze und Provenienz, justieren Sie deterministisches, Fuzzy und probabilistisches Matching anhand gelabelter Referenzdaten, stimmen Sie Ergebnisse vor dem Cutover ab und führen Sie neue oder geänderte Datensätze durch dieselbe kontrollierte Entity-Resolution-Schicht über GraphQL.
Testen Sie den Migrationspfad mit Ihren eigenen Daten. Demo buchen · Tilores Studio kostenlos testen.
Auf dieser Seite
- Welche Architektur hält das Matching im eigenen Haus?
- Welche sieben Migrationsschritte sind erforderlich?
- Wie sollten die Matching-Methoden kombiniert werden?
- Wie sollte die Bank abstimmen und den Cutover durchführen?
- Wie funktioniert fortlaufendes Matching nach der Migration?
- Welche Bankkontrollen gehören in die Architektur?
- Welche Nachweise sollte das Programm aufbewahren?
- Häufig gestellte Fragen
Ein Projekt zur historischen Deduplizierung sollte einer Bank eine dauerhafte Entity-Resolution-Fähigkeit hinterlassen, nicht nur eine bereinigte Datenbank, in der sich sofort wieder Duplikate ansammeln. Der praktische Aufbau trennt drei Aufgaben: Quellsysteme behalten ihre operativen Rollen, eine Entity-Resolution-Schicht entscheidet, welche Datensätze zusammengehören, und die Bank behält die Kontrolle über Mastering, Risikoentscheidungen und die Steward-Prüfung.
Das ist bei einer Migration der Kernplattform, einer Übernahme oder einer Konsolidierung von Kundendaten entscheidend. Der historische Datenbestand ist endlich, Identität ist es nicht. Adressen ändern sich, Namen variieren, Konten werden verschoben und neue Kanäle erzeugen weitere Datensätze. Die Migration muss deshalb dieselben Matching-Regeln, dieselbe Lineage und dieselben Prüfgrenzen etablieren, die nach dem Cutover gelten.
Mit welcher Architektur kann eine Bank historische Daten deduplizieren, ohne ihr Betriebsmodell auszulagern?
Die Bank sollte Entity Resolution neben ihren bestehenden Kern-, MDM-, Kundenplattform-, Warehouse- und KYC-Systemen einsetzen. Die Entity-Resolution-Schicht normalisiert eingehende Datensätze, vergleicht sie, verknüpft zusammengehörige Datensätze und gibt eine aufgelöste Entität zurück. Sie muss nicht zum System werden, das Konten, Produktbetreuung, regulatorische Fälle oder das Governance-Modell der Bank verantwortet.
Tilores löst Datensätze bei der Aufnahme auf und stellt den resultierenden Entity Graph über GraphQL bereit. Die Bank kann ihre bestehende Golden-Record-Richtlinie beibehalten und entscheiden, welche Werte gegebenenfalls in einen autoritativen Master zurückgeschrieben werden. Originale Quelldatensätze und Provenienz bleiben verfügbar, sodass eine einheitliche Sicht die Nachweise für ihre Zusammensetzung nicht löscht.
| Schicht | Hauptverantwortung | Was in der Verantwortung der Bank bleibt |
|---|---|---|
| Quellsysteme | Kunden-, Konto- und Interaktionsdatensätze erstellen und aktualisieren | Operative Daten, Quellidentifikatoren und Zugriffsrichtlinien |
| Entity Resolution | Datensätze normalisieren, vergleichen, verknüpfen, trennen und zusammenführen | Genehmigte Konfiguration, Schwellenwerte und Deployment-Perimeter |
| Golden-Record- oder MDM-Schicht | Survivorship anwenden und gemasterte Werte veröffentlichen | Richtlinie für autoritative Werte und Downstream-Verträge |
| Risiko- und Compliance-Systeme | KYC-, Sanktions-, PEP-, Adverse-Media- und Betrugs-Workflows ausführen | Risikobereitschaft, Alert-Bearbeitung und Fallentscheidungen |
| Data Stewardship | Unsichere oder folgenreiche Verknüpfungen prüfen | Entscheidungsrechte, Nachweise und Eskalation |
Matching im eigenen Haus zu behalten kann bedeuten, innerhalb des AWS-Kontos der Bank, in einer anderen Cloud-Umgebung, im eigenen Rechenzentrum oder in einem Air-Gap-Netzwerk zu deployen. Die Tilores Deployment-Optionen halten die Matching-Regeln und die GraphQL API konsistent, während der Datenperimeter der Architektur und den Datenresidenzanforderungen der Bank folgen kann.
Welche sieben Schritte verbinden historische Deduplizierung mit fortlaufendem Matching?
- Kundenentscheidung und Verantwortliche definieren. Benennen Sie die Entscheidung, die die aufgelöste Identität unterstützen soll. Beispiele sind die Migrationsabstimmung, Duplikatprüfungen beim Onboarding, Kundenservice, die Aggregation von Kreditengagements oder AML-Untersuchungen. Weisen Sie Verantwortliche für Matching-Richtlinie, Steward-Prüfung, Datenschutz, Modellvalidierung und Downstream-Abnahme zu.
- Jede Quelle vor dem Datentransfer vertraglich festlegen. Dokumentieren Sie Quellsystem, stabilen Datensatzidentifikator, Feldbedeutungen, Aktualisierungssemantik, Löschverhalten und Lineage-Anforderungen. Ein Migrationsextrakt ohne diesen Vertrag wird zu einer Ansammlung von Werten, die sich nach dem Matching nicht zuverlässig abstimmen lässt.
- Felder normalisieren und Originale beibehalten. Standardisieren Sie Vergleichswerte wie Groß- und Kleinschreibung von Namen, Telefonnummernformate und geparste Adressen. Bewahren Sie die Originalwerte neben der normalisierten Darstellung auf. So erhält das Matching vergleichbare Inputs, ohne historische Nachweise umzuschreiben.
- Gelabelte Referenzdaten aus schwierigen Fällen aufbauen. Erstellen Sie bestätigte Matches und bestätigte Non-Matches aus realen Bankdaten. Beziehen Sie häufige Namen, gemeinsam genutzte Adressen, Transliteration, fehlende Identifikatoren, Haushaltsbeziehungen, Geschäftskunden und ähnlich aussehende Datensätze verschiedener Personen ein. Teilen Sie die Labels in Tuning- und Holdout-Sets auf.
- Den historischen Bestand in einem kontrollierten Lauf auflösen. Laden Sie die vereinbarten Quellen, frieren Sie die Konfigurationsversion ein und verarbeiten Sie den gesamten historischen Umfang. Erfassen Sie Datensatz- und Entitätszahlen, Verknüpfungen, Trennungen, Regeltreffer, Prüffälle und abgelehnte Datensätze. Überschreiben Sie während dieses Laufs keine Quellsysteme.
- Vor Änderungen an Downstream-Entscheidungen abstimmen. Vergleichen Sie den vorgeschlagenen Entitätszustand mit Quellsummen, der bisherigen Kundensicht und dem gelabelten Holdout-Set. Untersuchen Sie unerklärte Mengenänderungen, folgenreiche Zusammenführungen, fehlende Quellen und den Steward-Rückstand. Genehmigen Sie den Cutover erst, wenn die Bank die Unterschiede erklären kann.
- Neue und geänderte Datensätze fortlaufend matchen. Führen Sie nach dem Cutover jeden neuen oder geänderten Quelldatensatz durch dieselbe Entity-Resolution-Schicht über GraphQL. Überwachen Sie Genauigkeit, Aktualität, Lineage, Prüfvolumen und Löschverarbeitung. Behandeln Sie Konfigurationsänderungen als kontrollierte Releases. Planen Sie historische Neuverarbeitung separat und stimmen Sie sie gesondert ab.
Unser Entity-Resolution-Rollout umfasst Vorbereitung, gelabelte Referenzdaten, Deployment, Parallelvergleich und kontrollierten Betrieb als Bestandteile des Matchings. Der Algorithmus allein ermöglicht keinen sicheren Cutover.
Neue Beiträge zu Entity Resolution, Identitätsdaten und KI. Kein Spam, Abmeldung jederzeit möglich.
Wie sollte eine Bank deterministisches, Fuzzy und probabilistisches Matching kombinieren?
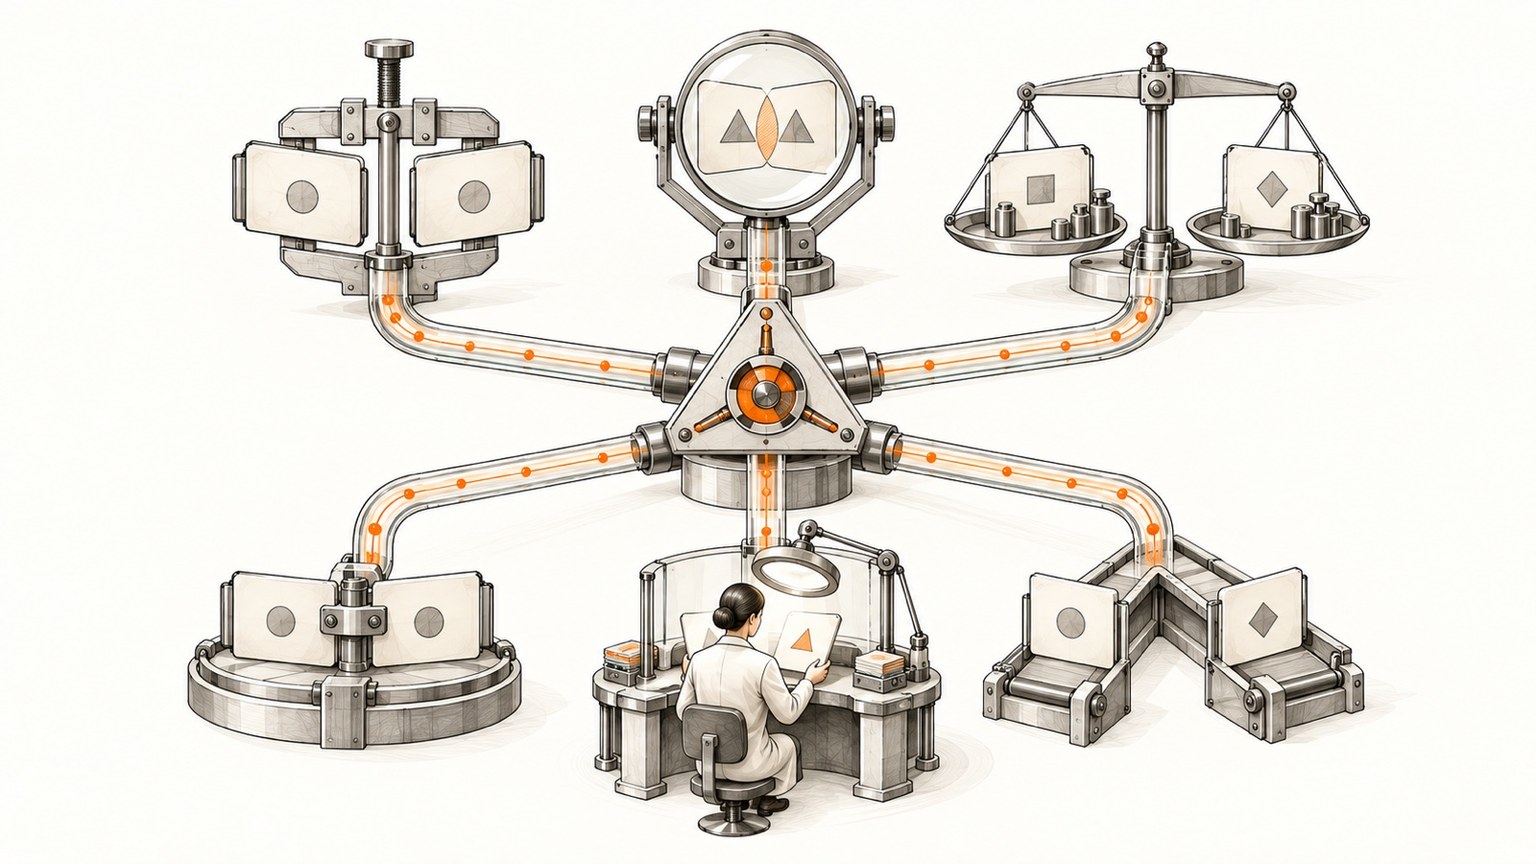
Setzen Sie die drei Methoden klar getrennt ein. Deterministisches Matching wendet exakte Regeln auf vertrauenswürdige Identifikatoren oder streng kontrollierte Kombinationen an. Fuzzy Matching misst die Ähnlichkeit zwischen nicht identischen Werten, etwa unterschiedlichen Schreibweisen. Probabilistisches Matching kombiniert Übereinstimmungen, Abweichungen und die relative Seltenheit von Signalen zu einem Score oder einer Wahrscheinlichkeit.
Die Methoden ergänzen einander, beantworten aber unterschiedliche Fragen. Ein exaktes Match auf einem verifizierten Identifikator hat eine andere Bedeutung als ein ähnlicher Namensvergleich. Ein probabilistisches Modell kann anschließend mehrere schwächere Felder gemeinsam gewichten. Der Überblick des US Census Bureau über moderne Record-Linkage-Methoden führt diese Disziplin auf das Fellegi-Sunter-Framework zurück und erklärt, warum die Partitionierung auf Entitätsebene über isolierte Datensatzpaare hinaus wichtig ist.
Überführen Sie Scores in drei kontrollierte Ergebnisse:
- Automatische Verknüpfung: Die Nachweise sind für den genehmigten Anwendungsfall ausreichend stark.
- Steward-Prüfung: Die Nachweise sind uneindeutig oder eine falsche Verknüpfung hätte schwerwiegende Folgen.
- Keine Verknüpfung: Die Nachweise überschreiten die konfigurierte Grenze nicht.
Es gibt keinen universellen Schwellenwert. Ein Migrationsteam sollte Precision und Recall anhand gelabelter Bankdaten messen und anschließend Grenzen für jede Entscheidung festlegen. Eine falsche Zusammenführung kann Informationen eines Kunden im Workflow eines anderen Kunden offenlegen. Precision ist deshalb auch eine Datenschutzkontrolle. Ein falsches Non-Match lässt Duplikate bestehen und kann Kreditengagement-, Service- und Due-Diligence-Sichten fragmentieren.
Wie sollte eine Bank die aufgelöste Kundensicht abstimmen und umstellen?
Betreiben Sie die vorgeschlagene Entitätssicht parallel zum aktuellen Prozess. Die Abstimmung sollte Änderungen erklären und nicht nur bestätigen, dass ein Job abgeschlossen wurde. Vergleichen Sie mindestens die Gesamtzahlen der Quelldatensätze und aufgelösten Entitäten, neu erstellte oder entfernte Verknüpfungen, abgelehnte und ungeklärte Datensätze sowie zur Prüfung weitergeleitete Fälle.
Das Cutover-Gate sollte auch das Downstream-Verhalten testen:
- Lässt sich jeder Quelldatensatz zu seiner aktuellen Entität zurückverfolgen?
- Kann ein Verbraucher nur die Felder abrufen, zu deren Nutzung er berechtigt ist?
- Erreichen Korrekturen, Trennungen und Löschungen jeden vertraglich angebundenen Verbraucher?
- Kann ein Steward die Nachweise sehen, die zu einem Match geführt haben?
- Kann die Bank die vorherige Konfiguration und den vorherigen Entitätszustand wiederherstellen?
Halten Sie Änderungen an Quellsystemen aus dem ersten Resolution-Lauf heraus. Sobald der Abstimmungsbericht akzeptiert ist, kann die Bank Identifikatoren oder gemasterte Werte über ihre bestehenden Integrationskontrollen veröffentlichen. Das bewahrt eine klare Rollback-Grenze und verhindert, dass ein Matching-Experiment zu einer irreversiblen Umschreibung von Daten wird.
Wie bleibt fortlaufendes Matching nach der Migration im eigenen Haus?
Der historische Lauf und der Live-Pfad sollten dieselbe Konfiguration, denselben Quellenvertrag und dasselbe Verantwortungsmodell verwenden. Neue und geänderte Datensätze gelangen über GraphQL in die Entity-Resolution-Schicht. Tilores normalisiert die übermittelten Felder, wendet deterministisches, Fuzzy und probabilistisches Matching an und erstellt, aktualisiert, führt zusammen oder trennt die aufgelöste Entität entsprechend der Nachweise.
Anwendungen fragen die aktuelle Entität ab, statt die Identität in jeder Anfrage neu aufzubauen. Das Kernsystem bleibt für das Konto verantwortlich. Die MDM-Schicht bleibt für Survivorship verantwortlich. Compliance bleibt für Fallentscheidungen verantwortlich. Die Entity-Resolution-Schicht übernimmt die engere Aufgabe, festzuhalten, welche Datensätze zu derselben Person oder Organisation gehören.
Regeländerungen erfordern Release-Disziplin. Testen Sie die Kandidatenkonfiguration anhand eingefrorener Referenzdaten, beobachten Sie ihre Wirkung auf einen repräsentativen Shadow Stream, genehmigen Sie die veränderte Verknüpfungsverteilung und deployen Sie sie anschließend. Wir wenden neue Regeln auf neue Daten an. Änderungen an historischen Ergebnissen erfordern eine separate Re-Ingestion. Diese Grenze verhindert, dass das routinemäßige Live-Matching die Migrationsbaseline unbemerkt umschreibt.
Welche regulatorischen und operativen Kontrollen gehören in die Architektur?
Entity Resolution ist Infrastruktur, ihre Kontrollen müssen jedoch zu den Pflichten der Bank passen. Die Grundsätze des Basler Ausschusses zu Risikodaten betonen Governance, Datenarchitektur, Genauigkeit, Integrität, Vollständigkeit, Aktualität und Abstimmung. Diese Grundsätze lassen sich direkt in Quellenverträge, automatisierte Lineage, Validierung und überwachte Ausnahmebehandlung übertragen.
Für personenbezogene Daten verlangt Artikel 5 der DSGVO Zweckbindung, Datenminimierung, Richtigkeit, Speicherbegrenzung, Integrität, Vertraulichkeit und Rechenschaftspflicht. Die Matching-Architektur sollte Felder deshalb auf den genehmigten Zweck begrenzen, Korrektur- und Löschpfade erhalten und genügend Nachweise aufzeichnen, um folgenreiche Verknüpfungen zu erklären.
Die aktuellen FATF Recommendations, zuletzt im Juni 2026 geändert, legen in Empfehlung 10 fest, dass Rechtsordnungen Finanzinstitute zur Identifizierung und Verifizierung von Kunden sowie zu laufender Due Diligence verpflichten sollten. Eine aufgelöste Kundensicht kann Sanktionen-, PEP- und Adverse-Media-Screening mit besserem Identitätskontext versorgen, sollte diese Fälle aber nicht entscheiden. Screening-Schwellenwerte, Risikoklassifizierung und menschliche Fallentscheidung bleiben getrennte Kontrollen.
Diese Trennung reduziert auch Fehlalarme. Der Matching-Leitfaden von OpenSanctions empfiehlt, Filter und Schwellenwerte auf den Anwendungsfall abzustimmen und die menschliche Prüfung beizubehalten. Die aufgelöste Identität sollte die Inputs für den Screening-Prozess verbessern, während der Screening-Prozess seine eigenen Nachweise und Entscheidungsaufzeichnungen behält.
Welche Nachweise sollte das Migrationsprogramm aufbewahren?
| Nachweis | Beantwortete Frage | Abnahmeverantwortung |
|---|---|---|
| Quellenvertrag | Welche Datensätze, Felder und Aktualisierungen liegen im Umfang? | Data Owner |
| Gelabeltes Referenzset | Wie sieht ein korrektes Match oder Non-Match aus? | Fachliche und Modellvalidierung |
| Konfigurationsversion | Welches Normalisierungs- und Matching-Verhalten wurde ausgeführt? | Resolution Owner |
| Abstimmungsbericht | Lässt sich jeder wesentliche Unterschied erklären? | Migrationsleitung |
| Bericht zur Steward-Warteschlange | Können uneindeutige Fälle innerhalb der Betriebskapazität geprüft werden? | Operations Owner |
| Zugriffs- und Löschtests | Funktionieren Datenschutzkontrollen über jeden Downstream-Pfad? | Datenschutz und Sicherheit |
| Rollback-Übung | Kann die Bank den vorherigen bekannten Zustand wiederherstellen? | Technologierisiko |
Die stärkste Architektur erzeugt diese Nachweise im normalen Betrieb. Dadurch wird die historische Migration auditierbar und der fortlaufende Matching-Service erhält eine messbare Betriebsbaseline.
Häufig gestellte Fragen
Kann eine Bank Kundendaten deduplizieren, ohne ihre Kernsysteme zu ersetzen?
Ja. Tilores kann als Matching- und Linking-Schicht neben Core-Banking-, MDM-, Kunden-, Warehouse- und Compliance-Systemen eingesetzt werden. Diese Systeme behalten ihre bisherigen Verantwortlichkeiten und nutzen eine über GraphQL bereitgestellte aufgelöste Entität.
Muss die Entity-Resolution-Plattform den Golden Record verantworten?
Nein. Die Bank kann die Verantwortung für den Golden Record in ihrem bestehenden MDM- oder Mastering-Prozess behalten. Tilores pflegt den aufgelösten Entity Graph und die Provenienz, während die Bank Survivorship, autoritative Werte und die Downstream-Veröffentlichung kontrolliert.
Wie wechselt eine Bank von Batch-Deduplizierung zu fortlaufendem Matching?
Die Bank verwendet die genehmigte Migrationskonfiguration für den Live-Ingestion-Pfad und übermittelt neue sowie geänderte Quelldatensätze anschließend über GraphQL. Historische Neuverarbeitung bleibt ein separater, abgestimmter Vorgang, wenn sich eine Regeländerung auf ältere Datensätze auswirken soll.
Wie kann eine Bank falsche Kundenzusammenführungen reduzieren?
Eine Bank reduziert falsche Zusammenführungen, indem sie deterministische, Fuzzy und probabilistische Methoden anhand gelabelter Referenzdaten testet, Precision getrennt von Recall misst, uneindeutige Fälle an Stewards weiterleitet und strengere Grenzen verwendet, wenn eine falsche Verknüpfung Daten offenlegen oder eine Risikoentscheidung verändern könnte.
Kann das Screening auf Sanktionen, PEP und Adverse Media die aufgelöste Kundensicht verwenden?
Ja. Diese Systeme können die aufgelöste Kundensicht als besseren Identitätskontext verwenden und dabei separate Screening-Logik, Schwellenwerte, Nachweise und menschliche Fallentscheidungen beibehalten. Entity Resolution verbessert, wer geprüft wird. Sie ersetzt nicht die Screening-Kontrolle.
Wie kann eine Bank diese Architektur vor dem Cutover testen?
Beginnen Sie mit einem kontrollierten Extrakt, einem gelabelten Set schwieriger Kundenpaare und einem Deployment-Perimeter, der das vorgesehene Produktionsmodell abbildet. Validieren Sie Matching-Verhalten und Abstimmung, bevor Sie eine Downstream-Entscheidung anbinden.
Demo buchen oder Tilores Studio kostenlos testen.
Quellen
- Entity Resolution Infrastructure, Tilores.
- Deployment Options, Tilores.
- What an Entity Resolution Rollout Actually Looks Like in 2026, End to End, Tilores.
- How to Change Entity Resolution Rules Without Breaking Production, Tilores.
- Risk Data Aggregation and Risk Reporting, Basel Committee on Banking Supervision.
- Regulation (EU) 2016/679, Article 5, EUR-Lex.
- The FATF Recommendations (last amended June 2026), Financial Action Task Force.
- A Review of Modern Multinomial-Derived and Partition-Based Record-Linkage Methods, US Census Bureau.
- The Matching API, OpenSanctions.
Sehen Sie, was aufgelöste Entitätsdaten für Ihr Unternehmen — und Ihre KI — leisten.