Sollten Sie Ihre Kundendaten bereinigen, bevor Sie eine Customer-360-Plattform kaufen?

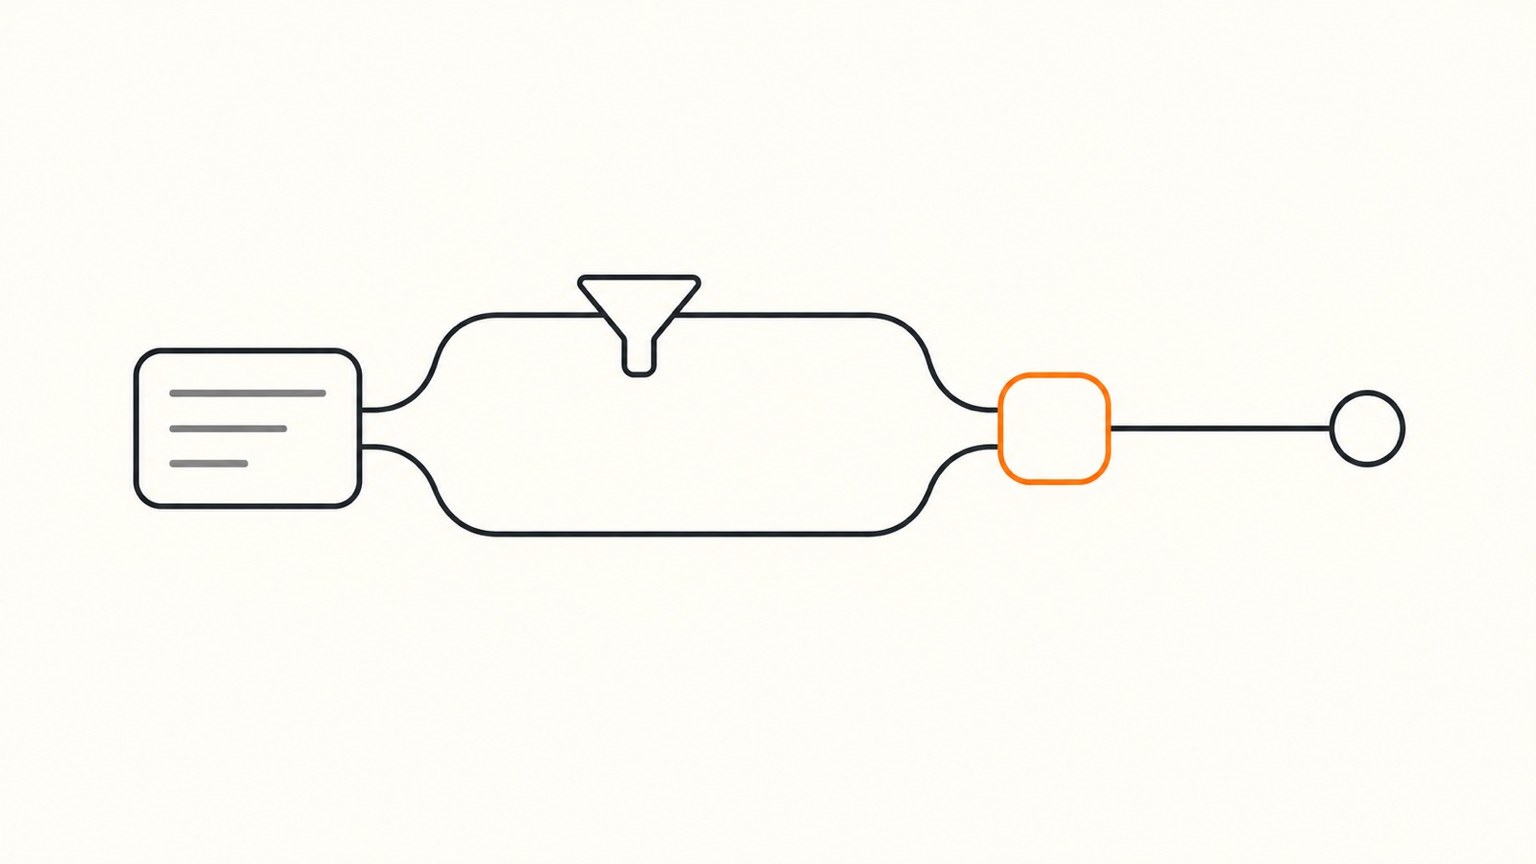
Kurzfassung: Die kurze Antwort: Keine Plattform nimmt Ihnen diese Arbeit ab. Normalisierung und Abgleich müssen irgendwo stattfinden, entweder vor der Migration oder innerhalb des neuen Systems. Wir betreiben eine Engine und ein Regelwerk für die einmalige historische Bereinigung und den laufenden Echtzeit-Abgleich, sodass die Reihenfolge-Entscheidung Sie nicht zweimal etwas kostet.
Demo buchen · Tilores Studio kostenlos testen
Auf dieser Seite
- Was leistet eine Customer-360- oder CDP-Plattform bei doppelten Kundendatensätzen wirklich?
- Warum muss die Normalisierung vor dem Abgleich erfolgen, nicht danach?
- Was kostet es eine Bank, diese Reihenfolge falsch zu wählen?
- Wo passt Tilores in dieses Bild?
- Was sollte eine Bank vor der Plattformwahl klären?
- Häufig gestellte Fragen
- Quellen
Zwei Banken, beide mitten im Aufbau eines neuen zentralen Kundendatenspeichers, stießen an unterschiedlichen Punkten im Projekt auf dasselbe Problem. Beide behandelten die Migration zunächst als reines Speicher- und Aktivierungsproblem: Datensätze verschieben, das neue System anschließen, live gehen. Beide stellten später fest, dass niemand festgelegt hatte, wer als ein Kunde zählt. Doppelte Datensätze, uneinheitliche Schreibweisen und alte neben neuen Adressen lösten sich nicht von selbst, nur weil sie jetzt in einer besser strukturierten Tabelle lagen.
Diese Entdeckung verändert das Budgetgespräch, bevor sie das Architekturgespräch verändert. Eine Bank, die eine Customer-360- oder CDP-Plattform prüft, entscheidet sich zwischen zwei Reihenfolgen: die Daten zuerst bereinigen und der neuen Plattform etwas Verlässliches übergeben, oder dem eigenen Abgleich der Plattform vertrauen, was auch immer ankommt. Nur eine dieser beiden Entscheidungen vermeidet, dieselbe Bereinigung zweimal zu bezahlen.
Was leistet eine Customer-360- oder CDP-Plattform bei doppelten Kundendatensätzen wirklich?
Die eigentliche Aufgabe einer Customer-360-Plattform oder CDP ist es, die Interaktionen, Käufe und Kontaktpunkte eines Kunden in einem Profil zu vereinen, und dieses Profil nutzbar zu machen: auf dem Bildschirm eines Kundenbetreuers, innerhalb einer Marketingkampagne oder in der Fallwarteschlange eines Betrugsteams. Das ist ein Speicher-, Zusammenführungs- und Aktivierungsproblem, und die besseren Plattformen lösen es gut.
Zu entscheiden, ob zwei Datensätze dieselbe Person beschreiben, ist ein anderes Problem: der Abgleich. Er fragt, ob “A. Müller, Musterstr. 12” und “Andreas Mueller, Musterstrasse 12, kein Geburtsdatum” derselbe Kunde sind, und ob ein dritter Datensatz mit abweichendem Geburtsdatum an derselben Adresse ein Haushaltsmitglied ist, das niemals zusammengeführt werden darf. Die Aktivierungsschicht einer Plattform setzt voraus, dass diese Frage bereits beantwortet ist. Die meisten Customer-360- und CDP-Plattformen beschreiben sich selbst als die Schicht, die ein bereits aufgelöstes Profil nutzt, nicht als die Schicht, die es von Grund auf aufbaut.
| Aufgabe | Was sie entscheidet | Wer sie vor der Plattformwahl meist verantwortet |
|---|---|---|
| Customer-360- oder CDP-Plattform | Wie ein einzelnes Profil gespeichert, bereitgestellt und aktiviert wird, sobald es existiert | Das Team, das die Plattform kauft |
| Abgleich und Normalisierung | Ob zwei Datensätze dieselbe Person beschreiben, und wie die bereinigte Version jedes Feldes aussieht | Oft niemand, bis eine Migration oder ein Regulator danach fragt |
Diese Lücke ist der Grund, warum die nützliche Frage hier nicht lautet, welche Plattform, sondern in welcher Reihenfolge gearbeitet wird. Ein CDP aktiviert ein aufgelöstes Profil; Identity Resolution ist die separate Abgleichschicht, die entscheidet, ob zwei Datensätze dieselbe Person sind (Artikel auf Englisch, keine deutsche Fassung verfügbar), und eine Bank, die eine Customer-360-Plattform kauft, muss trotzdem entscheiden, wo diese Abgleichschicht sitzt: innerhalb des plattformeigenen Abgleichs, oder als eigener Schritt davor und daneben.
Warum muss die Normalisierung vor dem Abgleich erfolgen, nicht danach?
Abgleichregeln vergleichen Werte. Werden die Werte nicht zuerst standardisiert, können zwei Datensätze, die dieselbe Person beschreiben, unterschiedlich genug aussehen, dass eine echte Übereinstimmung übersehen wird, oder eine zu großzügige Abgleichregel führt zum Ausgleich zwei verschiedene Personen zusammen. Ein Kunde, der in drei Systemen als “Müller, Andreas”, “A. Müller-Schmidt” und “Andreas Mueller” auftaucht, ist eine Person, sobald Umlaute, Transliteration und ein Name nach der Heirat in eine vergleichbare Form normalisiert sind. Ein Kunde, der auf einem Formular unter dem Mädchennamen und auf einem anderen unter dem Namen nach der Heirat auftaucht, braucht dieselbe Behandlung, bevor eine Abgleichregel erkennen kann, dass es sich um denselben Datensatz handelt. Straßenabkürzungen und Postleitzahlenformate brauchen denselben Durchgang, sonst vergleicht eine Abgleichregel zwei Zeichenketten, die zufällig dieselbe Adresse beschreiben.
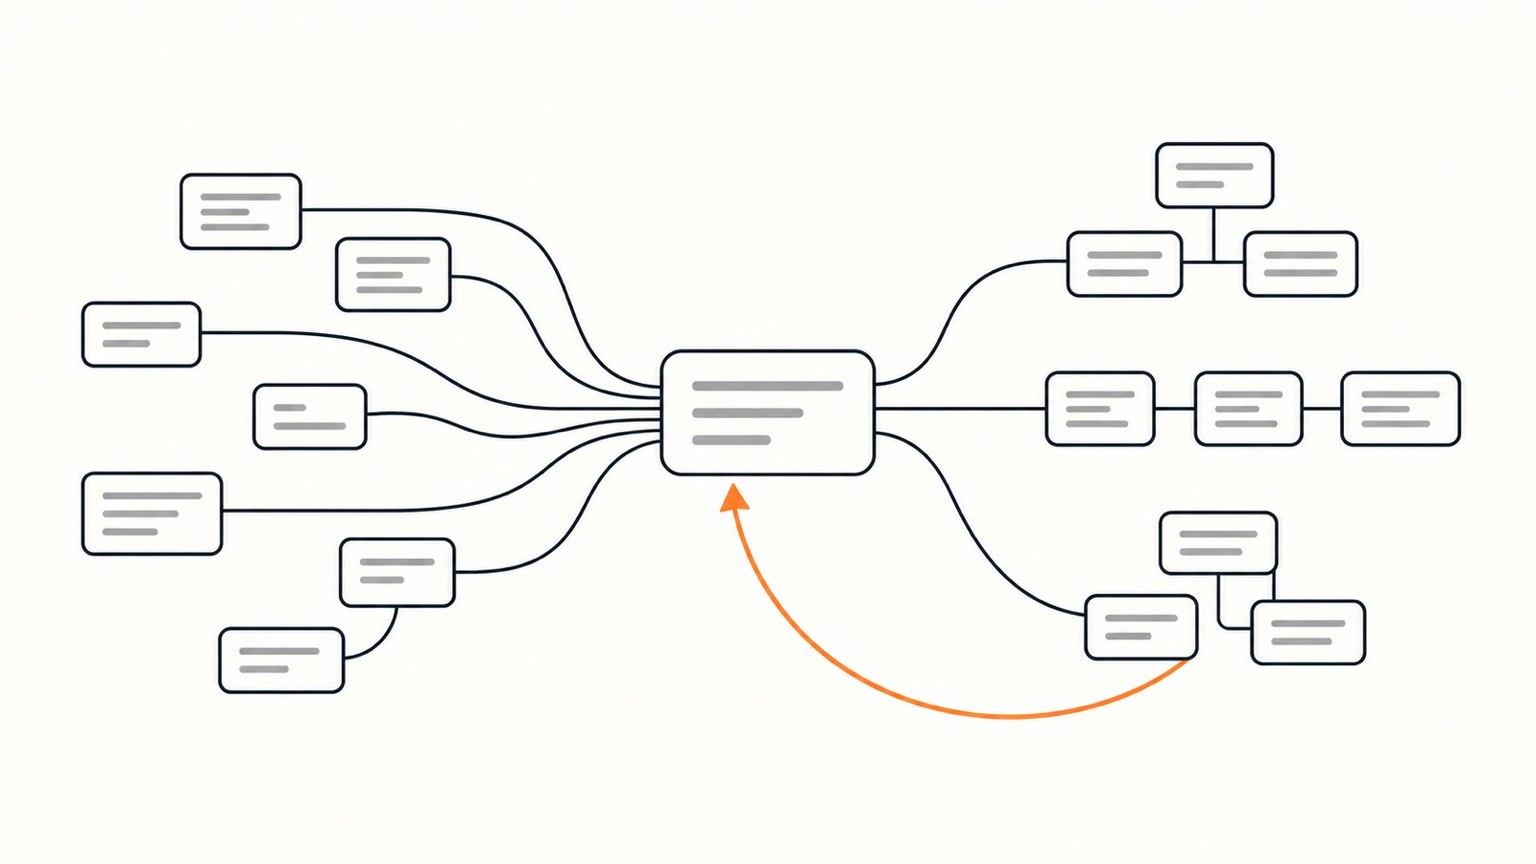
Datensätze werden bei der Auflösung standardisiert und verknüpft, und die Datenpflege speist Korrekturen laufend zurück.
Deshalb steht die Normalisierung in der Pipeline vor dem Abgleich, nicht danach. Eine Regel, die auf rohem, nicht standardisiertem Text läuft, vergleicht Rauschen, keine Datensätze. Wir normalisieren Namen, Adressen, Telefonnummern, E-Mail-Adressen, Daten und Firmennamen, bevor eine Abgleichregel läuft, und wir bewahren die Originalwerte neben den normalisierten Werten auf (Seite auf Englisch, keine deutsche Fassung verfügbar): Die normalisierte Version ist das, was die Abgleich-Engine und das Audit-Protokoll nutzen, und das Original bleibt verfügbar, auch für die eigenen Systeme des Kunden. Nichts wird überschrieben oder verworfen.
Artikel 5 Absatz 1 Buchstabe d der DSGVO verlangt, dass personenbezogene Daten “sachlich richtig und erforderlichenfalls auf dem neuesten Stand” sein müssen. Das ist eine fortlaufende Pflicht auf die lebenden Kundendaten einer Bank, unabhängig davon, welche Plattform sie verwaltet. Die Record-Linkage-Theorie hinter Abgleichsoftware, erstmals 1969 von Fellegi und Sunter formuliert und bis heute als “die theoretische Grundlage” beschrieben, auf der die meisten Record-Linkage-Algorithmen aufbauen, behandelt die Standardisierung als eigenen Schritt vor der Wahrscheinlichkeitsbewertung, nicht als Detail darin. Die eigene Forschung des US Census Bureau zu Record Linkage beschreibt dieselbe Reihenfolge: Felder zuerst bereinigen und standardisieren, dann vergleichen.
Neue Beiträge zu Entity Resolution, Identitätsdaten und KI. Kein Spam, Abmeldung jederzeit möglich.
Was kostet es eine Bank, diese Reihenfolge falsch zu wählen?
Wird die Bereinigung ausgelassen, erbt die neue Plattform jedes Duplikat, jede uneinheitliche Schreibweise und jedes nicht zusammengeführte Haushaltsmitglied aus den alten Systemen, jetzt innerhalb eines teureren, schwerer rückbaubaren Systems. Wird die Bereinigung einmalig für die Migration durchgeführt, ohne ein wiederholbares Regelwerk aufzubauen, beginnt die zweite Bereinigung (die, die der laufende Echtzeit-Abgleich braucht) wieder bei null: ein neues Regelwerk und keine gemeinsame Wahrheitsquelle zwischen dem, was das Migrationsprojekt aufgebaut hat, und dem, was ab dem ersten Tag im Produktivbetrieb läuft.
Was kostet die fehlende Budgetlinie?
Das Budgetproblem verschärft dies. Entity Resolution existiert als Haushaltsposten meist nicht im Planungszyklus einer Bank: Wer das Migrationsprogramm verantwortet, muss den Finanzierungsfall selbst aufbauen, vor dem Hintergrund, dass die Plattformlizenz bereits genehmigt und sichtbar ist, während der Bereinigungsschritt es nicht ist. Diese Asymmetrie ist ein starker Grund, die Reihenfolge-Frage schriftlich zu klären, bevor der Plattformvertrag unterschrieben wird, nicht danach.
Dasselbe Problem zeigt sich auf Branchenebene in der Forschung zur CDP-Bereitschaft: eine Analyse der CDP-Einführung aus 2025 ergab, dass sich nur 21 % der Unternehmen als datengetrieben bezeichnen, nur 32 % eine vereinheitlichte Datenbank pflegen und 77 % ihre eigene Datenqualität als durchschnittlich oder schlechter einstufen. Eine Plattform erzeugt kein Vertrauen in schlechte Daten; sie aktiviert, was ihr übergeben wird, in der Abgleichsqualität, die diese Daten bereits hatten. Ein begleitender Beitrag zur selben Bereitschaftslücke bringt es direkt auf den Punkt: Bereitschaft, nicht Technologie, entscheidet, ob sich ein Plattformkauf auszahlt.
Was kostet ein falscher Abgleich jenseits der Bilanz?
Für eine Bank ist ein falscher Abgleich nicht nur ein Kostenposten. Eine verpasste Übereinstimmung belässt ein Duplikat in den Büchern, ein Qualitätsproblem. Eine falsche Übereinstimmung legt die Daten eines Kunden in das Profil eines anderen Kunden, ein meldepflichtiger Vorfall, und sie verschlechtert die Sanktions-, PEP- und Adverse-Media-Prüfung, die auf diesem Profil aufbaut. Sanktions- und PEP-Daten, etwa die offenen Listen, die OpenSanctions zusammenführt, prüfen nur die Entität, die vorher korrekt gebildet wurde; eine falsche Zusammenführung weiter vorne erzeugt ein falsches Prüfergebnis weiter hinten, unabhängig von der Qualität der Prüfliste selbst. BCBS 239, der Standard des Baseler Ausschusses zur Risikodatenaggregation, verlangt, dass die Risikodaten einer Bank genau, vollständig und mit der Quelle abgestimmt sind, und laut der Überprüfung der Europäischen Zentralbank von Mai 2018 hatte keines der 25 untersuchten bedeutenden Institute die Grundsätze vollständig umgesetzt, Jahre nach der Frist für die größten Banken. Das ist kein Befund von Tilores. Es ist die regulatorische Grundlinie, die eine Bank unabhängig von der gewählten Customer-360- oder CDP-Plattform erfüllen muss.
Wo passt Tilores in dieses Bild?
Die eigentliche Passung besteht nicht darin, dass Tilores die Customer-360- oder CDP-Plattform ersetzt. Sie besteht darin, dass Tilores unter einer bestehenden MDM- oder Customer-360-Schicht sitzen kann, um deren Golden Records aktuell zu halten, oder als eigener Abgleichschritt vor einer Migration laufen kann, abhängig davon, was die Bank bereits besitzt. Der Mechanismus, der für die Reihenfolge-Frage zählt: Wir betreiben eine Engine und ein Regelwerk sowohl für die einmalige historische Bereinigung des Altbestands als auch für den laufenden Echtzeit-Abgleich nach dem Go-live. Eine Bank muss nicht zwei getrennte Vorhaben finanzieren, zwei Anbietern dasselbe Taxonomieproblem übergeben und hoffen, dass die Ergebnisse zueinander passen.
| Option | Was sie tatsächlich leistet | Was weiterhin Ihr Problem bleibt | Wann sie die richtige Wahl ist |
|---|---|---|---|
| Vollständige MDM-Suite | Verwaltet und pflegt Stammdaten über jede Domäne hinweg, mit integrierter Regel-Engine und Workflow | Der Umfang des Programms und das dafür nötige Budget; ein vollständiger MDM-Neuaufbau ist ein mehrjähriges Vorhaben, das die meisten Banken nicht allein wegen des Kundenabgleichs eingehen wollen | Wenn die Bank Governance über viele Datendomänen braucht, nicht nur über Kundendatensätze |
| Abgleich selbst auf dem bestehenden Datenstack bauen | Nutzt Werkzeuge und Fähigkeiten, die im Haus bereits vorhanden sind | Normalisierung, Audit-Protokolle, menschliche Prüfung im Entscheidungspfad, Persistenz und Erklärbarkeit müssen noch aufgebaut werden; eine DSGVO-Auskunftsanfrage braucht eine Antwort auf Feldebene, die ein bloßer Konfidenzwert nicht liefert | Wenn die Bank die technische Kapazität und Zeit hat, den langen Schwanz der Randfälle selbst zu verantworten |
| Auf den integrierten Abgleich der neuen Plattform vertrauen | Hält das Projekt bei einem Anbieter und einem Vertrag | Die oben beschriebene Lücke: Die meisten Customer-360- und CDP-Plattformen aktivieren ein aufgelöstes Profil, statt eines von Grund auf aufzubauen | Wenn die eingehenden Daten bereits sauber sind und die Zahl der Randfälle klein ist |
| Tilores: eine Engine für die einmalige Bereinigung und den laufenden Abgleich | Wendet dasselbe Regelwerk auf den historischen Altbestand und den laufenden Echtzeit-Strom an, wobei Originale erhalten bleiben und normalisierte Daten persistiert werden | Die Bank verantwortet weiterhin Stewardship-Entscheidungen, etwa was geschieht, wenn eine Übereinstimmung unter der Auto-Merge-Schwelle liegt | Wenn die Bank ein Abgleich-Regelwerk will, das sie für den zweiten Tag nicht neu aufbauen muss |
Demo buchen, um eine Stichprobe Ihres eigenen Altbestands durch dasselbe Regelwerk laufen zu lassen, das den Live-Abgleich betreibt, oder Tilores Studio testen, im lokalen Modus kostenlos für bis zu 100.000 Datensätze, bevor Sie sich für einen Weg entscheiden.
Was sollte eine Bank vor der Plattformwahl klären?
Klären Sie dies, bevor der Plattformvertrag unterschrieben wird, nicht erst, wenn die Migration es offenlegt:
- Benennen Sie, wer heute Abgleichentscheidungen verantwortet, und wer sie verantwortet, sobald die neue Plattform live ist.
- Entscheiden Sie, ob die einmalige historische Bereinigung und der laufende Echtzeit-Abgleich auf demselben Regelwerk laufen, oder auf zwei getrennten.
- Legen Sie die Schwellenwerte für die menschliche Prüfung fest: was automatisch zusammengeführt wird, was automatisch abgelehnt wird, und was in eine Steward-Warteschlange geht, mit jeder Entscheidung protokolliert und umkehrbar.
- Entscheiden Sie, wo die Originalwerte und die normalisierten Werte beide liegen, und wer welchen davon abfragen kann.
- Setzen Sie die Bereinigung auf eine eigene Budgetlinie, bevor die Plattformlizenz unterschrieben wird, nicht danach.
Häufig gestellte Fragen
Entfällt die Bereinigung bestehender Kundendatensätze, wenn man eine Customer-360- oder CDP-Plattform kauft?
Nein. Eine Customer-360- oder CDP-Plattform aktiviert ein vereinheitlichtes Profil; sie entscheidet selbst nicht, welche Ihrer bestehenden Datensätze dieselbe Person beschreiben. Dieser Abgleichs- und Normalisierungsschritt muss irgendwo stattfinden, vor der Migration oder innerhalb der Plattform, und ihn auszulassen lässt die Duplikate nicht verschwinden.
Sollten die einmalige historische Bereinigung und der laufende Echtzeit-Abgleich dieselben Regeln verwenden?
Das sollten sie, sonst pflegt eine Bank am Ende zwei Regelwerke, die unbemerkt voneinander abweichen können. Wir betreiben eine Engine und ein Regelwerk für sowohl die historische Bereinigung des Altbestands als auch den laufenden Abgleich, der danach folgt, sodass eine Regeländerung überall gleichzeitig greift.
Was passiert mit der ursprünglichen, nicht normalisierten Version eines Kundendatensatzes, nachdem sie für den Abgleich genutzt wurde?
Sie wird aufbewahrt, nicht verworfen. Wir bewahren den Originalwert neben dem normalisierten Wert auf: Die normalisierte Version ist das, was die Abgleich-Engine und das Audit-Protokoll nutzen, und das Original bleibt verfügbar, auch für die eigenen Systeme des Kunden.
Ist probabilistischer Abgleich dasselbe wie unscharfer (Fuzzy-)Abgleich?
Nein. Es sind zwei unterschiedliche Methoden, neben dem deterministischen Abgleich. Unscharfer Abgleich vergleicht Werte, die ähnlich, aber nicht identisch sind, etwa eine phonetische Übereinstimmung, eine kleine Editierdistanz oder eine geografische Nähe; probabilistischer Abgleich gewichtet die kombinierte Wahrscheinlichkeit mehrerer solcher Vergleiche zusammen. Beide als eine Einstellung zu behandeln, verwischt eine Unterscheidung, die das Audit-Protokoll einer Bank braucht.
Kann Tilores eine vollständige MDM-Suite ersetzen?
Für manche Banken, ja, speziell für die Abgleichs- und Golden-Record-Schicht. Für andere läuft Tilores unter einer bestehenden MDM- oder Customer-360-Plattform, um deren Datensätze aktuell zu halten. Welche Passung zutrifft, hängt davon ab, wie viel domänenübergreifende Governance die Bank über den Kundenabgleich hinaus braucht, nicht von einer Fähigkeitslücke in eine der beiden Richtungen.
Quellen
- Tilores: One Resolved Data Layer, Tilores.
- Tilores Deployment Options, Tilores.
- Tilores Data Privacy and Security, Tilores (Seite auf Englisch).
- Tilores Studio: Free Evaluation Download, Tilores.
- Tilores for Customer 360, Tilores.
- Tilores for Master Data Management, Tilores.
- CDP vs. Identity Resolution: Was entscheidet wirklich, wer Ihr Kunde ist? (2026), Tilores.
- Principles for Effective Risk Data Aggregation and Risk Reporting (BCBS 239), Bank for International Settlements.
- BCBS 239, Wikipedia, zusammenfassend zur Überprüfung der Europäischen Zentralbank von 2018.
- Regulation (EU) 2016/679 (Datenschutz-Grundverordnung), Artikel 5, EUR-Lex.
- OpenSanctions: The Open Database of Sanctions, PEPs and Watchlists, OpenSanctions.
- A Simple Two-Step Procedure Using the Fellegi-Sunter Model for Frequency-Based Record Linkage, Journal of Applied Statistics.
- Overview of Record Linkage and Current Research Directions, US Census Bureau.
- The CDP Illusion: Why Mid-Market Firms Struggle With Customer Data Platforms, CMSWire.
- The CDP Readiness Gap, Part 1: Why Most Teams Fail Before They Start, CMSWire.
- Master Data Management, Wikipedia.
- ISO 8000, Wikipedia.
- One Woman Spent Seven Years Fighting Another Person’s Debt on Her Credit Report, Schmitdy Gadget, YouTube.
Sehen Sie, was aufgelöste Entitätsdaten für Ihr Unternehmen — und Ihre KI — leisten.