Review Queues für Entity Resolution: Menschliche Entscheidungen bei mehrdeutigen Matches im Jahr 2026

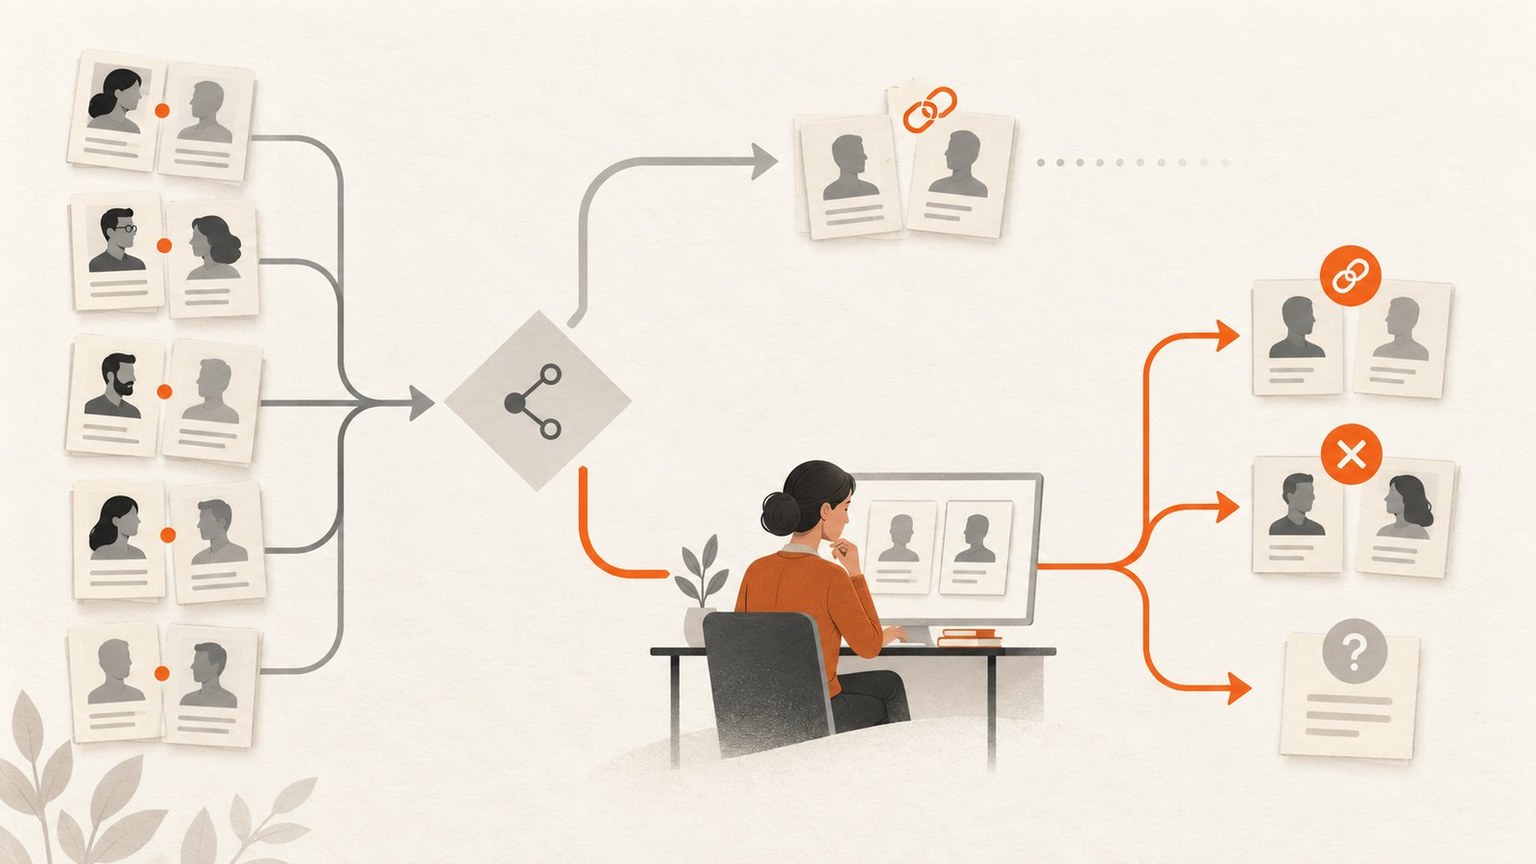
Kurzfassung: Ein Kandidat gehört in die menschliche Prüfung, wenn die Evidenz tatsächlich mehrdeutig ist und die Kosten einer automatischen Fehlentscheidung die Verzögerung rechtfertigen. Prüfer benötigen Originalwerte und normalisierte Werte, konkurrierende Kandidaten, Evidenz auf Regelebene, Quellenprovenienz und die Folgen jeder Wahl. Link, Non-Link oder ungelöst werden als versionierte Entscheidung festgehalten. Gemessen werden spätere Korrekturen und aufgehobene Entscheidungen, nicht nur der Durchsatz der Queue.
Prüfen Sie Ihre Matching-Konfiguration mit einem kontrollierten Datenausschnitt. Demo buchen · Tilores Studio kostenlos testen.
Auf dieser Seite
- Welche Matches gehören in eine Review Queue?
- Warum folgt die Queue der Auswirkung und nicht nur dem Score?
- Was müssen Prüfer tatsächlich sehen?
- Umsetzung in sieben Schritten
- Wie bleibt jede Prüfentscheidung nachvollziehbar?
- Wie unterstützen wir Review in Tilores, ohne die Richtlinie zu verstecken?
- Häufige Fragen
- Quellen
Welche Matches gehören in eine Review Queue?
Ein Kandidat gehört dann in die Prüfung, wenn drei Bedingungen zusammentreffen. Die verfügbare Evidenz lässt mehrere plausible Ergebnisse zu. Eine automatische Fehlentscheidung hätte spürbare fachliche Folgen. Und eine Person verfügt über den Kontext und die Befugnis, zu entscheiden, zu vertagen oder bessere Daten anzufordern. Fehlt eine dieser Bedingungen, entsteht leicht teure manuelle Arbeit ohne bessere Entscheidung.
Daraus ergeben sich drei legitime Zustände statt nur zwei. Eine gut belegte Verknüpfung kann automatisch akzeptiert werden. Ein gut belegter Non-Link bleibt getrennt. Ein mehrdeutiges Paar kann ungelöst bleiben, bis sich Richtlinie, Evidenz oder Zeitbezug ändern. Dieser dritte Zustand ist wichtig, weil ein Zwang zu Match oder Non-Match Unsicherheit in einen verborgenen Fehler verwandelt.
Das britische Office for National Statistics beschreibt Linkage-Verfahren mit einem oberen Schwellenwert für Links, einem unteren Wert für Non-Links und einem Zwischenbereich für die manuelle Prüfung. Das ist ein sinnvolles Grundmuster, aber kein universeller Schwellenwert. Die Bandbreite muss zu den Kosten falscher Zusammenführungen, übersehener Links und verfügbarer Prüfkapazität passen.
Warum folgt die Queue der Auswirkung und nicht nur dem Score?
Ein Score enthält nicht die fachliche Folge einer Fehlentscheidung. Ein Paar mit mittlerer Evidenz kann in einer analytischen Segmentierung getrennt bleiben, darf aber vor einer Zahlung, Kontosperre oder Zugriffsentscheidung nicht automatisch zusammengeführt werden. Die Routing-Regel benötigt deshalb zwei Eingaben: die Mehrdeutigkeit der Identitätsevidenz und die geplante Nutzung des Ergebnisses. Dasselbe Paar kann in zwei zulässigen Workflows unterschiedlich behandelt werden.
Eine einzige globale Bandbreite ist selten ausreichend. Richtlinien werden nach Entscheidungsklasse, Quellenzuverlässigkeit und Evidenzmuster getrennt. Eine stabile, verlässliche Kennung kann in einem Kontext Automatisierung erlauben. Ähnlicher Name und gleiche Adresse brauchen dagegen möglicherweise eine Prüfung, wenn Haushalte oder häufige Namen diese Kombination schwächen. Fehlen Pflichtangaben, ist Datenkorrektur der richtige Ausgang und nicht eine Schätzung durch den Prüfer.
| Ergebnis | Wann es passt | Erforderlicher Nachweis |
|---|---|---|
| Automatischer Link | Die Evidenz erfüllt die getestete Richtlinie für diese Folge. | Regel- oder Modellversion, tragende Werte und Quellen-IDs. |
| Automatischer Non-Link | Widerspruch oder fehlender Kandidat stützt die Trennung. | Kandidatenweg und Grund für die abgelehnte Verknüpfung. |
| Menschliche Prüfung | Mehrere Ergebnisse sind plausibel und die Folge rechtfertigt Eingreifen. | Relevante Evidenz, Alternativen, Richtlinie und Begründung. |
| Datenkorrektur | Ein Pflichtwert fehlt, ist fehlerhaft oder fachlich unbrauchbar. | Quellenverantwortlicher, Qualitätsgrund und sichere Wiederholung. |
| Ungelöst | Evidenz und zulässiger Kontext tragen keine dauerhafte Entscheidung. | Vertagungsgrund, Auslöser für neue Prüfung und Consumer-Verhalten. |
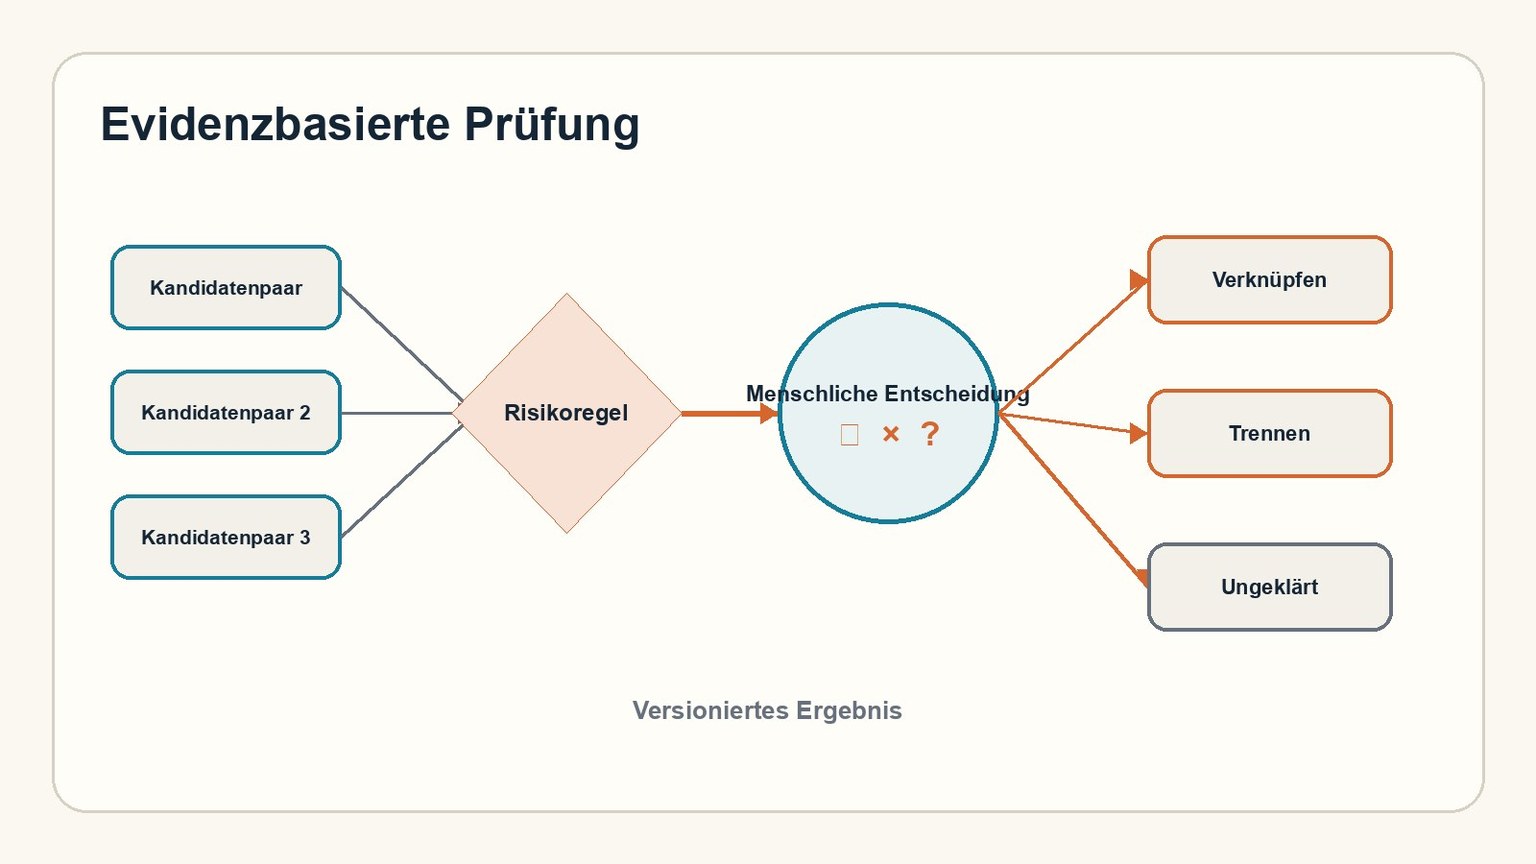
Eine gute Queue bewahrt den Weg von der Kandidatenevidenz bis zu einem Ergebnis, das später erklärt oder geändert werden kann.
Neue Beiträge zu Entity Resolution, Identitätsdaten und KI. Kein Spam, Abmeldung jederzeit möglich.
Was müssen Prüfer tatsächlich sehen?
Das Paar wird im Kontext gezeigt und nicht als zwei geglättete Profile. Originalwerte stehen neben den normalisierten Vergleichswerten. Dazu kommen Quelle und Zeitstempel, die Regeln oder Score-Bestandteile für den Kandidaten und konkurrierende Entitäten. Ein Feldkonflikt muss auffallen. Ein fehlender Wert darf in der Oberfläche niemals wie eine Übereinstimmung aussehen.
Auch die Folge der Entscheidung braucht Klartext. ‘Datensätze zusammenführen’ ist unvollständig, wenn dadurch ein Konto verschoben, eine Kundensicht verändert oder eine Berechtigungsentscheidung ausgelöst wird. Prüfer müssen wissen, ob sie eine Identitätsbeziehung bestätigen, Quelldaten korrigieren oder eine fachliche Aktion autorisieren. Diese Fragen in einer Schaltfläche zu vermischen, erschwert Audit und Umkehr.
Ebenso wichtig ist ein Ausweg. Die Oberfläche erlaubt ein ungelöstes Ergebnis, Eskalation und die Anforderung einer Quellenkorrektur. Reason Codes sollten stabil und aussagekräftig, aber nicht überwältigend zahlreich sein. Freitext hilft bei Ausnahmen. Eine kleine Taxonomie ermöglicht jedoch erst, wiederkehrende Datenlücken und unklare Regeln zu erkennen.
Umsetzung in sieben Schritten
- Geschützte Entscheidung benennen. Dokumentieren Sie die Folgen eines False Merge und eines übersehenen Links in diesem Workflow. Legen Sie fest, welche Ergebnisse automatisch umkehrbar sind und welche einen weiteren Verantwortlichen benötigen.
- Kalibrierungsdatensatz aufbauen. Nehmen Sie einfache Links, klare Non-Links und schwierige Grenzfälle aus dem realen Quellenmix auf. Adjudizierte Beispiele bleiben von der täglichen Queue-Bearbeitung getrennt, damit Schwellenwerte gegen stabile Evidenz geprüft werden.
- Routing-Regeln definieren. Verbinden Sie Evidenzbänder mit Auswirkung, Quellenqualität und Pflichtfeldern. Die Richtlinie wird versioniert. Eine pauschale Grenze wie 0,9 hat ohne Bezug zu Matcher, Population und Fehlerkosten keine belastbare Bedeutung.
- Evidenzansicht gestalten. Zeigen Sie Originale, normalisierte Werte, Provenienz, Konflikte, konkurrierende Kandidaten und die aktive Regel- oder Modellversion. Nicht zulässige Attribute werden ausgeblendet, damit sie die Entscheidung nicht beeinflussen.
- Entscheidung und Ausführung trennen. Zuerst wird das Prüfergebnis festgehalten. Danach wendet ein autorisierter Dienst die Entitätsänderung an und informiert Consumer. So bleiben Wiederholung, Rollback und Audit möglich.
- Qualität statt Tempo allein messen. Alter und Kapazität der Queue sind wichtig. Zusätzlich zählen Übereinstimmung zwischen Prüfern, aufgehobene Entscheidungen, spätere Reversals, Reason Codes und nachgelagerte Korrekturen.
- Lernschleife kontrolliert schließen. Prüfergebnisse dienen zur Analyse von Quellenqualität und zur Kalibrierung. Nicht jeder Klick ist automatisch Trainingswahrheit. Prüfer können irren, Richtlinien ändern sich und die Queue zeigt nur einen ausgewählten Teil der Population.
Wie bleibt jede Prüfentscheidung nachvollziehbar?
Bewahren Sie die Evidenz auf, durch die ein Fall in die Prüfung gelangt ist: Kandidatenpfad, ursprüngliche und normalisierte Werte, Quellenzeitpunkte, konkurrierende Entitäten sowie die aktive Regel- oder Modellversion. Prüfer müssen eine exakte Kennungsübereinstimmung von einem Fuzzy-Kandidaten oder einem probabilistischen Score unterscheiden können.
Der Entscheidungsdatensatz ergänzt Ergebnis, Begründung, Richtlinienversion und einen möglichen Ablauf- oder Eskalationsauslöser. So lässt sich später rekonstruieren, warum ein Link, Non-Link oder ungelöster Fall gewählt wurde und ob ähnliche Entscheidungen wiederholt aufgehoben werden.
Diese Evidenz begleitet das Ergebnis. Quellen-IDs und Ereigniszeit zeigen, welche Entität und welche Consumer-Sichten sich geändert haben. Eine Korrektur bleibt damit nicht als Notiz im Review Tool stecken, sondern erreicht die betroffenen Referenzen.
Wie unterstützen wir Review in Tilores, ohne die Richtlinie zu verstecken?
Wir modellieren Records als Knoten und Matching-Beziehungen als Kanten. Unsere Regeln können deterministische, Fuzzy- und probabilistische Verfahren kombinieren. Mit der Simulation in unserer Regelkonfiguration lässt sich das beabsichtigte Verhalten vor dem Einsatz auf Live-Daten prüfen. Die Richtlinie für eine folgenreiche Entscheidung bleibt dennoch beim verantwortlichen Team.
Über GraphQL können Review Services den aktuellen Entitätskontext abrufen und eine autorisierte Entscheidung mit der erforderlichen Quellenevidenz festhalten. Die Entscheidung darf nicht als dauerhaftes Profilattribut ohne Herkunft gespeichert werden und soll nur die für den Prüfer zulässigen Attribute enthalten.
Unser Leitfaden zum End-to-End-Rollout ordnet gelabelte Wahrheit, Verantwortung und Parallelbetrieb ein. Für die Queue zählt der engere Nachweis: Mehrdeutige Fälle erreichen eine befugte Person, ihre Begründung bleibt erhalten und nachgelagerte Korrekturen konvergieren.
Häufig gestellte Fragen
Ist menschliche Prüfung nur für probabilistisches Matching gedacht?
Nein. Auch eine deterministische Regel kann falsche Feldbedeutungen verwenden, und ein Fuzzy-Kandidat kann durch starke unabhängige Evidenz gestützt werden. Auslöser sind Mehrdeutigkeit und Folge, nicht der Name der Methode.
Soll jedes Paar mit niedrigem Score geprüft werden?
Nein. Viele Paare können sicher getrennt bleiben, andere gehören zur Datenkorrektur. Eine Prüfung lohnt sich nur, wenn eine Person zulässigen Kontext beitragen kann und der Wert der Entscheidung die Kosten rechtfertigt.
Welche Kennzahl zeigt den Erfolg einer Review Queue?
Nutzen Sie ein Bündel aus Entscheidungszeit, Übereinstimmung zwischen Prüfern, ungelöster Quote, aufgehobenen Entscheidungen, späteren Reversals und nachgelagerten Korrekturen. Durchsatz allein belohnt vorschnelle Entscheidungen.
Können Prüferentscheidungen ein Modell trainieren?
Nach Adjudikation und Bias-Prüfung können sie zu gelabelten Beispielen beitragen. Da die bestehende Logik die Queue auswählt, repräsentieren ihre Fälle nicht automatisch die gesamte Population.
Wie wird Uneinigkeit zwischen Prüfern behandelt?
Beide Erstentscheidungen bleiben erhalten. Der Fall geht in die Adjudikation, und die finale Begründung wird dokumentiert. Wiederholte Uneinigkeit weist auf unklare Richtlinien, Oberfläche oder Data Contracts hin.
Quellen
- Office for National Statistics: RIO data linkage pilot. Manuelle Prüfung als ressourcenintensive Goldstandard-Methode und Analyse von Verknüpfungsfehlern.
- Office for National Statistics: Developing standard tools for data linkage. Schwellenwertbänder und Weiterleitung mehrdeutiger Paare an die manuelle Prüfung.
- UK Government: Quality assessment in data linkage. Precision, Recall, Trainingsdaten, Grenzen manueller Prüfung und Bewertung von Verknüpfungsfehlern.
- Information Commissioner’s Office: Human review. Schulung der Prüfer, Overrides, Stichproben, Toleranzen und Dokumentation.
- Tilores documentation: Rules Configuration. Produktspezifisches Verhalten von Regeln, Transformationen, Matchern und Simulation.
- Tilores documentation: Matcher Reference. Funktionsweise deterministischer, unscharfer und probabilistischer Matcher.
- Tilores: Wie ein Entity-Resolution-Rollout 2026 wirklich abläuft – von Anfang bis Ende. Interner Kontext zu gelabelter Wahrheit, Parallelbetrieb und operativer Verantwortung.
- Tilores documentation: API. GraphQL-Operationen und der Entity-Event-Stream.
Hinweis zum Umfang: Dieser Leitfaden behandelt das Betriebsdesign der Entity Resolution. Er ersetzt keine branchenspezifische Rechts-, Compliance- oder Personalberatung.
Sehen Sie, was aufgelöste Entitätsdaten für Ihr Unternehmen — und Ihre KI — leisten.