Regeln oder Machine Learning: Welcher Matching-Ansatz bringt eine Bank am schnellsten zu einem validierten Produktiv-Release? (2026)

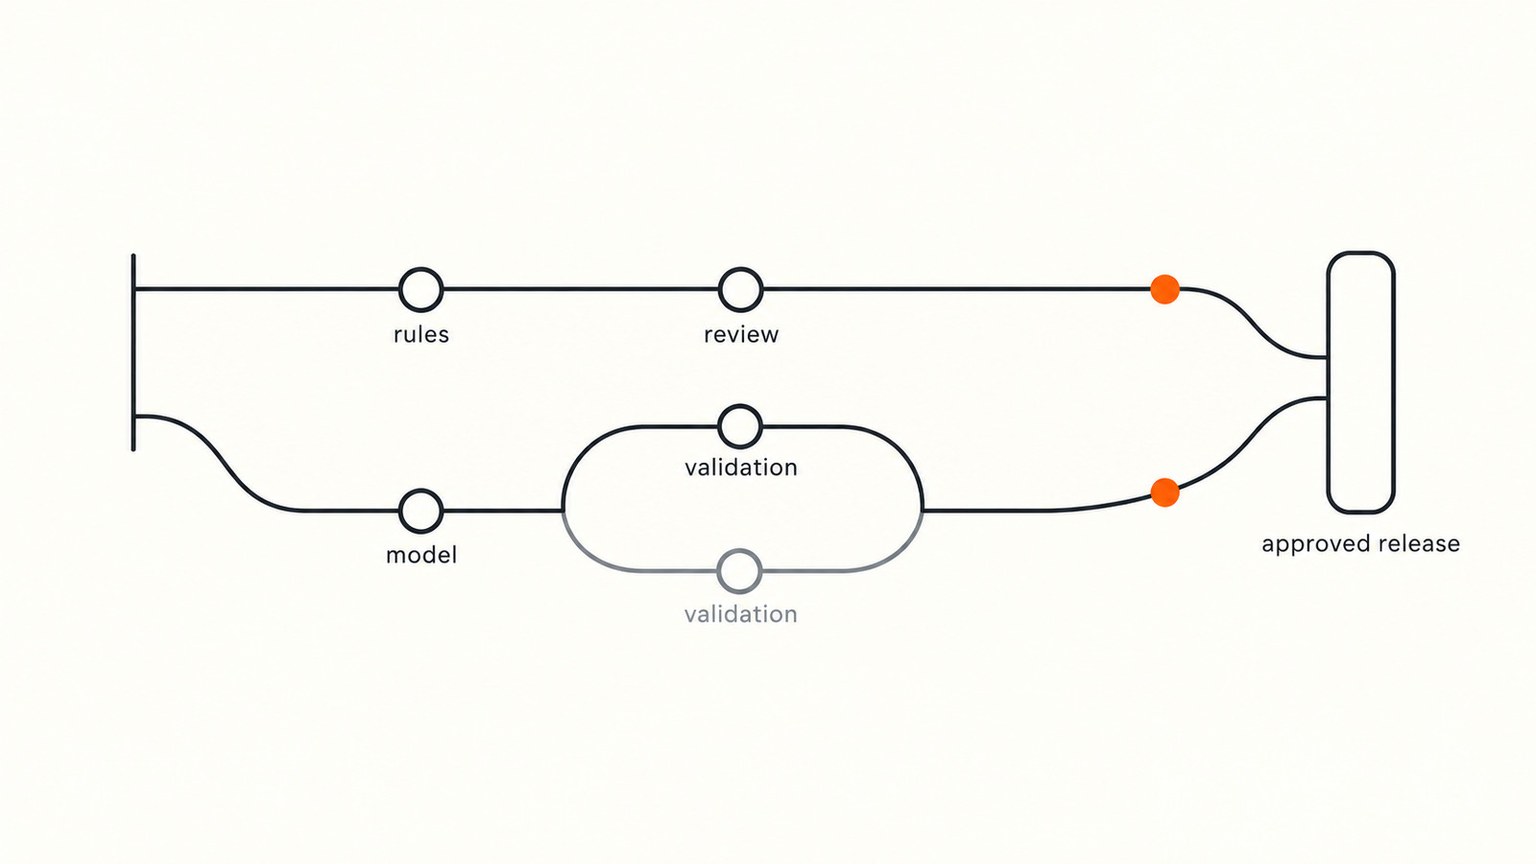
Kurzfassung: Für Matching, das Kundendatensätze verändert, erreicht ein regelbasierter Ansatz meist zuerst ein validiertes Produktiv-Release. Machine Learning liefert oft schneller ein erstes Ergebnis, doch jede gelernte Verknüpfung muss danach erklärt, validiert und nach jeder Modelländerung erneut validiert werden. Mit Tilores betreiben wir regelbasiertes Matching und speichern die Regel hinter jeder Verknüpfung; Validierung und Freigabe bleiben bei der Bank.
Demo buchen · Tilores Studio kostenlos testen
Auf dieser Seite
- Welcher Matching-Ansatz erreicht zuerst ein validiertes Release?
- Welche drei Matching-Ansätze gibt es, und worin unterscheiden sie sich?
- Was braucht ein Modellrisikokomitee, bevor es ein Matching-Release freigibt?
- Wie viel Regelarbeit verlangt ein regelbasierter Ansatz tatsächlich?
- Wo hilft Machine Learning, ohne die Entscheidung zu treffen?
- Wo passt Tilores in ein regelbasiertes Release?
- Wie schneiden die Ansätze bei der Zeit bis zur Freigabe ab?
- Welchen Ansatz sollte Ihre Bank wählen?
- Häufige Fragen
- Quellen
Zwei Proofs of Concept enden am selben Freitag. Ein Anbieter zeigt eine hohe Precision aus einem Modell, das auf der Stichprobe der Bank trainiert wurde. Der andere zeigt eine niedrigere Kennzahl, doch neben jeder Verknüpfung steht die Regel, die sie erzeugt hat: gleiches Geburtsdatum, Nachname mit höchstens einer Zeichenabweichung, Postleitzahl nach der Normalisierung gleich.
Das Modellrisikokomitee tagt einmal im Quartal, und seine Unterlagen schließen Wochen vor jeder Sitzung. Welchen der beiden Ansätze kann es beim nächsten Mal freigeben? Meist den zweiten, und die Treffsicherheit ist nicht der Grund. Der Grund ist die Arbeit zwischen einem ersten Ergebnis und einem freigegebenen Release.
Zählen Sie diese Arbeit also vor der Wahl: Regeln, die zu schreiben sind, Paare, die zu labeln sind, Dokumente, die zu erstellen sind, und die Kosten jeder späteren Änderung.
Welcher Matching-Ansatz erreicht zuerst ein validiertes Release?
Für Verknüpfungen, die einen Kundendatensatz verändern, erreicht eine regelbasierte Konfiguration, die aus den eigenen gelabelten Paaren der Bank entsteht, meist zuerst ein freigegebenes Release. Machine Learning verdient seinen Platz neben den Regeln: Es schlägt Kandidaten vor und ordnet die Prüfwarteschlange, ohne über die Verknüpfung zu entscheiden.
Zeit bis zum ersten Match und Zeit bis zur Freigabe sind zwei verschiedene Uhren. Ein gelernter Matcher verkürzt die erste: keine Regeln zu schreiben, nur gelabelte Paare zum Trainieren. Er verlängert die zweite, denn ein Validierer muss eine gelernte Entscheidung verstehen, sie an Fällen testen, die das Modell nie gesehen hat, ihre Trainingsdaten zurückverfolgen und sie nach jedem Retraining erneut testen. Regeln verlagern den Aufwand nach vorn, und ihr Inventar, die Begründung je Verknüpfung und das Änderungsprotokoll ergeben sich aus der Konfiguration selbst.
Messen Sie bei Datensätzen, die einen Kunden verändern, deshalb die Zeit bis zur validierten Produktion, nicht die Zeit bis zum ersten Match. Wir sagen meist, nicht immer: Ein Proof of Concept kann die Aussage an den Daten der Bank prüfen.
Welche drei Matching-Ansätze gibt es, und worin unterscheiden sie sich?
- Regelbasiertes Matching. Benannte Regeln kombinieren deterministische Vergleiche, bei denen Werte wie ein Geburtsdatum übereinstimmen müssen, mit Fuzzy-Vergleichen, die Varianten in Schreibweise, Klang und Format tolerieren, etwa Katharina und Katarina. Auch ein Fuzzy-Vergleich ist ein fester Test, wie unser Leitfaden zu Fuzzy-Matching-Verfahren erklärt. Der Name der Regel ist die Erklärung der Verknüpfung.
- Gelerntes Scoring. Probabilistisches Record Linkage gewichtet die Übereinstimmung über viele Felder mit Gewichten, die aus Daten geschätzt werden. Diesen Rahmen legten Fellegi und Sunter 1969 vor, mit drei Ergebnissen: Link, möglicher Link und Non-Link, wie der Überblick von Binette und Steorts zu Entity Resolution beschreibt. Überwachtes Machine Learning trainiert einen Klassifikator auf gelabelten Paaren. Ein Schwellenwert macht aus dem Score eine Entscheidung.
- Ein LLM-gestützter Schritt. Ein Sprachmodell beurteilt, ob zwei Datensätze dieselbe Person beschreiben. Unser Artikel zu LLMs für Entity Resolution zeigt, wo das scheitert.
Fuzzy und probabilistisch sind verschiedene Methoden. Ein Fuzzy-Vergleich misst, wie ähnlich zwei Werte sind; ein probabilistischer Score schätzt, wie wahrscheinlich zwei Datensätze eine Entität sind. Eine regelbasierte Engine kann Fuzzy-Vergleiche nutzen und trotzdem deterministisch bleiben.
Was braucht ein Modellrisikokomitee, bevor es ein Matching-Release freigibt?
Es braucht Belege, dass die Methode funktioniert, eine Aufzeichnung jeder Entscheidung und Kontrolle über Änderungen. Wie viel davon, hängt davon ab, ob die Methode als Modell gilt, und die Aufsicht zieht diese Grenze nahe dort, wo feste Regeln enden und statistische Schätzung beginnt.
Vereinigtes Königreich: PRA SS1/23
Das Supervisory Statement SS1/23 der PRA gilt seit dem 17. Mai 2024 und wurde zuletzt am 16. April 2026 aktualisiert. Es richtet sich an im Vereinigten Königreich gegründete Banken, Building Societies und von der PRA benannte Wertpapierfirmen mit Genehmigung interner Modelle für das regulatorische Kapital. Seine Modelldefinition erfasst Methoden, die statistische, ökonomische, finanzielle oder mathematische Theorien, Techniken und Annahmen anwenden, um Eingabedaten zu Ergebnissen zu verarbeiten. Für wesentliche und komplexe deterministische Methoden, etwa entscheidungsbasierte Regeln oder Algorithmen, die nicht als Modelle eingestuft sind, sollen Firmen prüfen, ob sie die relevanten Teile des MRM-Rahmens anwenden; andernfalls brauchen sie solide und klar dokumentierte Kontrollen. Nach Principle 3.3 vergleicht der Test einer wesentlichen Modelländerung die Ergebnisse vor und nach der Änderung.
Vereinigte Staaten: SR 26-2
Am 17. April 2026 veröffentlichten die Federal Reserve, das OCC und die FDIC SR 26-2, die überarbeitete Leitlinie zum Modellrisikomanagement. Sie ersetzt SR 11-7 und SR 21-8, die Erklärung von 2021 zu Modellen in Systemen nach dem Bank Secrecy Act und zur Geldwäschebekämpfung. Am relevantesten ist sie für Bankorganisationen mit mehr als 30 Milliarden US-Dollar an Vermögenswerten.
Die überarbeitete Leitlinie definiert ein Modell als komplexe quantitative Methode, die statistische, ökonomische oder finanzielle Theorien anwendet, um Eingabedaten zu quantitativen Schätzungen zu verarbeiten. Ausgenommen sind deterministische regelbasierte Prozesse und Software, deren Gestaltung oder Nutzung keine solchen Theorien zugrunde liegen. Nach diesem Wortlaut scheint ein deterministisches Regelwerk für das Matching außerhalb der Definition zu liegen, ein probabilistischer oder gelernter Match-Score, der auf statistischer Theorie beruht, dagegen innerhalb. Die Validierung erfolgt in der Regel vor dem ersten Einsatz eines Modells, und bei Anbieterprodukten erhält eine Bank womöglich weder den zugrunde liegenden Code noch die Daten oder die Methodik.
Europäische Union: EBA und AMLR
Kein einzelner EU-Text regelt das Modellrisiko einer Matching-Engine außerhalb des regulatorischen Kapitals, doch zwei Quellen prägen, was ein Validierer fragt. Der Folgebericht der EBA vom August 2023 zu Machine Learning für IRB-Modelle hält fest, dass höhere Komplexität die Modellleistung verbessern kann, aber auf Kosten geringerer Erklärbarkeit. Ab dem 10. Juli 2027 verlangt Artikel 76 Absatz 5 der Geldwäscheverordnung (AMLR), dass Entscheidungen aus automatisierten Verfahren über Aufnahme oder Verweigerung einer Geschäftsbeziehung oder über den Umfang der Sorgfaltsmaßnahmen „einem sinnvollen menschlichen Eingreifen unterliegen“; der Kunde kann „eine Erklärung zu der vom Verpflichteten getroffenen Entscheidung erhalten“. Artikel 21 Absatz 3 verlangt Aufzeichnungen über Sorgfaltsentscheidungen samt Belegen und Begründungen.
Deutschland: MaRisk AT 4.3.4
Für Institute, die nicht direkt von der EZB beaufsichtigt werden, gelten die MaRisk der BaFin in der Fassung vom 30. Juni 2026 (Rundschreiben 06/2026). Modul AT 4.3.4 erfasst Modelle in den dort geregelten Prozessen, ausdrücklich auch automatisierte Modelle und künstliche Intelligenz. Ein Modell ist dort eine Methode, die statistische oder mathematische Theorien, Techniken und Annahmen anwendet, um Eingabedaten zu quantitativen Schätzungen zu verarbeiten. Die Eignung ist vor dem Einsatz zu bewerten, und neben der angestrebten Genauigkeit ist auf hinreichende Erklärbarkeit zu achten, besonders bei KI.
Was gehört in das Validierungspaket?
Die Einstufung ist Sache der Bank. Keiner dieser Texte nimmt Regeln von der Governance aus; gelernte Scores tragen mehr davon.
Was jeder Ansatz in das Validierungspaket einbringt
| Nachweis | Regelbasiert | Gelerntes Scoring |
|---|---|---|
| Methodenbeschreibung | Regelinventar: jede Regel, ihre Felder und Vergleiche | Modelldokumentation: Merkmale, Trainingsmethode, Annahmen |
| Gelabelte Daten | Geprüfte Paare, um Precision und Recall zu testen | Trainingspaare plus ein separates, zurückgehaltenes Testset |
| Begründung je Verknüpfung | Die an der Verknüpfung gespeicherte Regel-ID | Ein Score plus eine Attributionsmethode, etwa Shapley-Werte |
| Entwicklungsdaten | Die eigene Stichprobe der Bank | Oft auch Anbieter- oder gepoolte Daten |
| Änderungskontrolle | Eine versionierte Regeländerung, vorher und nachher getestet | Retraining, danach eine Bewertung als wesentliche Änderung |
| Monitoring | Trefferquoten der Regeln und Prüfergebnisse | Score-Drift und Kalibrierung |
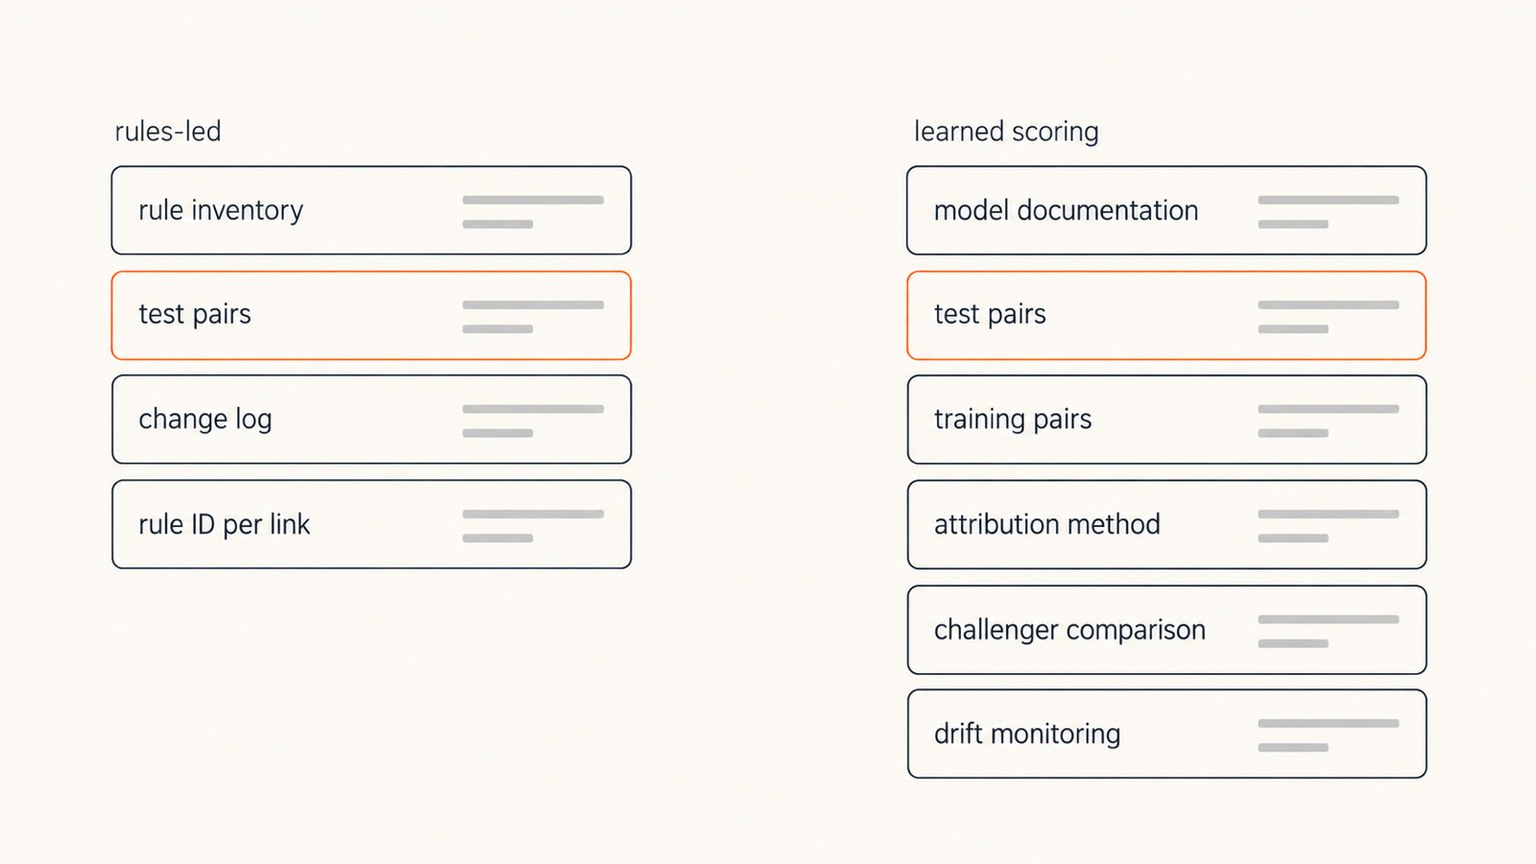
Die Zeile zu gelabelten Daten entscheidet über die meisten Zeitpläne. Beide Ansätze brauchen geprüfte Testpaare; nur der gelernte braucht zusätzlich ein zweites, größeres Trainingsset, das von ihnen getrennt bleibt. Weil nur sehr wenige Datensatzpaare übereinstimmen, brauchen vollständig überwachte Verfahren laut Binette und Steorts große Mengen verlässlicher oder sorgfältig ausgewählter Trainingsdaten. Wie Sie diese Menge bemessen, zeigt unser Leitfaden zu Genauigkeitsmetriken für Entity Resolution.
Neue Beiträge zu Entity Resolution, Identitätsdaten und KI. Kein Spam, Abmeldung jederzeit möglich.
Wie viel Regelarbeit verlangt ein regelbasierter Ansatz tatsächlich?
Mehr, als eine Demo vermuten lässt, und weniger, als eine Bank befürchtet, solange der Fachbereich nie Fuzzy-Logik schreiben muss. Bewährt hat sich der Ablauf Vorschlagen, Antworten, Umsetzen: Der Anbieter schlägt aus der Stichprobe der Bank ein erstes Regelwerk vor, der Fachbereich beantwortet konkrete Grenzfälle mit Ja, Nein oder Eskalieren und begründet die Antwort, und der Anbieter setzt die Antworten in Regeln um, über mindestens zwei Runden. Unser Artikel zur Einigung auf Matching-Regeln vor einem PoC beschreibt die Runden.
Das Nebenprodukt zählt für die Validierung: Jeder beantwortete Grenzfall ist ein gelabeltes Paar, das eine Regel formt und zu einem Testfall wird, den der Validierer erneut ausführen kann. Die Nachweise entstehen, während die Regeln geschrieben werden, und die Entwicklungsdaten sind die eigenen der Bank. Das schließt die Lücke bei Anbieterdaten, die SR 26-2 beschreibt.
Wo hilft Machine Learning, ohne die Entscheidung zu treffen?
Machine Learning hilft am meisten dort, wo sein Ergebnis ein Vorschlag ist, auf den eine Regel oder ein Mensch reagiert.
- Kandidatenauswahl. Ein gelernter Schritt wählt aus, welche Paare zum Vergleich gelangen. Seine Fehler sind verpasste Vergleiche, die ein Test des Kandidaten-Recalls aufdeckt, keine falschen Zusammenführungen.
- Reihenfolge der Prüfwarteschlange. Ein Score entscheidet, welchen mehrdeutigen Fall ein Prüfer zuerst sieht; siehe unseren Leitfaden zu Review Queues für mehrdeutige Matches.
- Regelvorschläge. Muster in den Antworten der Prüfer schlagen eine Regel vor, die ein Mensch annimmt und die mit eigener ID in das Inventar eingeht.
Diese Rollen verändern für sich genommen keinen Kundendatensatz. SR 26-2 hält fest, dass Zweck und Exposition eines Modells gemeinsam seine Wesentlichkeit bestimmen. Ein Modell, das eine Warteschlange ordnet, kann trotzdem im Inventar stehen, auf einer niedrigeren Stufe als eines, das Kunden zusammenführt.
Wo passt Tilores in ein regelbasiertes Release?
Wir bauen eine regelbasierte Matching-Engine: Deterministische Regeln und Fuzzy-Matching ziehen nachvollziehbare Kanten zwischen Datensätzen, wie unsere Produktseite beschreibt. Probabilistisches Scoring bieten wir zusätzlich an.
- Jede gespeicherte Verknüpfung trägt ihre Regel. Wir speichern jede Kante als Datensatz A, Datensatz B und Regelbezeichnung, wie unsere Regeldokumentation zeigt, und unsere GraphQL-API liefert die Datensätze und Kanten einer Entität. So kann ein Validierer Verknüpfungen stichprobenartig ziehen und jede Regel lesen.
- Änderungen werden vor dem Release getestet.
submitWithPreviewmitdryRunauf true zeigt, wie sich Entitäten bilden würden, ohne etwas zu übernehmen. So lässt sich eine Regeländerung auf zurückgehaltenen Paaren vorher und nachher vergleichen. - Konflikte stoppen Zusammenführungen. Unsere Konsistenzregeln können verlangen, dass ein Identifikator innerhalb einer Entität eindeutig ist. Die Funktion ist als neu gekennzeichnet; testen Sie sie daher an Ihren Grenzfällen.
- Schwache Verbindungen können auf einen Menschen warten. Seit unserem Release vom 23. Oktober 2026 kann ein schwach passender Datensatz getrennt bleiben, während sein Prüffall die Kandidaten-Entität aufführt.
Dasselbe Regelwerk läuft im Proof of Concept und in der Produktion. Unsere Plattform für Finanzdienstleister (englischsprachige Seite) protokolliert jede Abfrage und jede Löschung, und das Deployment reicht von unserer Managed Cloud auf AWS bis on-premise. Mit Tilores Studio betreiben Sie unsere Engine lokal mit bis zu 100.000 Datensätzen, kostenlos.
Bei der Bank bleiben: die Einstufung des Regelwerks nach ihrer eigenen Richtlinie, Validierung und Freigabe, Schwellenwert- und Prüfrichtlinien sowie jede Entscheidung, die den aufgelösten Kunden nutzt, einschließlich Sorgfaltspflichten, Risikoeinstufungen, Ergebnissen des Sanktions-, PEP- und Adverse-Media-Screenings sowie Meldungen. Wir validieren nicht im Namen der Bank, und die Freigabe bleibt beim Komitee der Bank.
Wie schneiden die Ansätze bei der Zeit bis zur Freigabe ab?
Die letzte Spalte beschreibt eine Tendenz; Ihre Daten können sie umkehren.
Kriterien, die über die Zeit bis zur Freigabe entscheiden
| Kriterium | Was Sie im PoC messen | Begünstigt meist |
|---|---|---|
| Zu schreibende Regeln | Runden, bis Grenzfälle die Regeln nicht mehr ändern | Gelerntes Scoring |
| Gelabelte Paare | Geprüfte Paare, die für Training und Test nötig sind | Regelbasiert |
| Erstes Ergebnis | Tage vom Datenempfang bis zum ersten bewerteten Lauf | Gelerntes Scoring |
| Begründung je Verknüpfung | Anteil der Stichproben-Verknüpfungen mit prüfbarer Begründung | Regelbasiert |
| Entwicklungsdaten | Ob alle Daten aus der Bank selbst stammen | Regelbasiert |
| Änderungskontrolle | Schritte, um eine Änderung zu testen und freizugeben | Regelbasiert |
| Kandidaten-Recall | Echte Paare, die den Vergleich erreicht haben | Beide möglich; testen Sie beide |
Ein Szenario zeigt, wie Aufwand für das Paket zu Kalenderzeit wird. Die Zahlen sind Annahmen, keine Messergebnisse: Beide PoCs enden in Woche 0; das Komitee tagt alle 13 Wochen, das nächste Mal in Woche 9; die Unterlagen schließen vier Wochen vorher, in Woche 5. Das regelbasierte Paket dauert vier Wochen. Das gelernte dauert sieben, weil Modelldokumentation, Herkunftsnachweis der Trainingsdaten, eine Attributionsmethode und ein Challenger-Vergleich hinzukommen.
Das regelbasierte Paket ist in Woche 4 fertig und kann in Woche 9 freigegeben werden. Das gelernte Paket verpasst die Frist in Woche 5; die nächsten Unterlagen schließen in Woche 18 für Woche 22: 22 minus 9 ergibt 13 Wochen später. Drei Wochen Mehrarbeit werden zu 13 Wochen Kalenderzeit, weil Freigabetermine Stufen sind. Behandeln die Validierer das Regelwerk als Modell, schrumpft der Abstand.
So messen Sie die Zeit bis zur Freigabe in Ihrem PoC
- Die Uhr festlegen. Messen Sie vom Datenempfang bis zur Komiteesitzung, in der das Release freigegeben werden könnte.
- Testpaare zurückhalten. Legen Sie geprüfte Paare beiseite, die kein Anbieter beim Tuning oder Training sieht.
- Das Paket anfordern. Fordern Sie am Ende des PoC von jedem Anbieter die Nachweise an, die Ihre Validierer brauchen, und halten Sie fest, was fehlt.
- Eine Änderung messen. Nehmen Sie eine Regel- oder Modelländerung vor und messen Sie, wie lange Test, Dokumentation und Freigabe dauern.
- Begründungen prüfen. Wählen Sie zufällig Verknüpfungen aus und fragen Sie nach der Begründung für jede, in Worten, die ein Prüfer nachvollziehen kann.
Welchen Ansatz sollte Ihre Bank wählen?
Wählen Sie nach der strengsten Erklärungsanforderung unter den Verwendungen, die die Engine bedienen soll, denn ein aufgelöster Kunde speist meist mehrere Systeme.
- Verknüpfungen, die Sorgfaltsakten zusammenführen, das Sanktions-, PEP- und Adverse-Media-Screening gegen Listen wie OpenSanctions speisen oder einen Auskunftsantrag beantworten: regelbasiert, mit Unterstützung durch Machine Learning.
- Ermittlungshinweise, die ein Analyst vor jeder Maßnahme prüft: gemischt, mit einem gelernten Score, der Hinweise ordnet, und Regeln, die über gespeicherte Verknüpfungen entscheiden.
- Deduplizierung auf Marketingniveau, bei der eine falsche Verknüpfung wenig kostet: Hier kann gelerntes Scoring durchaus zuerst produktiv gehen. Dieser Gegenfall ist real.
Wie Sie jedes Entscheidungsband verteidigen, zeigt unser Leitfaden zu Konfidenzwerten, Schwellen und Audit-Trails. Messen Sie die Zeit bis zur Freigabe an Ihren eigenen Daten, und wo die Verknüpfung einen Kundendatensatz verändert, wählen Sie regelbasiert und lassen Sie Machine Learning helfen.
Häufige Fragen
Gilt SR 11-7 noch für US-Banken?
Nein. Am 17. April 2026 veröffentlichten die Federal Reserve, das OCC und die FDIC SR 26-2, die überarbeitete Leitlinie zum Modellrisikomanagement, die SR 11-7 und SR 21-8 ersetzt.
Kann eine Bank mit Regeln beginnen und Machine Learning später ergänzen?
Ja. Gelernte Schritte für Kandidatenauswahl, Prüfreihenfolge oder Regelvorschläge können nach dem ersten Release folgen. Entscheidet ein gelernter Score später über Verknüpfungen, rechnen Sie mit einem größeren Validierungsumfang.
Ist LLM-basiertes Matching eine Abkürzung in die Produktion?
Selten, wenn Verknüpfungen Kundendatensätze verändern. SR 26-2 nimmt generative und agentische KI aus ihrem Anwendungsbereich aus und überlässt deren Governance den eigenen Verfahren der Bank. Das ist kein leichterer Weg.
Validiert Tilores das Matching im Namen der Bank?
Nein. Wir liefern als Nachweis die Regel hinter jeder Verknüpfung, Dry-Run-Vorschauen von Änderungen sowie protokollierte Abfragen und Löschungen. Modelleinstufung, Validierung, Freigabe und jede Entscheidung, die den aufgelösten Kunden nutzt, bleiben bei der Bank.
Quellen
- SR 26-2: Revised Guidance on Model Risk Management, 17 April 2026, Board of Governors of the Federal Reserve System, englischsprachig (abgerufen am 1. November 2026).
- Revised Guidance on Model Risk Management (attachment to SR 26-2), Federal Reserve, OCC und FDIC, englischsprachig (abgerufen am 1. November 2026).
- Supervisory Statement SS1/23: Model risk management principles for banks, April 2026 (updating 17 May 2023), Prudential Regulation Authority, Bank of England, englischsprachig (abgerufen am 1. November 2026).
- SS1/23 Model risk management principles for banks: publication page and version history, Prudential Regulation Authority, Bank of England, englischsprachig (abgerufen am 1. November 2026).
- Follow-up report on machine learning for IRB models, EBA/REP/2023/28, August 2023, Europäische Bankenaufsichtsbehörde (EBA), englischsprachig (abgerufen am 1. November 2026).
- Verordnung (EU) 2024/1624 (Geldwäscheverordnung, AMLR), Artikel 21 und 76, EUR-Lex, Amt für Veröffentlichungen der Europäischen Union (abgerufen am 1. November 2026).
- Rundschreiben 06/2026 (BA): Mindestanforderungen an das Risikomanagement (MaRisk), Stand 30. Juni 2026, Bundesanstalt für Finanzdienstleistungsaufsicht (BaFin) (abgerufen am 1. November 2026).
- Binette and Steorts, (Almost) All of Entity Resolution, Science Advances 8 (2022); arXiv:2008.04443, Duke University, englischsprachig (abgerufen am 1. November 2026).
- OpenSanctions, OpenSanctions (abgerufen am 1. November 2026).
- Rules Configuration, Tilores-Dokumentation, englischsprachig (abgerufen am 1. November 2026).
- GraphQL API Reference, Tilores-Dokumentation, englischsprachig (abgerufen am 1. November 2026).
- Consistency, Tilores-Dokumentation, englischsprachig (abgerufen am 1. November 2026).
- Release Notes, v0.100.0, 23 October 2026, Tilores-Dokumentation, englischsprachig (abgerufen am 1. November 2026).
- Tilores Produkt: Entity-Resolution-Infrastruktur, Tilores (abgerufen am 1. November 2026).
- Tilores Product: Entity Resolution Infrastructure, Tilores, englischsprachig (abgerufen am 1. November 2026).
- Entity Resolution for Financial Services, Tilores, englischsprachig (abgerufen am 1. November 2026).
- Deployment-Optionen, Tilores (abgerufen am 1. November 2026).
- Tilores Studio herunterladen, Tilores (abgerufen am 1. November 2026).
- Fuzzy Matching erklärt: Verfahren, Grenzen und wann es nicht ausreicht, Tilores (abgerufen am 1. November 2026).
- Können LLMs für Entity Resolution eingesetzt werden?, Tilores (abgerufen am 1. November 2026).
- Wie eine Bank und ihr Entity-Resolution-Anbieter sich vor einem PoC auf Matching-Regeln einigen, Tilores (abgerufen am 1. November 2026).
- Wie misst eine Bank die Genauigkeit von Entity Resolution 2026? Paarweise Präzision, Cluster-Metriken und die Zielwerte für den PoC, Tilores (abgerufen am 1. November 2026).
- Review Queues für Entity Resolution: Menschliche Entscheidungen bei mehrdeutigen Matches im Jahr 2026, Tilores (abgerufen am 1. November 2026).
- Erklärbare Entity Resolution: Konfidenzwerte, Match-Schwellen und Audit-Trails (2026), Tilores (abgerufen am 1. November 2026).
- A £160K Sanctions Miss: How to Test Entity Resolution on Your Own Data Before You Buy, Schmitdy Gadget, YouTube, 2026 (englischsprachig).
Sehen Sie, was aufgelöste Entitätsdaten für Ihr Unternehmen — und Ihre KI — leisten.