Kann eine Bank den Databricks-Accelerator für Entity Resolution 2026 produktiv einsetzen? Lizenz, Support und die Lücke bis zum Produktivsystem

Kurzfassung: Nein, nicht so, wie er ausgeliefert wird. Der Databricks-Accelerator für Entity Resolution ist ein Prototyp: Notebooks aus einer Reihe, die Databricks als Lehrmaterial beschrieben hat, unter einer Lizenz „wie besehen“, ohne Support-Bedingungen und auf einer Runtime nach Support-Ende. Eine Bank kann daraus lernen, doch für den Produktivbetrieb muss sie Lizenzprüfung, Support und acht Produktionsschichten selbst tragen.
Demo buchen · Tilores Studio kostenlos testen
Auf dieser Seite
- Kann eine Bank den Accelerator so, wie er ausgeliefert wird, produktiv einsetzen?
- Darf die Bank darauf aufbauen?
- Wen ruft die Bank an, wenn etwas ausfällt?
- Was muss die Bank am Ende selbst verantworten?
- Warum hängt der Business Case an Menschen und nicht an Rechenleistung?
- Wer soll die Schichten tragen: Ihr Team, die kommerzielle Edition der Bibliothek oder eine Matching-Engine?
- Welche Schritte führen eine Bank zu einer Go-oder-No-Go-Entscheidung?
- Häufig gestellte Fragen
- Quellen
Der Job, den der Databricks-Accelerator für Entity Resolution anlegt, läuft auf Databricks Runtime 12.2 LTS, deren Support am 1. März 2026 endete. Laut Databricks können Workloads auf nicht mehr unterstützten Runtimes weiterlaufen, aber „Databricks doesn’t provide support or fixes.“ Die Notebooks sind dafür gebaut, gematchte Datensätze auf einem Beispieldatensatz zu zeigen, und mit dieser Demo geht ein Plattform-Team ins Steering Committee.
Dann stellt das Committee die Frage, die über das Projekt entscheidet: Kann das in der Bank produktiv laufen? Die Demo beantwortet sie nicht. Die Antwort steht in Dateien, die keine Demo öffnet: im Lizenztext, in den Drittanbieter-Lizenzen der README, in der Runtime, die der Job festschreibt, und in den Notebook-Kommentaren dazu, was noch zu bauen ist.
Wer diese Dateien liest, stellt eine andere Frage. Es geht nicht mehr darum, ob das Modell matcht, sondern darum, wer alles drumherum verantwortet. Für eine Bank liegen genau dort Kosten und Risiko.
Kann eine Bank den Accelerator so, wie er ausgeliefert wird, produktiv einsetzen?
Nein. So, wie er ausgeliefert wird, ist der Accelerator ein Prototyp, und zwar ein guter. Er ist das Repository customer-er auf GitHub: fünf Python-Notebooks, ein RUNME-Notebook, das einen mehrstufigen Job anlegt, und eine Setup-Datei. Er trainiert ein Zingg-Modell auf Datensatzpaaren, die eine Person in Notebook-Widgets labelt, und verknüpft und matcht neue Datensätze anschließend im Batch. Databricks hat ihn am 4. August 2022 als ML-basiertes Customer 360 mit Zingg vorgestellt, mit Personalisierung im Einzelhandel als Anwendungsfall.
Die Bibliothek darin ist leistungsfähig. Zingg lernt ein eigenes Blocking-Modell, trainiert mit wenigen gelabelten Paaren und hat im eigenen Test 9 Millionen Datensätze mit drei Feldern in 45 Minuten gematcht, auf einer einzigen AWS-Maschine mit 96 Kernen.
Was eine Demo damit beweisen kann, ist eng begrenzt. Sie läuft auf dem Benchmark North Carolina Voters 5M: echte Datensätze aus dem Wählerverzeichnis mit synthetischen Dubletten, in vier Feldern (Vorname, Nachname, Ortsteil, Postleitzahl). Es gibt kein Geburtsdatum und keine nationale Kennung. Ein Ergebnis auf dieser Datei ist ein Ergebnis auf einer Benchmark-Datei, nicht auf Bankdaten, und zeigt nicht, wie die Pipeline mit den Kunden einer Bank umgehen würde. Für die Batch-Deduplizierung nicht regulierter Analysedaten ist das ein tragfähiger Anfang. Für ein Produktivsystem in einer Bank kommen danach die entscheidenden Fragen, und die erste lautet, ob die Bank überhaupt auf dem Code aufbauen darf.
Darf die Bank darauf aufbauen?
Nur innerhalb eines Vertrags mit Databricks, und beim wichtigsten Punkt, der Änderung, widersprechen sich die beiden veröffentlichten Lizenztexte. Wer Notebooks zu einer Produktionspipeline macht, ändert sie. Das muss die Rechtsabteilung deshalb als Erstes klären.
Die LICENSE-Datei des Repositorys von 2022 erlaubt die Nutzung nur im Zusammenhang mit den Databricks Platform Services auf Grundlage eines Vertrags, gibt keine Gewährleistung und behandelt die Software als vertrauliche Information von Databricks. Der Lizenznehmer darf sie ansehen, in begrenztem Umfang kopieren und kompilieren, ohne gesonderte Bedingungen aber keine abgeleiteten Werke (derivative works) erstellen. Die Lizenz endet mit dem Vertrag oder bei Verstoß, oder jederzeit auf Mitteilung von Databricks.
Die README und die Fußzeilen der Notebooks verweisen woandershin: auf databricks.com/db-license-source, das inzwischen auf die DB-Lizenz weiterleitet. Dieser Text erlaubt Kopieren und Ändern allein für die Nutzung innerhalb von Databricks-Diensten oder in Verbindung mit ihnen und begrenzt die Haftung von Databricks auf eintausend US-Dollar. Eine Produktionspipeline ist nach beiden Lesarten eine Änderung. Die Bank braucht also schriftlich von Databricks, welcher Text gilt.
Die Bibliothek darunter hat eigene Bedingungen. Die README führt Zingg unter der GNU Affero General Public License v3.0. Zinggs eigene README sagt, die AGPL erlaube Endanwendern, Lösungsbauern und Partnern die uneingeschränkte Nutzung, und bietet auf Anfrage eine andere Lizenz an. Abschnitt 13 der AGPL besagt: Wer das Programm verändert, muss Nutzern, die über ein Netzwerk aus der Ferne damit interagieren, die Möglichkeit geben, den Quellcode zu erhalten. Ob die interne Nutzung einer Bank das auslöst, klärt deren Open-Source-Prüfung, bevor jemand Zingg verändert.
Zwei kleinere Punkte gehören in dieselbe rechtliche Prüfung. Die NOTICE-Datei hält die Einwilligung fest, dass Databricks Nutzungs- und Tracking-Informationen erhebt, und laut Zinggs Sicherheitshinweis sendet Zingg Nutzungsmetriken an Google Analytics, ohne Eingabe- oder Ausgabedaten. Keiner der beiden Punkte stoppt ein Projekt, aber beide gehören in die Datenschutzprüfung. Und angenommen, die Rechtsabteilung gibt alles frei: Dann folgt die Frage, die der Betrieb stellt, wenn der Job zum ersten Mal ausfällt.
Wen ruft die Bank an, wenn etwas ausfällt?
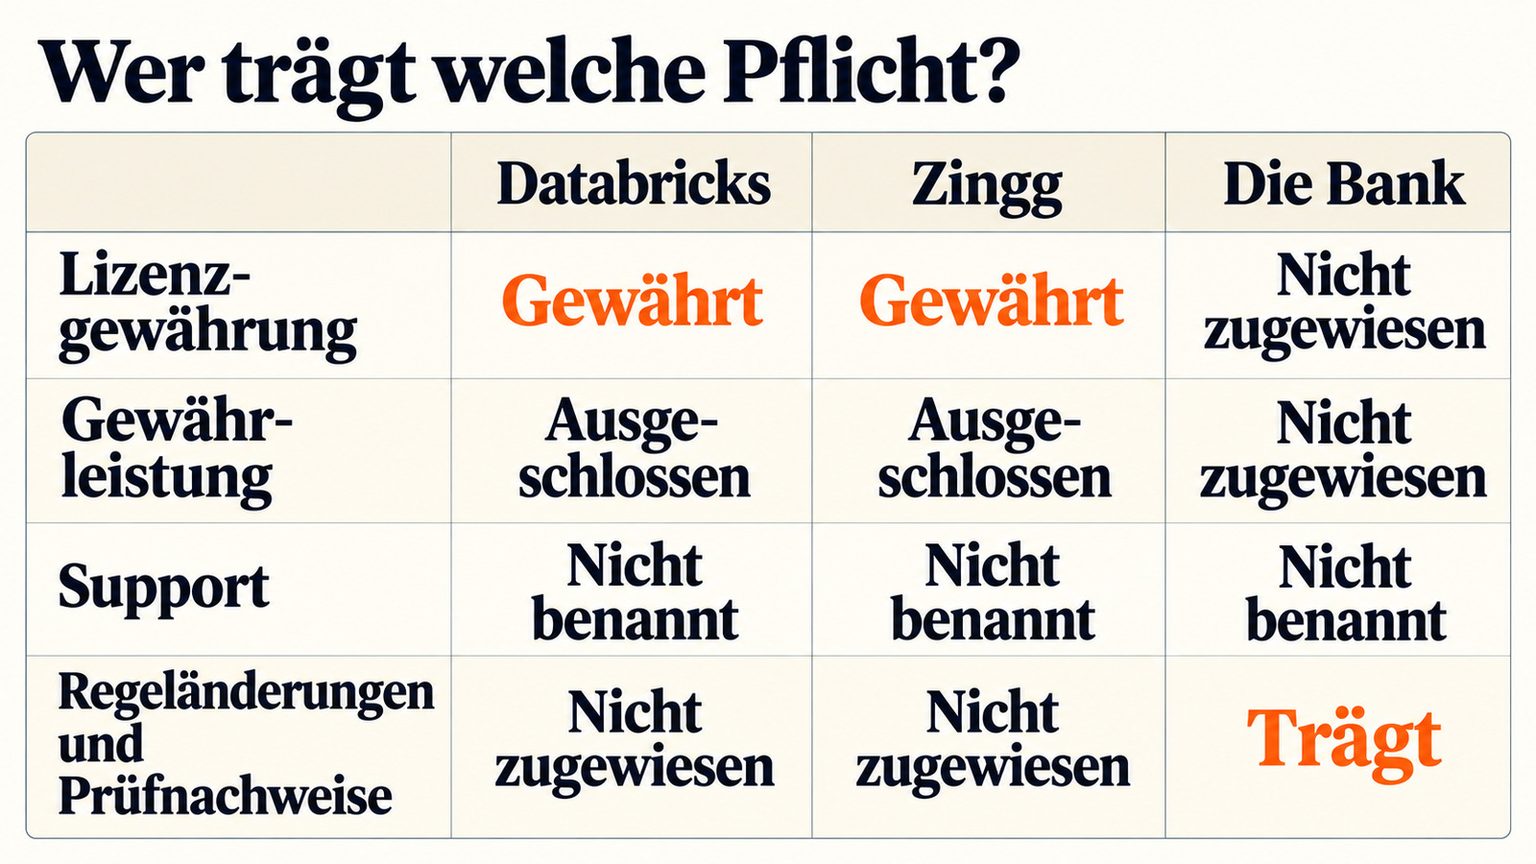
Niemanden, der benannt wäre. Weder das Repository noch die Seite des Accelerators bei Databricks nennt eine Support-Zusage. Im Oktober 2022 beschrieb Databricks seine Solution Accelerators als verfügbar „with minimal support“ und „not meant to be used as off the shelf products“. Das ist eine faire Zweckbeschreibung und kein Mangel. Es bedeutet aber, dass eine Bank, die damit live geht, ihr eigener Support wird.
Die Historie des Repositorys zeigt, was dieser Support erben würde. Der letzte Commit stammt vom 23. Oktober 2023. Alle drei jemals eröffneten Issues sind noch offen: ein fehlgeschlagener Daten-Download (August 2022), nicht verfügbare Quelldaten (März 2023) und ein Trainingsjob mit internem Fehler (März 2024). Auf die letzten beiden gibt es keine Antwort.
Dazu kommt die Runtime vom Anfang. Databricks nennt den 1. März 2026 als Support-Ende für Runtime 12.2 LTS, und nach seinem Support-Lebenszyklus gibt es ab diesem Datum weder Support noch Fixes. Der Job lädt außerdem das Zingg-Release vom 4. August 2022, während Zingg am 10. August 2026 die Version 0.7.0 veröffentlicht hat. Eine Bank kann beides portieren, denn Zingg dokumentiert den Betrieb der Community-Version auf Databricks, verantwortet dann aber die Portierung.
Ob der Plattform-Support von Databricks angepasste Notebooks oder die Zingg-Bibliothek abdeckt, steht nirgends. Holen Sie das schriftlich ein. Die Editionstabelle von Zingg nennt Open-Source-Support für Community und Support auf Enterprise-Niveau für die proprietären Editionen. Das ist ein Weg, dem Support einen Namen zu geben.
Neue Beiträge zu Entity Resolution, Identitätsdaten und KI. Kein Spam, Abmeldung jederzeit möglich.
Was muss die Bank am Ende selbst verantworten?
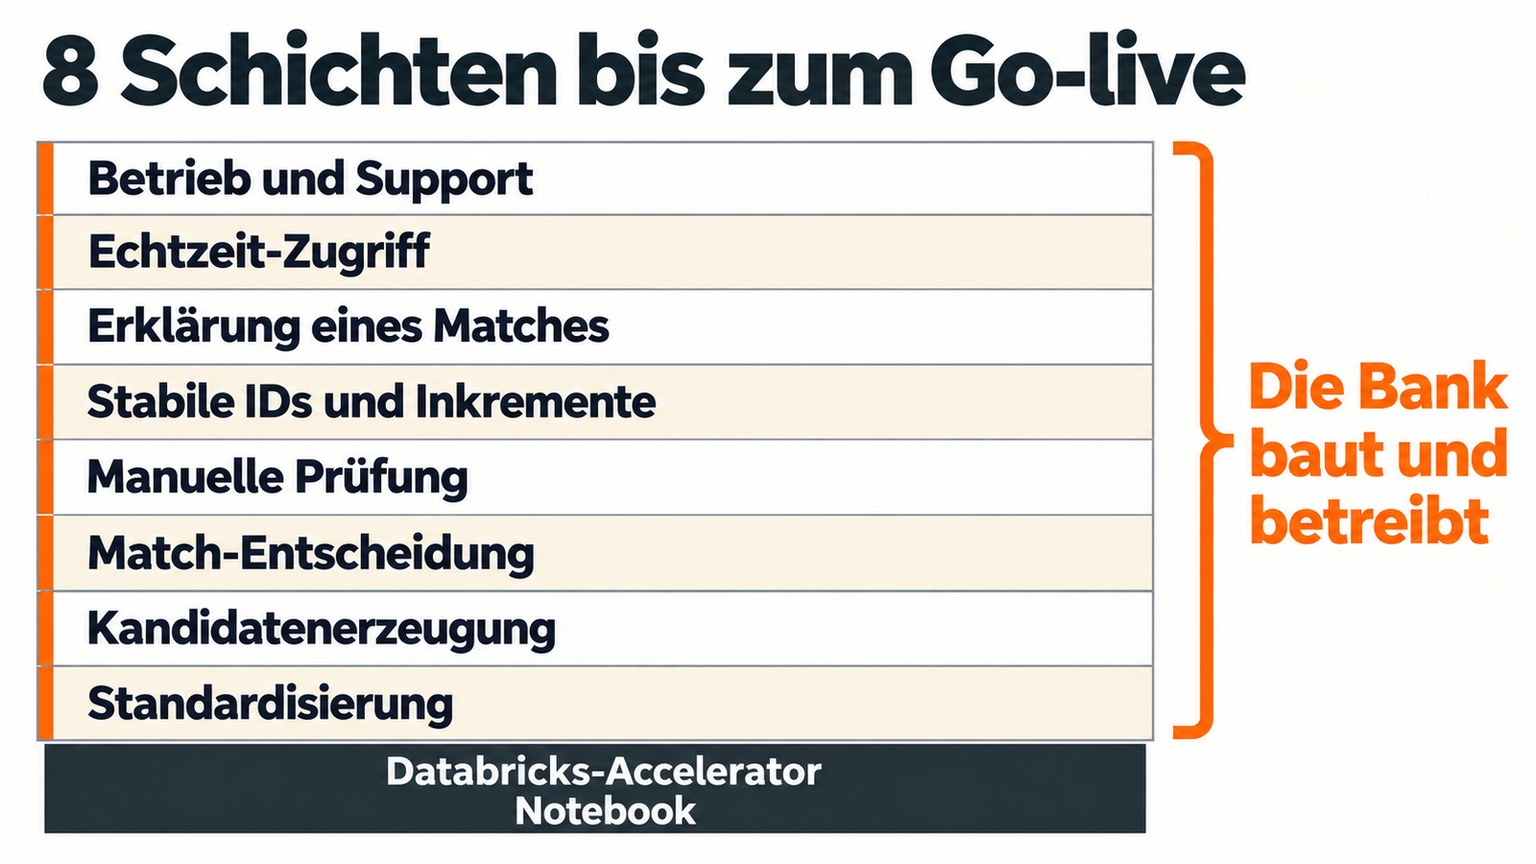
Der Support ist das kleinere Erbe. Wer live geht, verantwortet acht Produktionsschichten, und die meisten davon benennen die Kommentare in den Notebooks selbst. Die README überlässt den Umgang mit gematchten und nicht gematchten Datensätzen dem Application Engineer, und die Notebooks überlassen Prüfung, Kennungen und inkrementelles Zusammenführen dem Umsetzer.
Acht Schichten zwischen dem Accelerator und einem Produktivsystem einer Bank
| Schicht | Was Repository und Zingg-Dokumentation zeigen | Was eine Bank vor dem Go-live braucht |
|---|---|---|
| Standardisierung | Vier rohe Benchmark-Felder gehen direkt in Zinggs Fuzzy-Match-Typen. | Regeln für Umlaute, Transliteration sowie Adress- und Kennungsformate, mit erhaltenen Originalwerten. |
| Kandidatenerzeugung | Zingg lernt ein Blocking-Modell. | Eine Recall-Prüfung auf Bankdaten, denn ein Paar, das das Blocking nie vorschlägt, kann nicht matchen. |
| Match-Entscheidung | Ein Klassifikator, trainiert auf gelabelten Paaren. Laut Notebook lässt sich die Precision ohne Ground Truth kaum beurteilen. | Ein bankeigenes gelabeltes Set, freigegebene Schwellenwerte und Änderungskontrolle bei jedem Neutraining. |
| Manuelle Prüfung | Laut Notebook bräuchten Cluster mit niedrigem Score in einer echten Umsetzung eine manuelle Prüfung, und ein Notebook sei keine richtige Benutzeroberfläche für Endanwender. | Eine Prüfwarteschlange mit Rollen und umkehrbaren, protokollierten Entscheidungen. |
| Stabile IDs und Inkremente | Das Notebook vergibt eigene Cluster-IDs. Das Inkrement-Notebook überlässt mehrfache frühere Verknüpfungen und nicht gematchte Datensätze dem Entwickler. Zingg führt inkrementelle Läufe, ID-Neuzuweisung sowie Merge und Unmerge als Funktionen der kommerziellen Edition. | Entitäts-IDs, die Merges, Splits und Wiederholungsläufe überstehen. |
| Erklärung eines Matches | Zingg führt die Erklärung auf Paarebene als Funktion der kommerziellen Edition. | Eine Begründung pro Feld für jede Verknüpfung, exportierbar für Prüfer. |
| Echtzeit-Zugriff | Batch-Jobs. Zinggs Editionstabelle führt Community als Batch und die kommerzielle Edition als Batch und Echtzeit. | Eine Abfrage, die antwortet, während der Kunde wartet. |
| Betrieb und Support | Ein Job auf einer Runtime nach Support-Ende, Betriebskosten beim Nutzer, keine Support-Bedingungen. | Monitoring, Incident Response, Upgrades und ein Ansprechpartner. |
Das meiste davon ist vertraute Ingenieursarbeit. Zwei Schichten wiegen in einer Bank schwerer als anderswo, weil eine Aufsicht oder ein Screening-Team von ihnen abhängt.
Ist das Matching-Modell ein Modell im Sinne des Modellrisikos?
Wahrscheinlich, und die Modellrisiko-Funktion der Bank entscheidet. SR 11-7 definiert ein Modell als quantitative Methode, die Eingabedaten in quantitative Schätzungen überführt, und stellt Anbieterprodukte unter denselben Rahmen wie eigene Modelle. Die SS1/23 der PRA erfasst intern oder extern entwickelte Modelle von Instituten mit Genehmigung interner Modelle. Ein Klassifikator, der Datensatzpaare bewertet, fällt plausibel unter diese Formulierung. In jedem Fall braucht er Dokumentation, Validierung und Monitoring, und das liefern die Notebooks nicht. Die Validierung muss auch über einzelne Paare hinausgehen: Ein Fachaufsatz mit Peer Review zeigt, dass paarweises Matching unmögliche Verknüpfungskonfigurationen erzeugen kann, wenn Abhängigkeiten zwischen Datensätzen unbeachtet bleiben.
Wie wirkt sich das auf das Screening von Sanktionen, PEP und Adverse Media aus?
Über die Entität, die das Screening erhält. Das Screening von Kunden gegen externe Listen ist eine andere Aufgabe als das Auflösen von Dubletten, aber beide hängen an derselben Normalisierung von Namen. Allein der PEP-Datensatz von OpenSanctions enthielt am 15. Oktober 2026 718.813 Ziele in 264 Ländern, und Adverse-Media-Signale stammen aus gesondert gesteuerten Quellen. Ein aufgelöster Datensatz gibt dem Screening eine Entität zur Prüfung statt fünf Schreibweisen. Damit sind die Zeilen zu Standardisierung und stabilen IDs oben auch eine Frage der Compliance, nicht nur der Technik.
Warum hängt der Business Case an Menschen und nicht an Rechenleistung?
Weil Entwickler die acht Schichten bauen und betreiben, und daneben ist die Cluster-Rechnung klein: etwa ein Prozent des ersten Jahres im Szenario unten.
Nehmen Sie die Leitung des Plattform-Teams, das die Demo gezeigt hat. Eine Woche später verlangt das Committee eine Kostenschätzung für das erste Jahr, bevor es einen Aufbau genehmigt, und die Finanzabteilung fragt das Plattform-Team nach der Zahl, für eine Bank mit 20 Millionen Kundendatensätzen. Der erste Entwurf enthält nur die Rechenleistung, weil die Demo genau diese Kosten sichtbar gemacht hat, und sie liegt unter 3.000 US-Dollar im Jahr. Das Projekt wirkt fast kostenlos. Dann kommen die Menschen dazu, die die Schichten aus der Tabelle bauen und danach betreiben, und die Zahl wächst auf das Hundertfache.
Beispielrechnung: Accelerator fertigstellen und betreiben, mit Annahmen
| Posten | Rechnung und Annahme | Ergebnis |
|---|---|---|
| Batch-Lauf | Zingg nennt 45 Minuten für 9 Millionen Datensätze auf einer AWS m5.24xlarge. Annahme: lineare Skalierung, also 20 ÷ 9 × 45. | 100 Minuten |
| Rechenleistung | AWS-Listenpreis von 4,608 US-Dollar pro Stunde (Linux, us-east-1, gültig ab 1. Oktober 2026): 100 ÷ 60 × 4,608 je Lauf, × 365 für einen täglichen Lauf. | 7,68 US-Dollar je Lauf, 2.803 im Jahr |
| Wochensatz der Entwickler | US-Medianverdienst für Softwareentwickler von 135.980 US-Dollar im Jahr (Mai 2025), ÷ 52, × 1,3 als angenommener Aufschlag für Arbeitgeberkosten. | 3.400 US-Dollar pro Woche |
| Aufbau | Angenommene 56 Personenwochen: Standardisierung 6, Prüfung 10, IDs 8, Erklärung 8, Echtzeit 12, Monitoring 6, Unterlagen zum Modellrisiko 6. 56 × 3.400. | 190.400 US-Dollar |
| Erstes Jahr | Aufbau 190.400, plus ein halber Entwickler für den Betrieb (0,5 × 135.980 × 1,3 = 88.387), plus Rechenleistung 2.803. | 281.590 US-Dollar, davon Rechenleistung etwa 1 % |
Die Wochen sind unsere Planungsannahmen, und der Verdienst ist ein US-Richtwert. Ersetzen Sie beides durch Ihre eigenen Werte. Die Form der Rechnung übersteht jede vernünftige Änderung: Ein täglicher Lauf kostet weniger als ein Tag Entwicklerzeit. Mit unseren Preisen hat das nichts zu tun. Es zeigt, dass die Entscheidung daran hängt, wer Aufbau und Betrieb trägt, und nicht am Cluster.
Wer soll die Schichten tragen: Ihr Team, die kommerzielle Edition der Bibliothek oder eine Matching-Engine?
Das ist die Entscheidung, die das Committee eigentlich trifft, und es gibt drei ernsthafte Wege. Jeder legt die acht Schichten in andere Hände.
Drei Wege, Kundendatensätze auf Databricks aufzulösen
| Option | Lizenz und Support | Wo sie passt | Wo sie an Grenzen stößt |
|---|---|---|---|
| Der Accelerator, von Ihrem Team fertiggestellt | Databricks-Lizenz, wie besehen, kein genannter Support. Zingg Community unter der AGPL. | Ein Prototyp, der zeigt, was ein gelabeltes Modell auf Ihren Daten leistet, oder ein Batch-Job, den Ihr Spark-Team verantwortet. | Runtime nach Support-Ende, nur Batch; Ihr Team baut die Schichten für Prüfung, Identität und Audit. |
| Die kommerzielle Edition der Bibliothek | Eine kommerzielle Lizenz, Support auf Enterprise-Niveau genannt. | Teams, die bei Spark bleiben und Support für die Bibliothek kaufen. | Jede Funktion und ihren Status schriftlich bestätigen lassen. Die Freigabe von Clustern ist als „coming soon“ markiert. |
| Eine Matching-Engine neben dem Lakehouse (unsere) | Ein kommerzieller Vertrag, Support nach Umfang des Auftrags. | Echtzeit-Abfrage, erklärbare Matches, ein Audit-Trail, Betrieb in der Cloud der Bank. | Ein zweiter Dienst, den man betreiben muss. Eine einmalige Batch-Deduplizierung braucht ihn nicht. |
Der Accelerator ist die bessere Wahl für eine einmalige Batch-Deduplizierung von Analysedaten, ohne Echtzeit-Abfrage und ohne Erklärung je Entscheidung, wenn ein Spark-Team das Modell selbst besitzen will. Zusammen mit einer unterstützten Zingg-Edition passt er für diesen Fall, und eine separate Matching-Engine wäre ein zweiter Dienst, den die Bank nicht braucht.
Der andere Fall ist ein System, das antwortet, während der Kunde wartet, und jede Verknüpfung einem Prüfer erklärt. Für diesen Fall haben wir Tilores als die Schicht gebaut, die die Notebooks dem Umsetzer überlassen: eine Echtzeit-Entity-Resolution-Engine, die vollständig verwaltet auf AWS, im eigenen AWS-Konto der Bank, in einer anderen Cloud oder On-Premise läuft. Databricks kann die Datenplattform daneben bleiben.
Gemessen an der Lückentabelle halten wir deterministisches, Fuzzy- und probabilistisches Matching als drei getrennte Verfahren auseinander, und wir normalisieren Namen, Adressen und Kennungen vor dem Matching und behalten dabei die Originale. Konsistenzregeln, etwa ein Geburtsdatum, das innerhalb einer Entität übereinstimmen muss, verhindern einen Merge, egal wie stark die übrigen Hinweise sind. So kann eine Entität keine Datensätze enthalten, die einer von der Bank gesetzten Regel widersprechen. Wir speichern jede Verknüpfung mit der Regel, die sie erzeugt hat, und unsere Deployment-Optionen führen einen vollständigen Audit-Trail über Abfragen, Exporte und Löschungen. Anwendungen fragen über eine GraphQL-API ab, mit einer Suche in etwa 150 ms in unserer Managed Cloud und etwa 1 ms im Self-Hosting. Wir verfügen über SOC 2 Type I, und unser Support reicht „von Standard-Technologiesupport bis hin zu einem dedizierten Customer-Success-Engineer“, nach Umfang des Auftrags.
Wir ersetzen weder Databricks noch die Golden-Record-Richtlinie der Bank noch ihr Screening, eine Grenze, die unser Build-versus-Buy-Leitfaden beschreibt. Am schnellsten klären Sie die Wahl auf den eigenen Daten der Bank. Unser Tilores Studio führt dieselbe Engine lokal auf bis zu 100.000 Ihrer Datensätze aus, kostenlos. So kann ein Team eine gelabelte Stichprobe am selben Tag in Studio und im Accelerator bewerten, nach dem Vorgehen in unserem Bake-off-Leitfaden. Buchen Sie eine 30-minütige Demo, und wir gehen die Plattform mit Ihren Daten durch.
Welche Schritte führen eine Bank zu einer Go-oder-No-Go-Entscheidung?
Sie behandelt den Accelerator als Prototyp, bis schriftliche Antworten und ein Test auf Bankdaten etwas anderes zeigen. Fünf Schritte bringen das Committee dorthin.
- Stellen Sie Databricks und Zingg fünf Fragen schriftlich: welcher Lizenztext gilt, ob der Support angepasste Notebooks und die Zingg-Bibliothek abdeckt, welche Runtime- und Zingg-Versionen zusammen laufen, wer bei einem Vorfall antwortet und wie schnell, und welche Nutzungsdaten den Cluster verlassen.
- Geben Sie beide Lizenzen in die Rechts- und Open-Source-Prüfung, auch die Bedingungen der kommerziellen Edition, falls Sie diese kaufen würden.
- Portieren Sie auf eine unterstützte Runtime und ein aktuelles Zingg-Release und halten Sie fest, was bricht.
- Bewerten Sie ihn auf Bankdaten: eine bankeigene gelabelte Stichprobe mit verdecktem Holdout, Accelerator und Alternative nebeneinander. Unser Leitfaden zum Proof of Concept listet die Eingaben auf.
- Benennen Sie für jede der acht Schichten einen Verantwortlichen und ein Datum und legen Sie die Liste der Risikofunktion vor.
Go, wenn die Antworten schriftlich vorliegen, die Portierung auf einem unterstützten Stack läuft, die Bewertung die vereinbarten Ziele erreicht und jede Schicht einen Verantwortlichen hat. Bedingtes Go für interne Analytik, bei der ein falscher Merge wenig kostet. No-Go für kundennahe, regulierte Entscheidungen, solange eine Lizenz- oder Support-Antwort fehlt. Diese Schritte beantworten die Frage, die das Committee gestellt hat.
Häufig gestellte Fragen
Wird der Databricks-Accelerator für Entity Resolution von Databricks unterstützt?
Weder das Repository noch seine LICENSE oder die Seite des Accelerators bei Databricks nennt eine Support-Zusage. Fragen Sie Databricks schriftlich, ob der Plattform-Support ein von Ihnen angepasstes Notebook abdeckt.
Darf eine Bank die Notebooks des Accelerators und die Zingg-Bibliothek verändern?
Die LICENSE-Datei des Repositorys untersagt abgeleitete Werke ohne gesonderte Bedingungen, während die Lizenzseite von Databricks, auf die die Notebooks verweisen, Änderungen für die Nutzung innerhalb von Databricks-Diensten erlaubt. Zingg Community steht unter der AGPL v3.0, deren Abschnitt 13 für veränderte Versionen gilt, die Nutzer über ein Netzwerk erreichen. Beides braucht eine rechtliche Prüfung.
Kann der Accelerator Datensätze bei der Kontoeröffnung in Echtzeit matchen?
Der Accelerator läuft als Batch-Jobs, und Zinggs Editionstabelle führt Community als Batch. Wir betreiben Echtzeit-Resolution als GraphQL-Dienst, mit einer Suche in etwa 150 ms in unserer Managed Cloud und etwa 1 ms im Self-Hosting.
Läuft der Accelerator noch auf aktuellen Databricks-Runtimes?
Die README verlangt Databricks Runtime 11.0 oder neuer, und der angelegte Job legt 12.2 LTS fest, dessen Support am 1. März 2026 endete. Nichts im Repository sagt, dass er auf einer neueren Runtime getestet wurde, und sein letzter Commit stammt vom Oktober 2023.
Quellen
- customer-er README, Customer Entity Resolution solution accelerator, Databricks Industry Solutions, GitHub.
- LICENSE, customer-er repository, Databricks, Inc. (2022).
- NOTICE, customer-er repository, Databricks, Inc.
- RUNME notebook (job definition, Databricks Runtime 12.2 and Zingg 0.3.4), customer-er repository.
- 02 Initial Workflow Part A (candidate-pair labelling), customer-er repository.
- 02 Initial Workflow Part B (training, matching and cluster identifiers), customer-er repository.
- 03 Incremental Workflow (link and match of new records), customer-er repository.
- Commit history und Issues, customer-er repository, abgerufen am 15. Oktober 2026.
- Customer Entity Resolution, Databricks Solution Accelerators.
- New Solution Accelerator: Customer Entity Resolution, Luke Bilbro, Sonal Goyal, Bryan Smith und Mimi Qunell, Databricks Blog, 4. August 2022.
- Creating a Community of Industry Practitioners With Databricks Solutions Accelerators, Databricks Blog, 6. Oktober 2022.
- DB license, Databricks.
- Databricks support lifecycles, Databricks-Dokumentation.
- End-of-support Databricks Runtime release notes, Databricks-Dokumentation.
- Zingg (README, Lizenzangabe AGPL v3.0) und Releases, Zingg AI, GitHub.
- Hardware Sizing, Zingg-Dokumentation.
- Adding Incremental Data, Zingg-Dokumentation (Funktion der kommerziellen Edition).
- Explanation of Matches, Zingg-Dokumentation (Funktion der kommerziellen Edition).
- Approval of Clusters, Zingg-Dokumentation (Funktion der kommerziellen Edition, als „coming soon“ markiert).
- Running on Databricks, Zingg-Dokumentation.
- Security and Privacy, Zingg-Dokumentation.
- Zingg MDM Compare Editions, Zingg.
- GNU Affero General Public License, version 3, Free Software Foundation.
- Benchmark datasets for entity resolution, Database Group Leipzig, Universität Leipzig.
- SR 11-7: Supervisory Guidance on Model Risk Management, Board of Governors of the Federal Reserve System und Office of the Comptroller of the Currency, 4. April 2011.
- SS1/23: Model risk management principles for banks, Bank of England, Prudential Regulation Authority (aktuelle Fassung vom 23. April 2026).
- (Almost) all of entity resolution, Olivier Binette und Rebecca C. Steorts, Science Advances 8(12), 2022.
- Politically Exposed Persons, OpenSanctions.
- Software Developers, Quality Assurance Analysts, and Testers, Occupational Outlook Handbook, US Bureau of Labor Statistics.
- Amazon EC2 price list, US East (N. Virginia), Amazon Web Services, Veröffentlichungsdatum 12. Oktober 2026.
- Deployment-Optionen, Tilores.
- Tilores Studio herunterladen, Tilores.
- Preise und Preisgestaltung, Tilores.
- Databricks oder Matching Engine? Build-versus-Buy-Leitfaden für Banken 2026, Tilores.
- Entity Resolution neben dem Lakehouse: Wo die Engine wirklich laufen sollte, Tilores.
- Entity-Resolution-Anbieter mit echten Bankdaten vergleichen: Ein belastbarer Bake-off, Tilores.
- Entity Resolution Proof of Concept: 7 PoC-Inputs für Banken im Jahr 2026, Tilores.
Sehen Sie, was aufgelöste Entitätsdaten für Ihr Unternehmen — und Ihre KI — leisten.