Wie viele manuelle Prüfungen erzeugt die Bereinigung eines Kundenbestands? Die Prüfwarteschlange vor dem Kauf dimensionieren (2026)

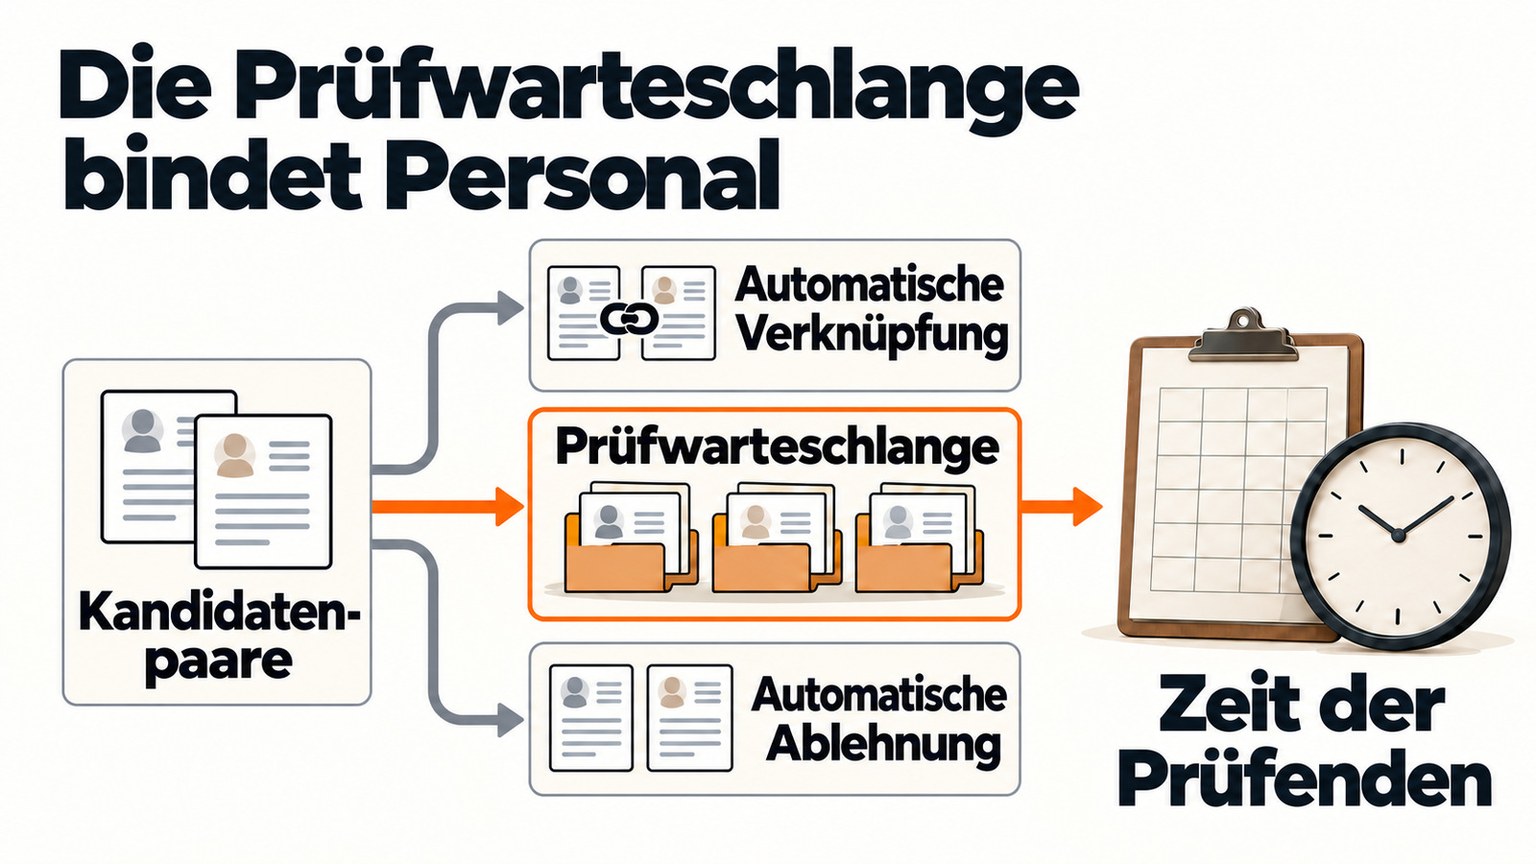
Kurzfassung: Mehr, als eine Vorführung vermuten lässt, und wie viele genau, können nur Ihre eigenen Daten sagen. In unserer illustrativen Bank erzeugen zwei Millionen Kundendatensätze rund 40.000 Prüffälle, etwa 117 Prüfwochen. Zählen Sie an einer Gruppenstichprobe die Paare zwischen Ihren Grenzen für automatische Verknüpfung und automatische Ablehnung, fassen Sie sie zu Fällen zusammen, messen Sie echte Entscheidungen und teilen Sie durch die produktiven Prüfstunden.
Demo buchen · Tilores Studio kostenlos testen
Auf dieser Seite
- Warum entscheidet die Prüfwarteschlange über die Kosten einer Kundenbereinigung?
- Warum kann kein Anbieter Ihre Prüfquote vorab nennen?
- Wie dimensionieren Sie die Prüfwarteschlange vor dem Kauf aus Ihren eigenen Daten?
- Wie sieht die Rechnung für eine Bank mit zwei Millionen Kundendatensätzen aus?
- Wie verkleinern Sie die Warteschlange, ohne falsche Zusammenführungen einzukaufen?
- Was geschieht mit der Warteschlange, wenn der Altbestand bereinigt ist?
- Was sollte eine Bank in den PoC und das Gespräch mit Anbietern mitnehmen?
- Häufig gestellte Fragen
- Quellen
Eine Produktvorführung endet auf einer einzigen Merge-Maske: zwei Kundendatensätze nebeneinander, ein Score, eine prüfende Person, die die Verknüpfung in Sekunden bestätigt. Dann fragt, wer das Budget verantwortet, wie viele solcher Masken das Team abarbeiten muss, bevor der neue Kundenstamm live gehen kann.
Die Vorführung kann darauf nicht antworten, denn die Zahl gehört zu Ihren Daten, nicht zum Produkt. Für eine erfundene Bank mit zwei Millionen Datensätzen sind es rund 40.000 Entscheidungen, mehr als zwei Prüfjahre Arbeit.
Wir meinen: Diese Warteschlange entscheidet stärker als die Lizenz darüber, ob eine Bereinigung finanziert wird. Zählen Sie sie deshalb an Ihren eigenen Datensätzen, bevor Sie einen Anbieter wählen, mit einer Rechnung, die jede Finanzprüfung nachvollziehen kann, statt sie nach dem Go-live zu entdecken.
Warum entscheidet die Prüfwarteschlange über die Kosten einer Kundenbereinigung?
Jedes Paar, das der Matcher nicht selbst entscheiden kann, wird zur Entscheidung für eine Person, und diese Entscheidungen, nicht die Zahl der Datensätze, bestimmen die Personalzeile. Fellegi und Sunter beschrieben in ihrer Theorie der Record Linkage von 1969 drei Entscheidungen: verknüpfen, nicht verknüpfen und einer Person vorlegen. Das US Census Bureau nennt das zurückgehaltene Band die Clerical-Review-Region (Bereich der manuellen Prüfung), und das britische Office for National Statistics bestätigt Paare zwischen seinen Schwellenwerten per Clerical Review.
Bei einer Prüfung durch Data Stewards entscheidet eine Person einen zurückgehaltenen Fall, also jenes Ergebnis, das Fellegi und Sunter als aufwendige manuelle Arbeit kennzeichneten. Alles Übrige wird ungesehen verknüpft oder bleibt getrennt, die Kosten der Bereinigung liegen also in der Breite des mittleren Bandes. In der erfundenen Bank weiter unten umfasst dieses Band rund 40.000 Fälle.
Warum kann kein Anbieter Ihre Prüfquote vorab nennen?
Die Breite des Bandes folgt der Vollständigkeit und Konsistenz Ihrer Quelldaten, und die hat kein Anbieter gesehen. Eine tasmanische Datenverknüpfungsstelle berichtete, bei zwei sauberen Krankenhausdatensätzen 6 % und 8 % der Datensätze manuell geprüft zu haben, bei Perinataldaten 30 % und bei einer kleinen Rettungsdienstgruppe 78 %, die beiden Letzteren mit unvollständigen Namens- und Adressfeldern: eine Spanne um den Faktor dreizehn innerhalb einer einzigen Stelle. Deshalb gehört in kein Verkaufsgespräch eine feste Prüfquote, für kein Produkt, auch nicht für unseres.
Auch eine kurze Warteschlange beweist wenig. Die Hinweise der britischen Regierung zur Qualität von Datenverknüpfungen halten fest, dass Paare mit stark fehlenden oder widersprüchlichen Daten unter den Nichttreffern verborgen bleiben und nie zur Prüfung gelangen. Eine kleine Zahl kann einen sauberen Bestand bedeuten oder einen Matcher, der die schwierigen Paare nie gezeigt hat. Messen Sie verpasste Verknüpfungen deshalb als eigene Aufgabe an beschrifteten Beispielen. Unser Leitfaden zum Entwurf von Review-Queues behandelt die Seite der Prüfenden.
Die Quote muss also gemessen werden, und das geht, bevor irgendetwas gekauft ist.
Wie dimensionieren Sie die Prüfwarteschlange vor dem Kauf aus Ihren eigenen Daten?
Nehmen Sie eine Stichprobe Ihrer eigenen Datensätze, so gezogen, dass wahrscheinliche Dubletten zusammenbleiben, und rechnen Sie sie in sechs Schritten in Prüfwochen um.
- Arbeitseinheit festlegen: ein Fall, nicht ein Paar. Eine prüfende Person entscheidet über einen Kunden, nicht über jedes Paar: Drei Datensätze einer Person bilden drei Paare, brauchen aber nur eine oder zwei Entscheidungen. Legen Sie die Definition mit dem Betrieb fest und erfassen Sie in der Stichprobe die Paare pro Fall. Das Beispiel unten nutzt 1,5.
- Stichprobe nach Gruppen ziehen, nicht nach Zeilen. Eine zufällige Zeilenstichprobe von 5 % behält beide Datensätze eines Paares nur in 0,25 % der Fälle (0,05 mal 0,05). Bilden Sie stattdessen Gruppen von Datensätzen, die Dubletten sein könnten, zum Beispiel alle mit gleicher Postleitzahlregion und gleichem Anfangsbuchstaben des Nachnamens, und ziehen Sie 5 % der Gruppen, sodass jedes Paar vollständig ankommt. Dubletten in verschiedenen Gruppen fehlen, lesen Sie das Ergebnis daher als Untergrenze und wiederholen Sie die Ziehung; weichen die Zählungen um mehr als ein Fünftel ab, vergrößern Sie die Stichprobe. Eine Ziehung von 5 % aus zwei Millionen Datensätzen ergibt 100.000 Datensätze, die kostenlose lokale Grenze unseres Tilores Studio.
- Paare je Band nach Regel zählen. Dieser Schritt braucht einen Matcher, und unserer übernimmt das Zählen. Unsere Match-Regeln verknüpfen zwei Datensätze oder nicht, und jede Verknüpfung trägt die ID ihrer Regel. Unsere Suchregeln sind davon getrennt: Eine Suche liefert Kandidaten mit einem Ähnlichkeitswert, dem hitScore zwischen 0 und 1, ohne eine Verknüpfung anzulegen (API-Dokumentation). Aus diesen Bausteinen kann eine Bank drei Bänder bilden: strenge Regeln, die verknüpfen, einen weiteren Suchregelsatz, der Kandidaten für eine Person sichtbar macht, und alles Übrige. Zählen Sie für das Band der automatischen Verknüpfung regelbasierte Kanten je Regel-ID und ignorieren Sie unsere STATIC-Kanten, die gemeinsam übermittelte Datensätze unabhängig von den Regeln verbinden. Das Prüfband zählen Sie dagegen aus Suchtreffern, denn eine Suche verknüpft nichts: Durchsuchen Sie die Stichprobe mit dem weiteren Regelsatz, und die gefundenen Paare, die keine Match-Regel verknüpft hat, bilden Ihr Prüfband. Jeder Treffer trägt die ID der Regel, die ihn gefunden hat, sodass sich das Band je Regel zählen lässt. Die Bänder sind die eigene Zählmethode der Bank, gebaut aus diesen Bausteinen, keine eingebaute Funktion.
- Zählungen hochrechnen und Paare zu Fällen zusammenfassen. Multiplizieren Sie jede Zahl mit dem Kehrwert des Stichprobenanteils (20 bei einer Ziehung von 5 %) und teilen Sie die Prüfpaare durch die Paare pro Fall.
- Echte Entscheidungen an der späteren Prüfmaske messen. Lassen Sie die künftigen Prüfenden 100 Fälle der Stichprobe mit der Beleganzeige bearbeiten, die sie in der Produktion nutzen werden, und halten Sie die mediane Minutenzahl fest. Die Entscheidungen von Prüfenden hängen davon ab, welche Identifikatoren sie sehen, ein Test in einer Tabelle sagt daher nichts über eine eigens gebaute Maske voraus.
- Fälle in Prüfwochen umrechnen und eine Zweitprüfung einplanen. Multiplizieren Sie Fälle mit Minuten und planen Sie die Zweitprüfung einer Stichprobe der Entscheidungen ein: Die Hinweise des britischen ICO zur menschlichen Überprüfung von KI-Systemen erwarten Stichproben, ein Protokoll der Übersteuerungen und eine bewältigbare Fallzahl. Teilen Sie die Stunden dann durch die produktiven Prüfstunden je Woche.
Das ergeben diese sechs Schritte für eine Bank.
Neue Beiträge zu Entity Resolution, Identitätsdaten und KI. Kein Spam, Abmeldung jederzeit möglich.
Wie sieht die Rechnung für eine Bank mit zwei Millionen Kundendatensätzen aus?
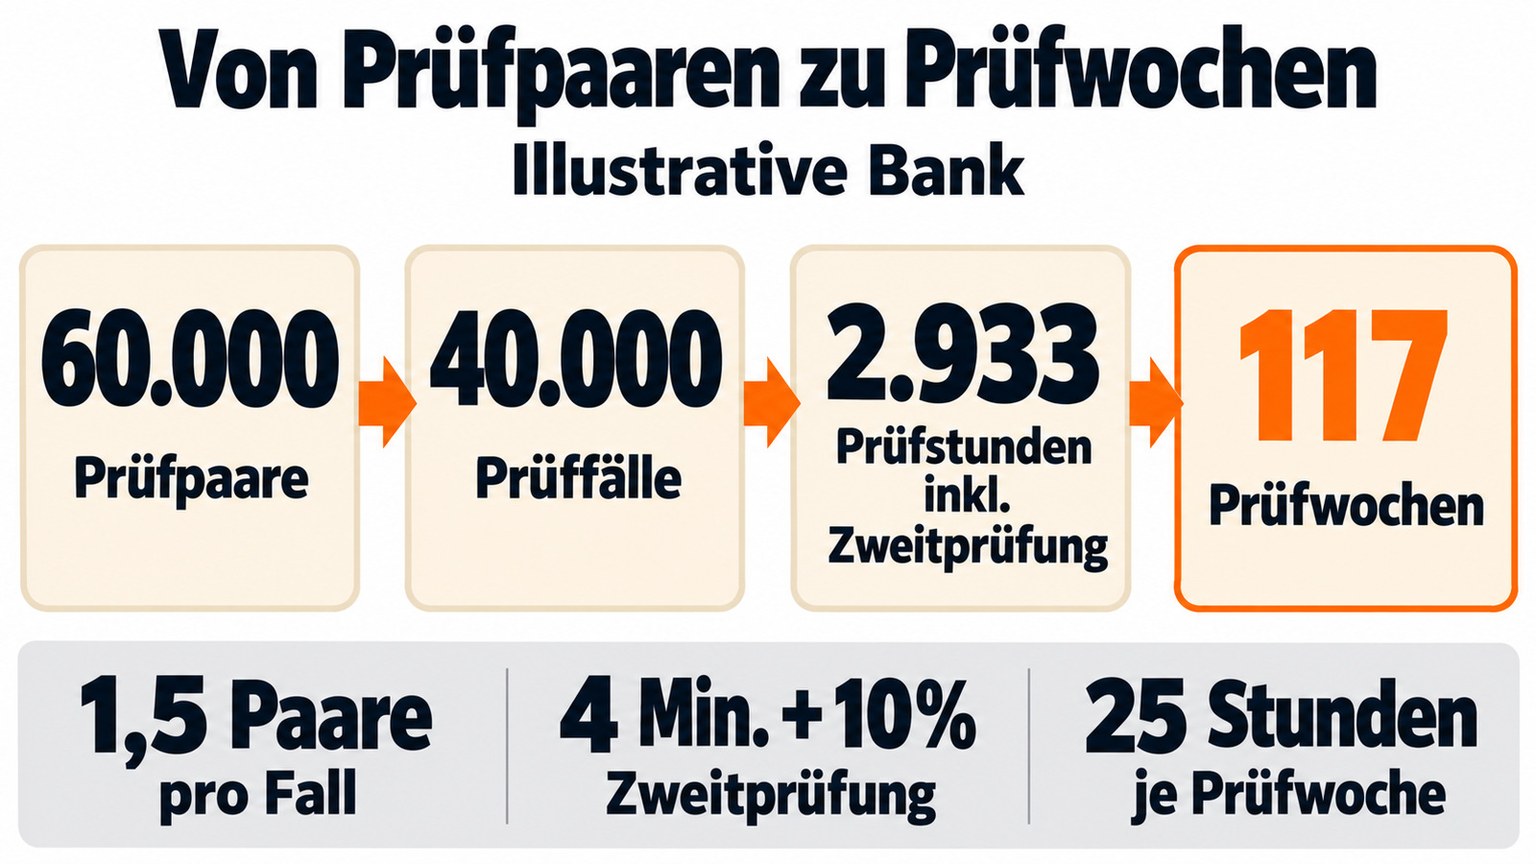
Für eine erfundene Bank mit zwei Millionen Datensätzen ergeben die sechs Schritte rund 40.000 Fälle und 117 Prüfwochen, bei einem Team von acht Personen also etwa fünfzehn Wochen. Die Bank und jede Eingabe sind illustrative Annahmen und kein Ergebnis von uns.
Die Data-Governance-Leitung der Bank hat Datensätze in vier Quellsystemen, Rückhalt im Management nach einer gelungenen Vorführung und einen Entwurf des Business Case ohne Zeile für Prüfende. Drei Wochen vor der Sitzung des Lenkungsausschusses zieht sie 5 % der Gruppen und findet ein Viertel der Paare über der Prüfuntergrenze im Band. Der Betrieb misst hundert Fälle mit je vier Minuten. Der Business Case hat jetzt eine Zeile für Prüfende, deren Eingaben der Ausschuss einzeln hinterfragen kann.
Illustrative Dimensionierung der Prüfwarteschlange für eine erfundene Bank
| Schritt | Wert | Grundlage |
|---|---|---|
| Kundendatensätze in vier Quellsystemen | 2.000.000 | Annahme |
| Stichprobe: 5 % der Gruppen | 100.000 Datensätze | Annahme |
| Paare über der Prüfuntergrenze in der Stichprobe | 12.000 | Angenommene Stichprobenzählung |
| Davon über der Grenze für die automatische Verknüpfung | 9.000 | Angenommene Stichprobenzählung |
| Davon im Prüfband | 3.000 (25 %) | Angenommene Stichprobenzählung |
| Prüfpaare für den gesamten Bestand (mal 20) | 60.000 | Rechnung |
| Paare pro Fall | 1,5 | Annahme |
| Prüffälle | 40.000 | 60.000 / 1,5 |
| Minuten pro Fall | 4 | Annahme, zu messen |
| Prüfstunden | 2.667 | 40.000 x 4 / 60 |
| Zweitprüfung bei 10 % der Fälle | 267 Stunden | Annahme |
| Gesamtstunden | 2.933 | Rechnung |
| Produktive Prüfstunden je Prüfwoche | 25 | Annahme |
| Prüfwochen | 117 | 2.933 / 25; etwa 2,5 Prüfjahre bei 46 Arbeitswochen im Jahr |
| Dauer mit acht Prüfenden | Etwa 15 Wochen | 117 / 8 |
Welche Eingaben bewegen das Ergebnis am stärksten?
Der Anteil des Prüfbands und die Minuten pro Fall; die Matrix hält alles andere auf den Werten von oben.
Prüfwochen der illustrativen Bank unter verschiedenen Annahmen
| Anteil des Prüfbands an den Paaren über der Untergrenze | 2 Minuten pro Fall | 4 Minuten pro Fall | 8 Minuten pro Fall |
|---|---|---|---|
| 15 % (24.000 Fälle) | 35 Prüfwochen | 70 Prüfwochen | 141 Prüfwochen |
| 25 % (40.000 Fälle) | 59 Prüfwochen | 117 Prüfwochen | 235 Prüfwochen |
| 35 % (56.000 Fälle) | 82 Prüfwochen | 164 Prüfwochen | 329 Prüfwochen |
Eine Spanne von 35 bis 329 Prüfwochen ist der frühere Punkt über vorab genannte Quoten, jetzt in Geld. Eine Zahl dieser Größe lädt außerdem zur naheliegenden Reaktion ein: die Warteschlange zu verkleinern.
Wie verkleinern Sie die Warteschlange, ohne falsche Zusammenführungen einzukaufen?
Korrigieren Sie die Daten vor der Entscheidung, und lassen Sie die Grenzen unverändert, bis Sie den Recall geprüft haben. Jeder Hebel unten hat eine Prüfung, die verhindert, dass er Prüfzeit gegen Fehler tauscht.
Hebel für eine kleinere Prüfwarteschlange
| Hebel | Angenommene Wirkung auf das illustrative Band | Was vorher zu prüfen ist |
|---|---|---|
| Namen, Adressen und Daten vor der Bewertung normalisieren | Entfernt 20 % der Prüfpaare, die sich nur im Format unterscheiden | Kein echter Treffer geht verloren, und die Originale bleiben am Datensatz. Besseres Scoring ist ein eigener Weg: Palfy und Kollegen senkten das Volumen der manuellen Prüfung mit besseren Werten für die Namensähnlichkeit. |
| Konsistenzregeln ergänzen, etwa ein Geburtsdatum, das über eine Entität hinweg übereinstimmen muss | Entfernt 10 % der verbleibenden Paare, indem eine Klasse zu Nichtverknüpfungen wird | Paare ohne Geburtsdatum bleiben in der Warteschlange, weil ein fehlender Wert weder bestätigen noch ausschließen kann. Siehe unseren Leitfaden zu Konsistenzregeln bei gleichen Namen. |
| Untere Linie des Bandes anheben | Verschiebt Paare von der Prüfung zu getrennt | Recall an beschrifteten Beispielen. Verpasste Verknüpfungen erreichen die Warteschlange nie, dieser Hebel verbirgt also seine eigenen Kosten. |
Wenden Sie die ersten beiden nacheinander an, sinkt die illustrative Warteschlange von 117 auf etwa 84 Prüfwochen (117 mal 0,8, dann mal 0,9). Die verlockende Abkürzung ist, die Grenze für die automatische Verknüpfung zu senken, damit mehr Paare ungeprüft zusammengeführt werden. Die Einsparung kehrt als falsche Zusammenführungen zurück, die die Daten einer Person in das Profil einer anderen legen und zu einem meldepflichtigen Datenschutzvorfall werden können.
Sollte die Warteschlange selbst stichprobenartig geprüft werden, um Zeit zu sparen?
Prüfen Sie Stichproben, um Qualität zu messen, nie um Entscheidungen zu überspringen. In einer Studie von Forschenden von NHS England und UCL mit 50.000 Datensätzen und rund 478.000 Kandidatenpaaren verschlechterte die Prüfung von etwa 7 % statt etwa 23 % der Paare die Schätzung: Der geschätzte globale Verknüpfungsfehler stieg von zutreffenden 4,2 % auf 9,3 %, mit den größten Fehlern auf Bandebene in den mittleren Score-Bereichen.
Was geschieht mit der Warteschlange, wenn der Altbestand bereinigt ist?
Sie schrumpft von einer Welle zu einem Rinnsal, und das Rinnsal lässt sich vor dem Go-live auf dieselbe Weise messen. Besetzen Sie die Welle als Projekt und das Rinnsal mit einem dauerhaften Team.
In der illustrativen Bank erzeugen 30.000 neue oder geänderte Datensätze im Monat, von denen angenommen 1,2 % einen Fall brauchen, 360 Fälle, etwa 26 Stunden einschließlich Zweitprüfung, also ungefähr eine Prüfwoche. Messen Sie die Quote, indem Sie einen Monat vergangener Zugänge mit unserem submitWithPreview und dryRun auf true durchspielen. Das liefert die Entitäten, die die Datensätze bilden würden, und die Regeln, die sie verknüpfen würden, ohne etwas zu speichern. Übermitteln Sie die Datensätze einzeln, da wir gemeinsam gesendete Datensätze durch STATIC-Kanten verbinden.
Teilen sich Sanktions-, PEP- und Adverse-Media-Treffer diese Warteschlange?
Nein. Screening-Treffer bilden eine zweite Warteschlange mit eigenen Schwellenwerten und eigenen Prüfenden, und dieselbe Rechnung dimensioniert sie. Die Matching-Hinweise von OpenSanctions halten fest, dass ein Ergebnis nicht sofort Anlass zur Sorge ist, weil die PEP-Daten viele Personen mit häufigen Namen enthalten, und raten, den Alarmschwellenwert auf den Anwendungsfall abzustimmen, bevor eine menschliche Prüfung eingerichtet wird. Unsere Auflösungsschicht arbeitet neben dem Screening, ohne es zu ersetzen, sodass das Screening-System einen Kunden mit seinen Namensvarianten und deren Herkunft erhält.
Welle, Rinnsal und Screening-Warteschlange ergeben zusammen die Personalzeile, und der letzte Schritt ist, sie in der Kaufentscheidung zu nutzen.
Was sollte eine Bank in den PoC und das Gespräch mit Anbietern mitnehmen?
Die Zählung selbst. Die Quote manueller Prüfungen und die Zeit je Prüfung sind die Personalzeilen, nach denen ein Finanzausschuss fragt, und wer das Vorhaben ohne Budgetzeile für Entity Resolution vorantreibt, braucht sie vor der Sitzung.
Wir vereinbaren mit der Bank vor Testbeginn Ziele für Precision und Recall, arbeiten mit einem Beispielauszug, führen mindestens zwei Verfeinerungsrunden durch und übergeben die Regelkonfiguration in exportierbarer Form, sodass die Bank diese Zählung wiederholen kann. Unsere Leitfäden zur Einigung auf Matching-Regeln vor einem PoC und zu den sieben PoC-Inputs behandeln beides. Wir sind keine vollständige MDM-Suite, und eine Bank kann ihre Stammdaten und ihren Stewardship-Prozess in den eigenen Systemen behalten.
Wir sind nicht in jedem Fall die richtige Antwort. Trägt jeder Kunde bereits einen verlässlichen Identifikator und beseitigen eine Schlüsselprüfung und ein kurzes Skript die seltenen Dubletten, passt die Warteschlange in eine Tabelle, und eine Engine verursacht Kosten, ohne Arbeit zu sparen. Das gilt nicht mehr, sobald Namen, Adressen und Daten variieren, denn was das Skript übersieht, bleibt unsichtbar.
Wege, die Warteschlange einer Kundenbereinigung zu bewältigen
| Option | Passt, wenn | Reicht nicht, wenn |
|---|---|---|
| Case-Management- oder MDM-Workflow, den die Bank bereits besitzt | Die Bank Zuweisung und Eskalation fertig eingebaut braucht | Er leitet nur weiter, was der Matcher sichtbar macht |
| Eigener Matcher mit eigener Warteschlange | Ein eigenes Matching-Team Zeit zum Bauen und Pflegen hat | Niemand einer Aufsicht zeigen kann, warum zwei Datensätze verknüpft wurden |
| Auflösungs-Engine mit exportierbaren Regeln (unser Ansatz) | Die Bank vor Vertragsabschluss Bandzählungen aus den eigenen Daten will | Die Bank weiterhin Prüfende und einen Verantwortlichen für die Entscheidungsrichtlinie braucht |
Welchen Weg Sie auch wählen, stellen Sie jedem Anbieter sechs Fragen schriftlich:
- Zählen Sie vor Vertragsabschluss unsere Bänder an einer Stichprobe unserer eigenen Datensätze und zeigen Sie die Zählung je Regel?
- Was ist in Ihrem Werkzeug ein Prüffall: ein Paar, ein Cluster oder ein Kunde?
- Welcher Teil des Bandes entsteht durch fehlende Daten und gehört deshalb in die Datenkorrektur statt in die Warteschlange der Prüfenden?
- Ist jede Entscheidung protokolliert und umkehrbar, mit Begründung und der Regelversion, die den Fall ausgelöst hat?
- Können wir die Regelkonfiguration exportieren und die Dimensionierung bei Regeländerungen erneut durchführen?
- Wer trägt die Prüfkosten im Preis, und was geschieht mit einem zurückgehaltenen Paar, das niemand prüft?
Ein Anbieter, der mit Zählungen aus Ihrer Stichprobe antwortet, hat Ihre Warteschlange dimensioniert. Einer, der mit einer Maske antwortet, hat Ihnen die Vorführung noch einmal gezeigt.
Häufig gestellte Fragen
Wie viele manuelle Prüfungen erzeugt die Bereinigung eines Kundenbestands bei einer Bank?
Zählen Sie es an Ihren eigenen Daten: die Paare zwischen Ihren Grenzen für automatische Verknüpfung und automatische Ablehnung an einer Gruppenstichprobe, geteilt durch die Paare pro Fall. In unserer illustrativen Bank erzeugen zwei Millionen Datensätze rund 40.000 Fälle. Veröffentlichte geprüfte Anteile reichen von 6 % der Datensätze bei sauberen bis 78 % bei schlechten Daten.
Wie lange dauert eine einzelne Prüfung durch Data Stewards?
Messen Sie es mit den Personen und der Maske, die Sie einsetzen werden. Das Rechenbeispiel nimmt vier Minuten an, und eine Spanne von zwei bis acht Minuten verändert die Summe um den Faktor vier.
Kann eine Bank die Warteschlange verkleinern, indem sie mehr Paare automatisch zusammenführt?
Das geht, aber die Kosten wandern von der Prüfzeit zu falschen Zusammenführungen, die die Daten einer Person in das Profil einer anderen legen. Verkleinern Sie die Warteschlange zuerst mit besserer Normalisierung und Konsistenzregeln, und prüfen Sie den Recall an beschrifteten Beispielen, bevor Sie eine Grenze verschieben.
Wie kann eine Bank Prüfbänder vor dem Kauf in unserem Tilores Studio zählen?
Laden Sie eine Stichprobe in unser Tilores Studio, das lokal mit bis zu 100.000 Datensätzen läuft, zählen Sie für das Band der automatischen Verknüpfung regelbasierte Kanten je Regel-ID ohne STATIC-Kanten, und werten Sie die Treffer unseres weiteren Suchregelsatzes, die keine Match-Regel verknüpft hat, als Prüfband. Jeder Treffer trägt einen hitScore und die ID der Regel, die ihn gefunden hat. Für neu eintreffende Datensätze zeigt unser submitWithPreview mit dryRun auf true, welcher Entität jeder zugeordnet würde, bevor etwas gespeichert wird.
Quellen
- Tilores documentation: API (submit, submitWithPreview, search and hitScore), Tilores.
- Tilores documentation: Rules Configuration (edges, rule sets and search), Tilores.
- Tilores Studio herunterladen, Kostenlose Evaluierung, Tilores.
- Review Queues für Entity Resolution: Menschliche Entscheidungen bei mehrdeutigen Matches im Jahr 2026, Tilores.
- Wie eine Bank und ihr Entity-Resolution-Anbieter sich vor einem PoC auf Matching-Regeln einigen, Tilores.
- Entity Resolution Proof of Concept: 7 PoC-Inputs für Banken im Jahr 2026, Tilores.
- Erkennt Entity Resolution zwei Kunden mit demselben Namen als unterschiedliche Personen? Konsistenzregeln für Banken, Tilores.
- Ist eine falsche Kundenzusammenführung ein meldepflichtiger DSGVO-Vorfall, und was müssen Banken dokumentieren?, Tilores.
- Ein finanzierbarer Customer-Master-Business-Case für kleinere Banken, Tilores.
- A Theory for Record Linkage, Ivan P. Fellegi und Alan B. Sunter, Journal of the American Statistical Association, Band 64, Nr. 328 (1969).
- Overview of Record Linkage and Current Research Directions, William E. Winkler, US Census Bureau Research Report Series (2006).
- Developing standard tools for data linkage, Office for National Statistics, Arbeitspapier (Februar 2021).
- Quality assessment in data linkage, James Doidge, Peter Christen und Katie Harron, UK Government, Joined up data in government: the future of data linking methods.
- The impact of administrative dataset characteristics on clerical review: A Tasmanian case study, Nadine Wiggins und Brian Stokes, International Journal of Population Data Science, Band 1, Nr. 1 (2017).
- Improving name comparison similarity scores to reduce number of records for clerical review, Miro Palfy, Stacy Ann Vasquez und Alexandre Franco Garcia, International Journal of Population Data Science, Band 3, Nr. 4 (2018).
- Designing An Ambiguity-Aware Clerical Review Strategy, Joseph Lam und Kollegen, International Journal of Population Data Science, Band 11, Nr. 5 (2026).
- Diversity of record pairs and mental models in clerical review: What reviewers use to decide matches, Yashithi Dharmawimala und Kollegen, International Journal of Population Data Science, Band 11, Nr. 5 (2026).
- Human review, Artificial intelligence toolkit, Information Commissioner’s Office.
- The matching API, OpenSanctions.
Sehen Sie, was aufgelöste Entitätsdaten für Ihr Unternehmen — und Ihre KI — leisten.