Wie sollte eine Bank Kundennamen über Schreibvarianten, Transliteration und Doppelnamen hinweg abgleichen (2026)?

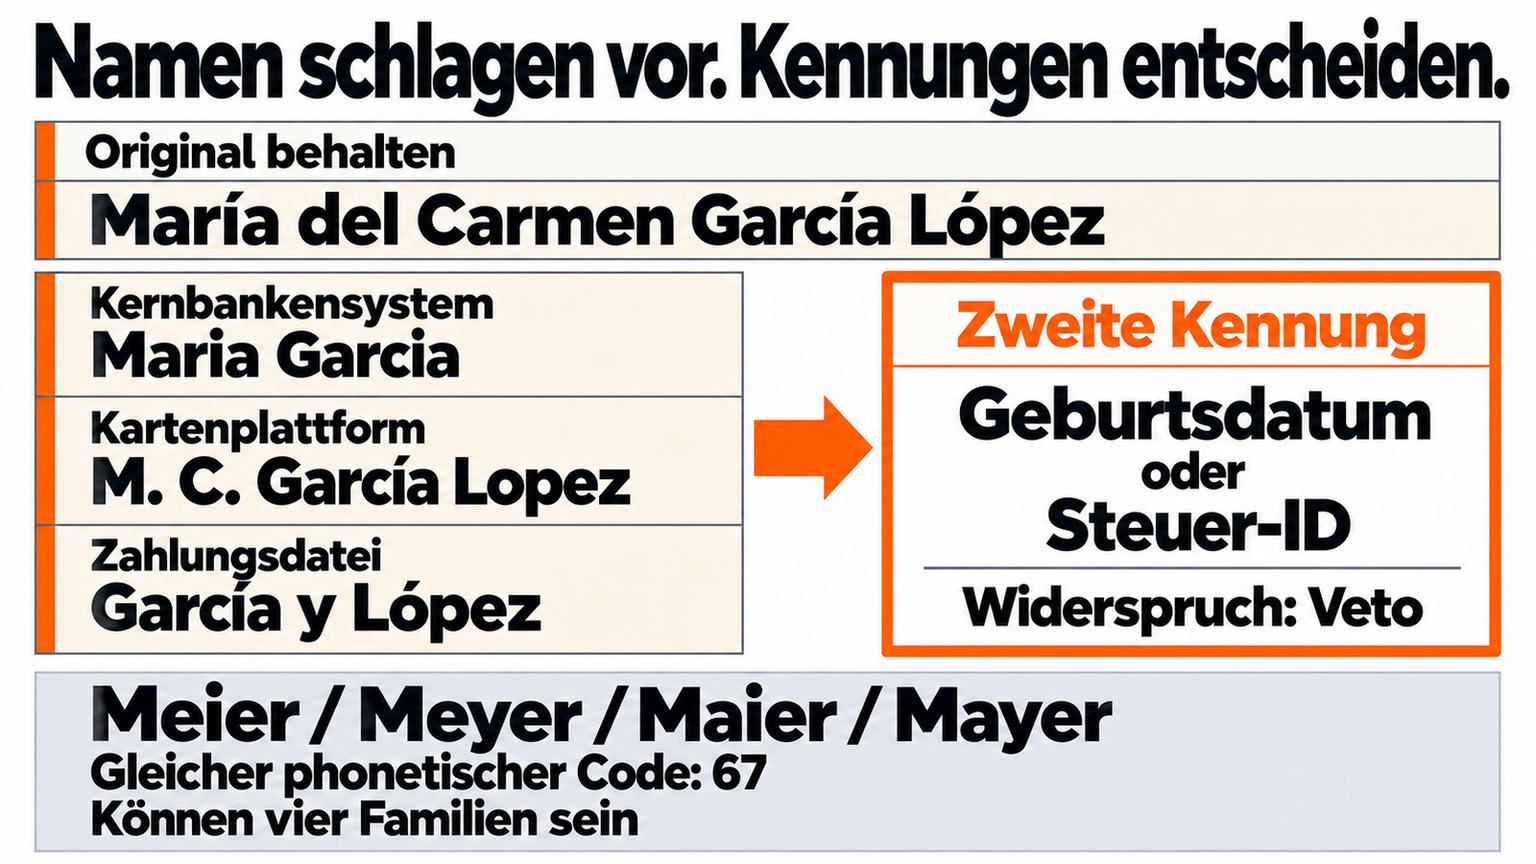
Kurzfassung: Eine Bank sollte Kundennamen nach Variantenklasse abgleichen, nicht mit einem einzigen Fuzzy-Score. Behalten Sie den Namen wie geliefert, zerlegen Sie ihn in Bestandteile, speichern Sie transliterierte Formen und Formen ohne diakritische Zeichen neben dem Original und vergleichen Sie jeden Bestandteil mit der passenden Methode. Für KYC- und Kundendaten-Teams: Ein Name schlägt einen Treffer vor, eine andere Kennung entscheidet ihn.
Demo buchen · Tilores Studio kostenlos testen
Auf dieser Seite
- Wie sollte eine Bank Kundennamen über Schreibweisen, Schriften und Nachnamen hinweg abgleichen?
- Warum muss die Originalschreibweise jede Transformation überstehen?
- Warum sollte ein Name vor dem Vergleich in Bestandteile zerlegt werden?
- Welche Vergleichsmethode passt zu welcher Variantenklasse?
- Warum sollte ein Name nie allein über eine Zusammenführung entscheiden?
- Wann muss ein Name für sich allein stehen?
- Wie sollte eine Bank das Namens-Matching vor Vertragsabschluss testen?
- Häufig gestellte Fragen
- Quellen
María del Carmen García López, eine fiktive Kundin, beantragt ein Girokonto. Ihr Kernbankensystem führt sie bereits als Maria Garcia, die Kartenplattform als M. C. García Lopez und die Zahlungsdatei als García y López. Der Dublettenabgleich verknüpft keinen dieser Datensätze, also bittet jemand darum, die Schwelle für das Fuzzy Matching zu lockern.
Lockern Sie sie so weit, dass der Abgleich sie findet, und er verbindet bald Menschen, die nur ähnlich klingen. Im Kölner Phonetik-Code, der für deutsche Namen entwickelt wurde, werden Meier, Meyer, Maier und Mayer alle zu 67, und das können vier verschiedene Familien sein. Ein lockererer Score tauscht verpasste Verknüpfungen gegen falsche Zusammenführungen.
Wir halten diesen Tausch für vermeidbar. Namensvarianten fallen in getrennte Klassen, jede mit ihrer eigenen Lösung, und ein Name sollte einen Treffer immer nur vorschlagen. Ein Geburtsdatum, eine Steuer-ID oder eine Adresshistorie entscheidet ihn.
Wie sollte eine Bank Kundennamen über Schreibweisen, Schriften und Nachnamen hinweg abgleichen?
Behandeln Sie jede Art von Abweichung als eigenes Problem. Speichern Sie den Namen wie geliefert, zerlegen Sie ihn in Bestandteile, halten Sie transliterierte Formen und Formen ohne diakritische Zeichen in abgeleiteten Feldern neben dem Original, vergleichen Sie jeden Bestandteil mit der Methode, die zu seiner Klasse passt, und überlassen Sie die endgültige Entscheidung einer Kennung, die nicht der Name ist.
Die Abweichung ist groß. In einer Studie des US Census Bureau zur Untererfassung, über die William Winkler berichtet, stimmten 25 Prozent der Vornamen und 15 Prozent der Nachnamen bei Paaren, die echte Treffer waren, nicht Zeichen für Zeichen überein. Das ist ein US-Bevölkerungsbestand und keine Bankdaten, aber es zeigt die Größenordnung, noch bevor eine zweite Schrift oder ein Doppelname ins Spiel kommt.
Es ist auch nicht ein einziges Problem. Acht Klassen verursachen den Großteil der Abweichungen, und eine Lösung für die eine kann eine andere beschädigen, deshalb halten wir sie getrennt. Alle Namen in der Tabelle sind fiktiv.
| Variantenklasse | Fiktives Beispiel | Was schiefgeht | Erste Behandlung | Risiko, das es zu steuern gilt |
|---|---|---|---|---|
| 1. Kodierung und diakritische Zeichen | Müller als ein Zeichen oder als u plus kombinierendes Zeichen gespeichert; dazu Muller und Mueller | Auf dem Bildschirm identisch, in den Bytes verschieden; der Umlaut fällt weg oder wird ausgeschrieben | Eine Unicode-Normalform beim Einlesen, dazu ein Vergleichsfeld ohne diakritische Zeichen | Das Vergleichsfeld darf das Original nie überschreiben |
| 2. Buchstaben ohne Grundbuchstaben | Weiß und Weiss; Yılmaz und Yilmaz | Das Entfernen diakritischer Zeichen lässt ß und ı unberührt, Weiß und Weiss bleiben also zwei Änderungen auseinander | Eine explizite, versionierte Ersetzung in einem eigenen Vergleichsfeld | Die Ersetzung an gelabelten Paaren testen; nie auf Kennungen anwenden |
| 3. Transliteration zwischen Schriften | Юлія Гриценко, Юлия Гриценко, Yuliia Hrytsenko, Yuliya Gritsenko | Jede Sprache hat ihre eigene Buchstabentabelle | Nach der Sprache des Datensatzes transliterieren, die Originalschrift behalten, beide vergleichen | Die Romanisierung lässt sich nicht verlässlich umkehren |
| 4. Schreibvarianten innerhalb einer Schrift | Mohammed, Muhammad, Mohamed; Meier, Meyer, Maier, Mayer | Kurzvokale und örtliche Konventionen schwanken | Phonetischer Code oder Editierdistanz, immer neben einem zweiten Feld | Phonetische Codes fassen verschiedene Familien zusammen |
| 5. Doppelte und mehrteilige Familiennamen | García López, García y López, Arnheim-Bauer, Arnheim Bauer | Teile fallen weg oder werden mit Bindestrich, Leerzeichen oder Bindewort verbunden | In Familiennamen und zweiten Familiennamen zerlegen; Token-Regeln nutzen | Ein gemeinsamer Namensteil ist allein ein schwaches Indiz |
| 6. Namensreihenfolge und Namenszusätze | van der Berg, Joost und Joost van der Berg | Der Familienname steht nicht immer am Ende | Ein Komma als Familienname zuerst lesen; Zusätze beim Familiennamen belassen | Listen der Zusätze unterscheiden sich je Sprache |
| 7. Initialen, Abkürzungen und Kurzformen | M. C. García; Kate und Catherine | Token fehlen oder sind durch einen Alias ersetzt | Aliasliste nur zusammen mit stärkeren Indizien einsetzen | Kurze Namen brauchen eine strengere Editierdistanz |
| 8. Geänderte Namen | Catherine Brandt, später Catherine Okafor | Kein Zeichenkettenvergleich überbrückt einen neuen Nachnamen | Über andere Kennungen verknüpfen: Geburtsdatum, Steuer-ID, Adresshistorie | Die anderen Kennungen dürfen sich nicht widersprechen |
Nur Klasse 1 ist rein mechanisch. Der Unicode-Standard behandelt ein vorkomponiertes ü und ein u mit kombinierendem Trema als kanonisch äquivalent, doch es sind verschiedene Bytefolgen, also klärt eine festgelegte Normalform beim Einlesen die Sache. Jede andere Klasse verlangt eine Entscheidung, und die erste betrifft das, was erhalten bleibt.
Warum muss die Originalschreibweise jede Transformation überstehen?
Die Originalschreibweise muss erhalten bleiben, weil sich manche Korrekturen nicht rückgängig machen lassen. Transliteration ist der deutlichste Fall, denn jeder Standard nutzt seine eigene Buchstabentabelle. Die BGN/PCGN-Tabellen der US-amerikanischen National Geospatial-Intelligence Agency romanisieren г in der russischen Tabelle als g und in der ukrainischen Tabelle als h. Гриценко ergibt daher als Russisch gelesen Gritsenko und als Ukrainisch gelesen Hrytsenko.
Auch der Vorname spaltet sich: Юлия wird in der russischen Tabelle zu Yuliya und Юлія in der ukrainischen zu Yuliia, und die ukrainische Tabelle warnt zudem, dass sie für die Rücktransliteration nicht empfohlen wird. Eine Pipeline, die die Originalschreibweise durch eine einzige lateinische Form ersetzt, hat das Beweismaterial weggeworfen, mit dem sie ihre eigene Vermutung prüfen könnte.
Die Herausgeber von Sanktionslisten führen bereits beide Formen. Das Format der britischen Sanktionsliste erfasst einen Hauptnamen, Schreibvarianten dieses Namens und eine eigene Fassung in nicht lateinischer Schrift samt Schrift und Sprache. OpenSanctions, die offene Datenquelle für Sanktionen und PEPs, transliteriert nur dort, wo das Ergebnis verlässlich ist, und vergleicht Namen sonst in der Originalschrift.
Wir haben unseren Namens-Normalisierer nach demselben Prinzip gebaut. Version 2, am 14. September 2026 veröffentlicht, transliteriert Namen in kyrillischer, griechischer, armenischer, georgischer, arabischer, persischer, Urdu-, hebräischer, Hangul-, Kana-, chinesischer Han-, Devanagari- oder bengalischer Schrift in firstName und lastName ins Lateinische und behält das Original in firstNameNative und lastNameNative, wie unsere Referenzlisten und unsere Transformer-Referenz darlegen. Um die Tabelle zu wählen, liest er die Sprache des Datensatzes oder, wenn keine Sprache angegeben ist, dessen Land.
Die Grenzen zählen ebenfalls. Arabisch und Hebräisch schreiben Kurzvokale nicht, und japanische Kanji haben keine eigene Lesung, daher ordnet eine kleine Liste die häufigen Namensbestandteile zu, und alles andere fällt auf die Buchstaben zurück. Schreibvarianten bleiben wie geschrieben: ahmed und ahmad erreichen die Vergleichsschicht als zwei Zeichenketten, weshalb wir auch die Originalausgaben vergleichen. Das Original zu behalten klärt, was gespeichert wird. Die nächste Frage ist, was verglichen wird, und der vollständige Name ist dafür die falsche Einheit.
Neue Beiträge zu Entity Resolution, Identitätsdaten und KI. Kein Spam, Abmeldung jederzeit möglich.
Warum sollte ein Name vor dem Vergleich in Bestandteile zerlegt werden?
Ein Name sollte zerlegt werden, weil viele Kunden mehr als einen Familiennamen tragen und die Teile unabhängig voneinander zwischen Systemen wandern. Das spanische Registerrecht lässt die Eltern die Reihenfolge ihrer jeweils ersten Nachnamen vereinbaren und erlaubt de, y oder i zwischen ihnen, wie Artikel 49 des Gesetzes 20/2011 festlegt. Eine Person kann daher als García López, García y López oder schlicht García auftreten.
Deutschland hat am 1. Mai 2025 eine Variante hinzugefügt. Ehepaare können nun einen Doppelnamen aus beiden Familiennamen wählen, und Kinder können einen Doppelnamen als Geburtsnamen erhalten, wie das Bundesministerium der Justiz mit den Beispielen Arnheim-Bauer und Bauer-Arnheim erläutert. Das Bürgerliche Gesetzbuch macht den Bindestrich zur Regel und erlaubt den Ehegatten, etwas anderes zu erklären, sodass Arnheim-Bauer und Arnheim Bauer beide rechtmäßige Schreibweisen desselben Namens sein können.
Im Vereinigten Königreich akzeptiert das HM Passport Office eine Heirats- oder Lebenspartnerschaftsurkunde für einen neuen Doppelnamen, sodass sich ein Pass ändern kann, bevor die Datensätze der Bank folgen.
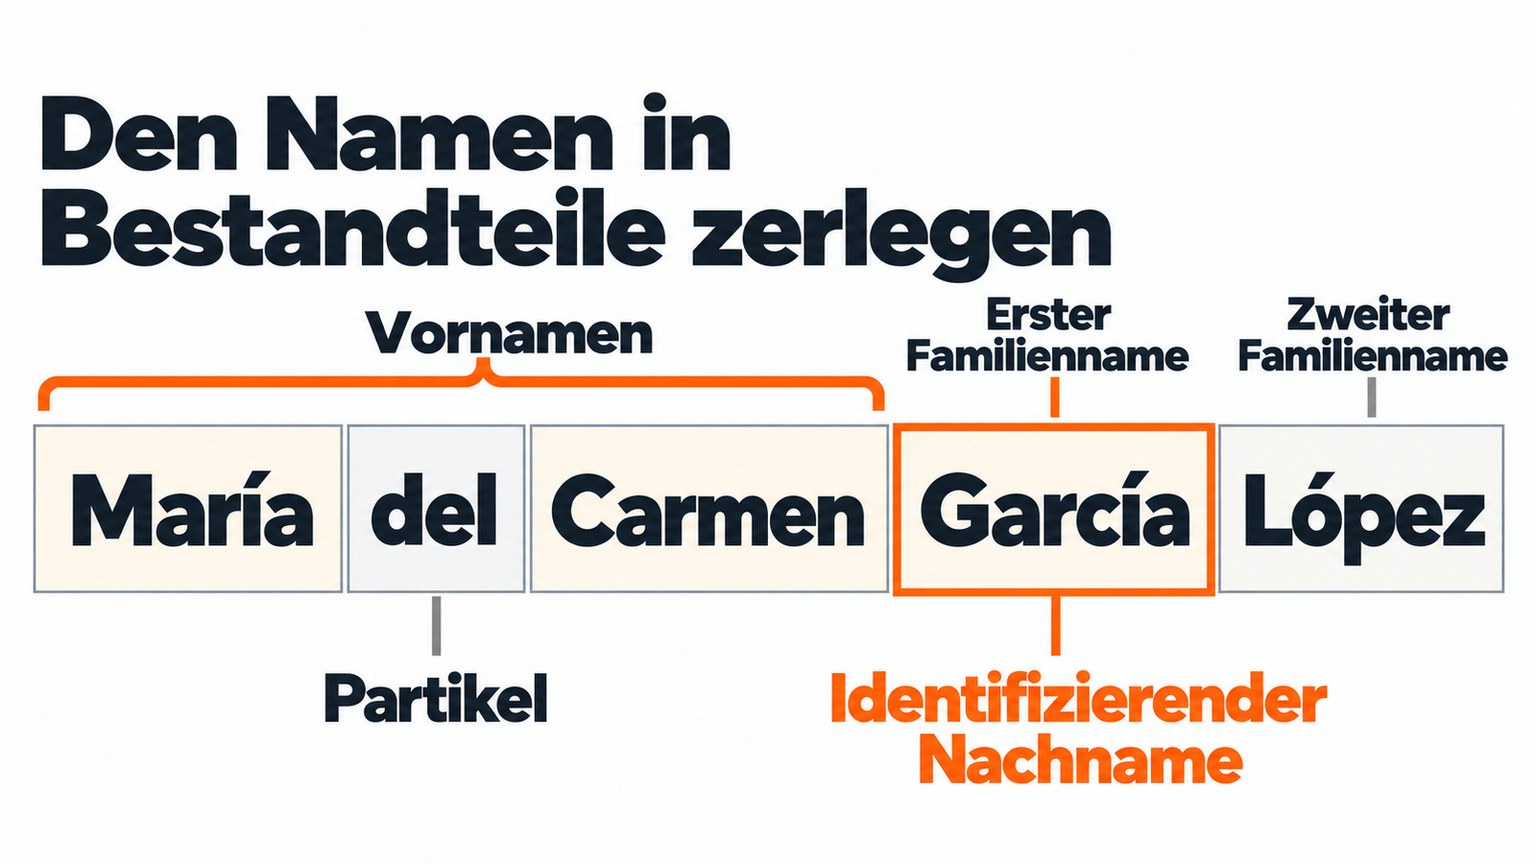
Als eine Zeichenkette verglichen, scheitert García López an García und Arnheim-Bauer an Arnheim Bauer. In Bestandteile zerlegt, hat jeder Teil ein kleineres, saubereres Ziel. Unser Normalisierer zerlegt einen Namen in Titel, Vornamen, weitere Vornamen, Familienname, zweiten Familiennamen und Namenszusatz und nutzt dafür Referenzlisten, die nach Land und Sprache gegliedert sind. Bei einem spanischen Namen legt er den identifizierenden Nachnamen in lastName und den anderen in secondaryLastName, bei einem portugiesischen Namen vertauscht er die Rollen, sodass der identifizierende Nachname den Treffer trägt und der zweite ihn stützt.
Derselbe Parser belässt Namenszusätze beim Familiennamen, liest ein Komma als Familienname zuerst und entfernt Apostrophe, sodass van der Berg, Joost zu Joost van der Berg passt und O’Brien zu OBrien. Wo die Zahl der Teile weiterhin abweicht, schließt eine Token-Regel die Lücke. Unsere Strategie der Mindesttreffer verlangt eine festgelegte Zahl übereinstimmender Token in beliebiger Reihenfolge, sodass bei zwei verlangten Token John Smith zu John Smith-Doe und zu Smith John passt.
Eine Grenze gilt: Ein Wert aus nur einem Wort füllt keinen der beiden Namensteile, weil nichts einen Vornamen allein von einem Familiennamen allein unterscheidet. Stehen die Bestandteile fest, bleibt die Frage, welcher Vergleich auf jedem läuft.
Welche Vergleichsmethode passt zu welcher Variantenklasse?
Gleichen Sie jede Klasse mit der Methode ab, die für sie gebaut ist, und nehmen Sie in Kauf, dass jede Methode an anderer Stelle kollidiert. Peter Christens Vergleich von Verfahren zum Abgleich von Personennamen auf vier großen Namensdatensätzen fand kein eindeutig bestes Verfahren, deshalb wählen wir die Methode nach Klasse und testen sie an den eigenen Paaren der Bank.
Wo helfen phonetische Codes, und wo kollidieren sie?
Phonetische Codes erfassen Schreibweisen, die gleich klingen, und sind günstig zu berechnen. Der Kölner Phonetik-Code, für das Deutsche entwickelt, vergibt für Müller, Mueller und Muller denselben Code, 657. Gerade diese Günstigkeit ist das Risiko aus der Einleitung: Meier, Meyer, Maier und Mayer ergeben alle 67 und Schmidt, Schmitt und Schmid alle 862, obwohl jede Schreibweise zu einer anderen Familie gehören kann. Ein phonetischer Treffer ist ein Kandidat für die nächste Schicht, keine Entscheidung.
Wie viel Editierdistanz sollte ein Name bekommen?
Die Editierdistanz zählt Änderungen an einzelnen Zeichen und eignet sich daher für Tippfehler. Ein Name braucht eine strenge Grenze, weil eine Änderung bei einem kurzen Namen einen großen Anteil ausmacht. Unsere Standardeinstellung der dynamischen Textdistanz erlaubt unter vier Zeichen keine Änderung und ab vier Zeichen eine, wodurch Mia und Moe getrennt bleiben.
Deshalb kommen abgeleitete Felder vor dem Vergleich. Ein ausgeschriebener Umlaut kostet zwei Änderungen, von Müller zu Mueller, und liegt damit außerhalb dieser Grenze. Werden diakritische Zeichen zuerst auf ihren Grundbuchstaben zurückgeführt, kostet es eine Änderung, innerhalb der Grenze. Weiß und Weiss bleiben auch danach zwei Änderungen auseinander, weil ß keinen Grundbuchstaben hat; diese Klasse braucht vor dem Vergleich eine explizite Ersetzung von ß durch ss.
Wann ist eine Kurzformen-Liste sicher einsetzbar?
Unser Vergleich von Rufnamen schlägt Namen in einer Aliasliste nach, sodass Mike zu Michael passt. Eine Kurzform kann für viele Namen stehen, deshalb sollte sie nur neben strengeren Indizien laufen. Kate und Catherine sind eine faire Verknüpfung, wenn Familienname und Geburtsdatum übereinstimmen, und eine schlechte, wenn nur der Vorname übereinstimmt.
Jede dieser Methoden erzeugt irgendwo falsche Kandidaten. Das ist unter einer Bedingung hinnehmbar: Etwas anderes als der Name trifft die endgültige Entscheidung.
Warum sollte ein Name nie allein über eine Zusammenführung entscheiden?
Ein Name sollte nie allein über eine Zusammenführung entscheiden, weil auch der engste Namens-Match zwei Menschen mit demselben Namen nicht auseinanderhalten kann, und das kann nur eine zweite Kennung. Eine Konsistenzregel macht daraus ein Veto. Unsere Konsistenzregeln prüfen den eingehenden Datensatz gegen jeden Datensatz, der bereits in der Kandidaten-Entität liegt, und widerspricht einer davon, ist diese Entität kein Kandidat, wie unser Leitfaden zu gleichnamigen Kunden zeigt.
Die Kennungen entscheiden auch in die andere Richtung. Wenn aus Catherine Brandt Catherine Okafor wird, überbrückt kein Zeichenkettenvergleich den neuen Nachnamen, und ein übereinstimmendes Geburtsdatum, eine Steuer-ID oder eine Adresshistorie stellt die Verknüpfung her. Ob der Name entscheidet oder nur vorschlägt, unterscheidet die drei Aufbauten, die Banken üblicherweise betreiben.
| Aufbau | Was passiert | Wo er passt | Wo er zu kurz greift |
|---|---|---|---|
| Ein bereinigter Name, auf Gleichheit verglichen | Jeder Name wird auf eine lateinische Zeichenkette reduziert und auf Gleichheit geprüft | Schnell und leicht zu erklären, wenn alle Quellen dieselbe Konvention nutzen | Verfehlt die meisten Klassen oben, und die Bereinigung verwirft das Original |
| Ein phonetischer Code oder Fuzzy-Score je Name | Jeder Name wird zu einem Code oder einem Ähnlichkeitswert; ein ausreichend naher Wert zählt als Treffer | Günstig; gut bei Schreibweisen, die gleich klingen | Führt verschiedene Familien zusammen, die gleich klingen; blind für Reihenfolge, Schriften und Doppelnamen |
| Bestandteile, abgeleitete Felder und Vergleich in Schichten (unser Ansatz) | Wir behalten das Original, zerlegen den Namen, ergänzen abgeleitete Felder, vergleichen nach Klasse und lassen eine Konsistenzregel ein Veto einlegen | Passt zu Kunden mit verschiedenen Schriften, Namenskonventionen und mehreren Altsystemen | Braucht Regeln, Referenzlisten und ein gelabeltes Testset; ein Wert aus nur einem Wort füllt keinen Namensteil |
In welcher Reihenfolge sollten die Matching-Schichten laufen, Schritt für Schritt?
Die Reihenfolge zählt mehr als jede einzelne Methode, und kein Schritt berührt das Original.
- Den Namen so speichern, wie er geliefert wird. Originalwert, Quellsystem, Datensatz-ID und Zeitpunkt des Einlesens vor jeder Transformation festhalten. Wir normalisieren und persistieren eingelesene Daten und behalten die Originale, damit bei der Prüfung jederzeit sichtbar ist, was eine Quelle geliefert hat.
- Den Namen in Bestandteile zerlegen. Titel, Vornamen, Familienname, zweiter Familienname und Namenszusatz trennen; ein Komma als Familienname zuerst lesen und Zusätze beim Familiennamen belassen.
- Transliterieren und in abgeleitete Felder überführen. Eine Unicode-Normalform anwenden, nach der Sprache des Datensatzes transliterieren, diakritische Zeichen entfernen und explizite Ersetzungen wie ß zu ss ergänzen, jeweils als eigenes, versioniertes Feld.
- Jeden Bestandteil mit der Methode vergleichen, die zu seiner Klasse passt. Exakter Vergleich bei verlässlichen Bestandteilen, phonetische Codes oder Editierdistanz bei Schreibvarianten, Token-Regeln bei Reihenfolge und Doppelnamen, Aliaslisten nur neben stärkeren Indizien.
- Eine Konsistenzregel ein Veto einlegen lassen. Eine Verknüpfung blockieren, wenn sich Geburtsdatum oder Steuer-ID widersprechen, egal wie ähnlich die Namen sind.
- Unsichere Paare zur Prüfung leiten und die Regel protokollieren. Paare zwischen den Schwellen für automatische Zusammenführung und automatische Ablehnung an einen Data Steward geben und die Regel festhalten, die jede Verknüpfung erzeugt hat. Jeder Match wird als Graph-Kante gespeichert, die die zugehörige Regel festhält, und unser Leitfaden zu Review Queues behandelt die Warteschlange selbst.
Wann muss ein Name für sich allein stehen?
Ein Name muss im Watchlist-Screening für sich allein stehen, und das ist eine andere Aufgabe als die Zusammenführung von Kunden. Das Screening gegen Sanktionslisten, PEP-Listen und Adverse Media vergleicht einen Namen mit einem Listeneintrag oder einem Nachrichtenbericht, oft mit wenigen anderen Feldern, die ein Veto erlauben würden. Es ist darauf ausgelegt, bei einem möglichen Treffer Alarm zu schlagen, und Analysten wollen jeden relevanten Alarm bei möglichst wenig Fehlalarmen, wie OpenSanctions beschreibt. Diese Toleranz wäre bei der Zusammenführung zweier Kunden falsch.
Unsere Entity Resolution arbeitet neben dem Screening-Prozess einer Bank und ersetzt ihn nicht. Wir übergeben dem Screening ein aufgelöstes Kundenprofil mit den Originalnamen, den abgeleiteten Varianten und der Regelspur, damit das Screening-Team jede Schreibweise durchsuchen kann, die ein Kunde verwendet hat. Die Listen und Schwellen bleiben bei den Screening-Kontrollen der Bank, oft gespeist aus offenen Daten wie OpenSanctions. Ist ein einzelner Name gegen eine Liste zu prüfen und sonst nichts bekannt, ist eine Screening-Engine das richtige Werkzeug, und wir liefern ihr saubere Eingaben.
Adverse Media ist der schwierigste Fall, weil der Name in Nachrichtentext ankommt; die Variantenliste im Profil gibt dem Team deshalb mehr zum Suchen. Und wo die eigenen Datensätze einer Bank überhaupt keine zweite Kennung enthalten, kann kein Aufbau entscheiden, ob zwei gleichnamige Datensätze eine Person sind. Solche Paare gehören in die Prüfung, nicht in eine automatische Zusammenführung.
Wie sollte eine Bank das Namens-Matching vor Vertragsabschluss testen?
Eine Bank sollte das Namens-Matching Klasse für Klasse an den eigenen Daten testen. Bauen Sie für jede Variantenklasse ein eigenes gelabeltes Set statt eines gemeinsamen, damit ein Gewinn beim Umlaut nicht einen Verlust bei der Transliteration verdeckt.
Als Beispiel mit ausgewiesenen Annahmen: acht Klassen, 100 gelabelte Paare je Klasse, 30 Sekunden für die Entscheidung je Paar und zwei Prüfer, die jedes Paar unabhängig beurteilen. Das sind 8 × 100 = 800 Paare. Bei 30 Sekunden je Paar ergeben 800 × 30 = 24.000 Sekunden rund 6,7 Stunden je Prüfer und 13,3 Prüferstunden insgesamt. Das sind Planungswerte und keine unserer Leistungsangaben; ersetzen Sie sie durch Ihre eigenen Prüfzeiten.
Ergänzen Sie ein Regressionsset naher Nachbarn: Meier und Meyer in einer Postleitzahl, Elternteil und Kind mit gleichem Namen, zwei Kunden mit demselben Doppelnamen. Berichten Sie Precision und Recall je Klasse, und lassen Sie das Set neu laufen, sobald sich eine Regel, eine Referenzliste oder eine Transformer-Version ändert, weil eine Änderung an einer Namensausgabe die Matching-Schlüssel ändert.
Die ersten Schichten können Sie an Ihrer eigenen Datei ausprobieren, bevor Sie mit einem Anbieter sprechen. Unser Tilores Studio führt Entity Resolution lokal mit bis zu 100.000 Datensätzen kostenlos aus, und unsere kostenlosen Fuzzy-Matching-Tools vergleichen zwei Zeichenketten über alle Algorithmen hinweg nebeneinander. Unser Leitfaden zur Normalisierung von Namen und Adressen behandelt die Adresshälfte desselben Problems.
Schreiben Sie dann die acht Klassen in den PoC-Testplan, vereinbaren Sie, wer welche Paare labelt, wie unser Leitfaden zur Abstimmung der Matching-Regeln mit dem Anbieter vor einem PoC beschreibt, und verlangen Sie von jedem Anbieter, uns eingeschlossen, Ergebnisse Klasse für Klasse. Hinter einer einzigen Gesamtgenauigkeit versteckt sich die gelockerte Schwelle.
Häufig gestellte Fragen
Sollte eine Bank jeden Namen vor dem Matching ins Lateinische transliterieren?
Nein. Transliterieren Sie in ein abgeleitetes Feld und behalten Sie die Originalschreibweise. Die Romanisierung lässt sich nicht verlässlich umkehren und verliert bei manchen Schriften an Genauigkeit, deshalb vergleichen wir auch die Originalausgaben.
Beweist ein phonetischer Treffer, dass zwei Namen zu einem Kunden gehören?
Nein. Ein phonetischer Code legt Namen, die gleich klingen, in einen gemeinsamen Behälter, und verschiedene Familien landen im selben Behälter. Behandeln Sie den Treffer als Kandidaten und bestätigen Sie ihn mit anderen Feldern.
Wie sollte eine Bank einen spanischen Namen mit zwei Nachnamen mit einem Datensatz abgleichen, der nur einen Nachnamen hat?
Vergleichen Sie zuerst den identifizierenden Familiennamen. Unser Parser legt ihn in lastName und den anderen Nachnamen in secondaryLastName ab, sodass ein Datensatz mit nur einem Nachnamen den vollen Namen trotzdem erreichen kann und der zweite Nachname die Sicherheit erhöht, wenn beide Datensätze ihn führen.
Liest unser Namens-Normalisierer Namen in arabischer Schrift?
Ja, mit einer klar benannten Grenze. Wir transliterieren den Namen ins Lateinische und behalten die Originalschreibweise in getrennten Ausgaben. Arabisch schreibt Kurzvokale nicht, daher ordnet eine kleine Liste häufige Namensbestandteile wie محمد zu mohammed zu, und alles andere fällt auf die Buchstaben zurück.
Kann ein Namens-Match allein zwei Kunden zusammenführen?
Nein. Ein starker Namens-Match ist ein Indiz, und eine Konsistenzregel auf einem Feld wie Geburtsdatum oder Steuer-ID kann die Zusammenführung trotzdem blockieren. Wir wenden diese Prüfung gegen jeden Datensatz der Kandidaten-Entität an.
Quellen
- Transformer Reference: Normalize Name (version 2), Tilores-Dokumentation.
- Text Comparison Reference, Tilores-Dokumentation.
- Matcher Reference, Tilores-Dokumentation.
- Reference Lists, Tilores-Dokumentation.
- Consistency, Tilores-Dokumentation.
- Release Notes, Version 0.97.0 (14. September 2026), Tilores-Dokumentation.
- Wie deutsche Banken Namen und Adressen vor Entity Resolution normalisieren sollten, Tilores.
- Erkennt Entity Resolution zwei Kunden mit demselben Namen als unterschiedliche Personen? Konsistenzregeln für Banken, Tilores.
- Review Queues für Entity Resolution: Menschliche Entscheidungen bei mehrdeutigen Matches im Jahr 2026, Tilores.
- Wie eine Bank und ihr Entity-Resolution-Anbieter sich vor einem PoC auf Matching-Regeln einigen, Tilores.
- Fuzzy Matching Algorithms: Free Online Tester, Tilores.
- Overview of Record Linkage and Current Research Directions, William E. Winkler, US Census Bureau Research Report Series, Statistics #2006-2.
- A comparison of personal name matching: techniques and practical issues, Peter Christen, Australian National University, 2006.
- Unicode Normalization Forms (UAX #15), Unicode Consortium.
- Romanization of Russian: BGN/PCGN 1947 System, US National Geospatial-Intelligence Agency.
- Romanization of Ukrainian: BGN/PCGN 2019 Agreement, US National Geospatial-Intelligence Agency.
- Format guide for the UK Sanctions List, GOV.UK.
- Rosetta, not Roulette: Improving sanctions screening results with our new logic-v2 matcher, OpenSanctions.
- Ley 20/2011, de 21 de julio, del Registro Civil, Artículo 49, Boletín Oficial del Estado.
- Neues Namensrecht gilt ab dem 1. Mai: Echte Doppelnamen für Ehepaare und Kinder sowie weitere Liberalisierungen, Bundesministerium der Justiz und für Verbraucherschutz, 29. April 2025.
- Bürgerliches Gesetzbuch, § 1355 Ehename, Bundesministerium der Justiz.
- Change your name or personal details on your passport: marriage and civil partnership, GOV.UK.
- ColognePhonetic (Apache Commons Codec API), The Apache Software Foundation.
Sehen Sie, was aufgelöste Entitätsdaten für Ihr Unternehmen — und Ihre KI — leisten.