Wie misst eine Bank die Genauigkeit von Entity Resolution 2026? Paarweise Präzision, Cluster-Metriken und die Zielwerte für den PoC

Kurzfassung: Eine Bank sollte Entity Resolution auf drei Ebenen bewerten: paarweise Precision und Recall für jede Verknüpfung, Cluster-Metriken für jedes Kundenprofil und Kandidaten-Recall für die Paare, die der Matcher nie verglichen hat. Formulieren Sie das PoC-Ziel als Rate falscher Zusammenführungen und Rate übersehener Verknüpfungen je Quellenschnitt, mit Stichprobengröße und Konfidenz.
Demo buchen · Tilores Studio kostenlos testen
Auf dieser Seite
- Wie sollte eine Bank die Genauigkeit von Entity Resolution messen?
- Warum kann dasselbe Ergebnis bei Paaren gewinnen und bei Profilen verlieren?
- Warum verbirgt eine hohe paarweise Precision verunreinigte Kundenprofile im Bankmaßstab?
- Warum endet der Recall bei der Kandidatenerzeugung?
- Warum sind die Genauigkeitswerte zweier Anbieter selten vergleichbar?
- Wie sollte eine Bank die Messung Schritt für Schritt durchführen?
- Wie groß muss die PoC-Stichprobe sein, und welches Ziel sollte die Bank setzen?
- Häufig gestellte Fragen
- Quellen
Die PoC-Auswertung eines Anbieters meldet 98 % Precision, und die Folie sieht nach einer Antwort aus. Das ist sie noch nicht, denn niemand hat gesagt, was gezählt wurde: Datensatzpaare, fertige Kundenprofile oder einzelne Datensätze, und nach wessen Labels. Schon bei zehn gewöhnlichen Datensätzen setzt der paarweise F1-Wert ausgerechnet das System auf Platz eins, das den Datensatz eines Haushaltsmitglieds im Profil eines anderen Kunden ablegt.
Eine Bank bezahlt die beiden Fehlerarten unterschiedlich. Ein übersehener Treffer lässt einen Kunden auf zwei Profile verteilt zurück. Ein falscher Treffer legt die Daten einer Person in das Profil einer anderen, was unser Leitfaden zu falschen Kundenzusammenführungen als möglichen Datenschutzvorfall einordnet.
Deshalb vertreten wir die Position, dass die Zahl, die eine Bank unterschreibt, Profile zählen sollte. Paarweise Precision und Recall gehören weiterhin in den Bericht, neben die Profilwerte und nie an ihre Stelle.
Wie sollte eine Bank die Genauigkeit von Entity Resolution messen?
Messen Sie auf drei Ebenen, und schreiben Sie den Vertrag auf die Ebene, auf der Kunden Schaden nehmen. Paarweise Precision und Recall bewerten jede Verknüpfung. Cluster-Metriken bewerten jedes fertige Kundenprofil. Der Kandidaten-Recall zählt, wie viele echte Treffer den Matcher überhaupt erreicht haben.
Der Bericht braucht alle drei, das Ziel gehört aber auf die Profile, weil ein Kunde oder eine Aufsicht ein Profil sieht und weil Paarzählungen zwei Systeme in die falsche Reihenfolge bringen können. Zehn Datensätze zeigen, wie.
Warum kann dasselbe Ergebnis bei Paaren gewinnen und bei Profilen verlieren?
Die Paarzählung gibt einem großen Profil weit mehr Gewicht als einem kleinen. Deshalb kann ein System eine falsche Verknüpfung bilden und beim paarweisen F1-Wert trotzdem vorn liegen.
Wie werden paarweise Precision und Recall berechnet?
Die paarweise Bewertung zerlegt jeden Cluster in die Paare, die er enthält, und vergleicht die Paare des Systems mit den echten Paaren. Precision ist der Anteil der vorhergesagten Paare, die stimmen, und sie zählt den ersten Fehler, den Fellegi und Sunter 1969 benannt haben: Datensätze zu verknüpfen, die kein Treffer sind. Recall ist der Anteil der echten Paare, die das System gefunden hat, und er zählt den zweiten: Datensätze nicht zu verknüpfen, die zusammengehören. Ein Cluster aus n Datensätzen enthält n(n-1)/2 Paare, fünf Datensätze ergeben also zehn Paare, nicht fünf.
Was zeigt ein Beispiel mit zehn Datensätzen?
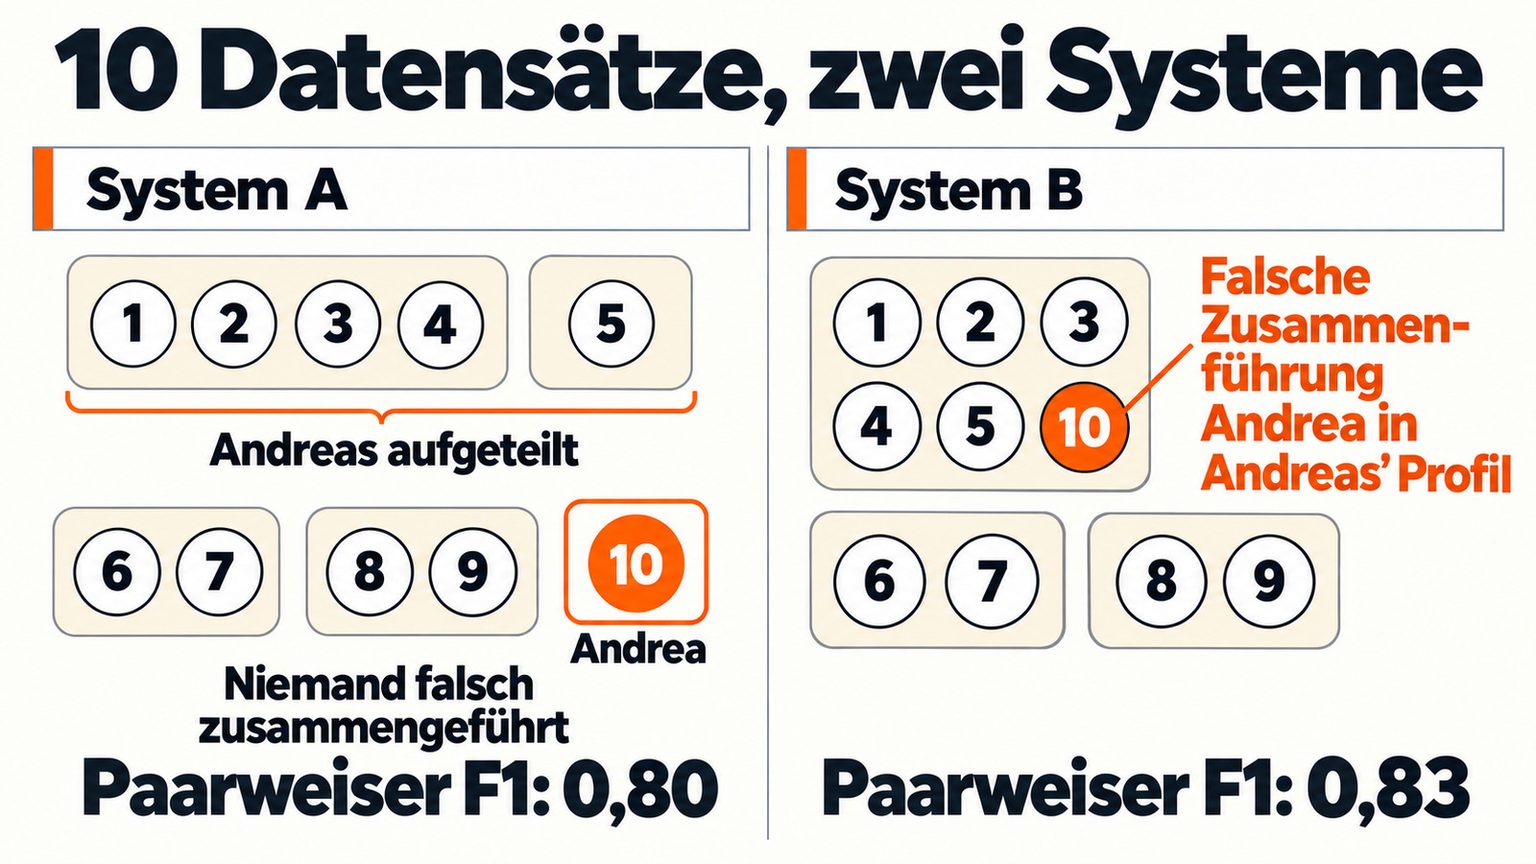
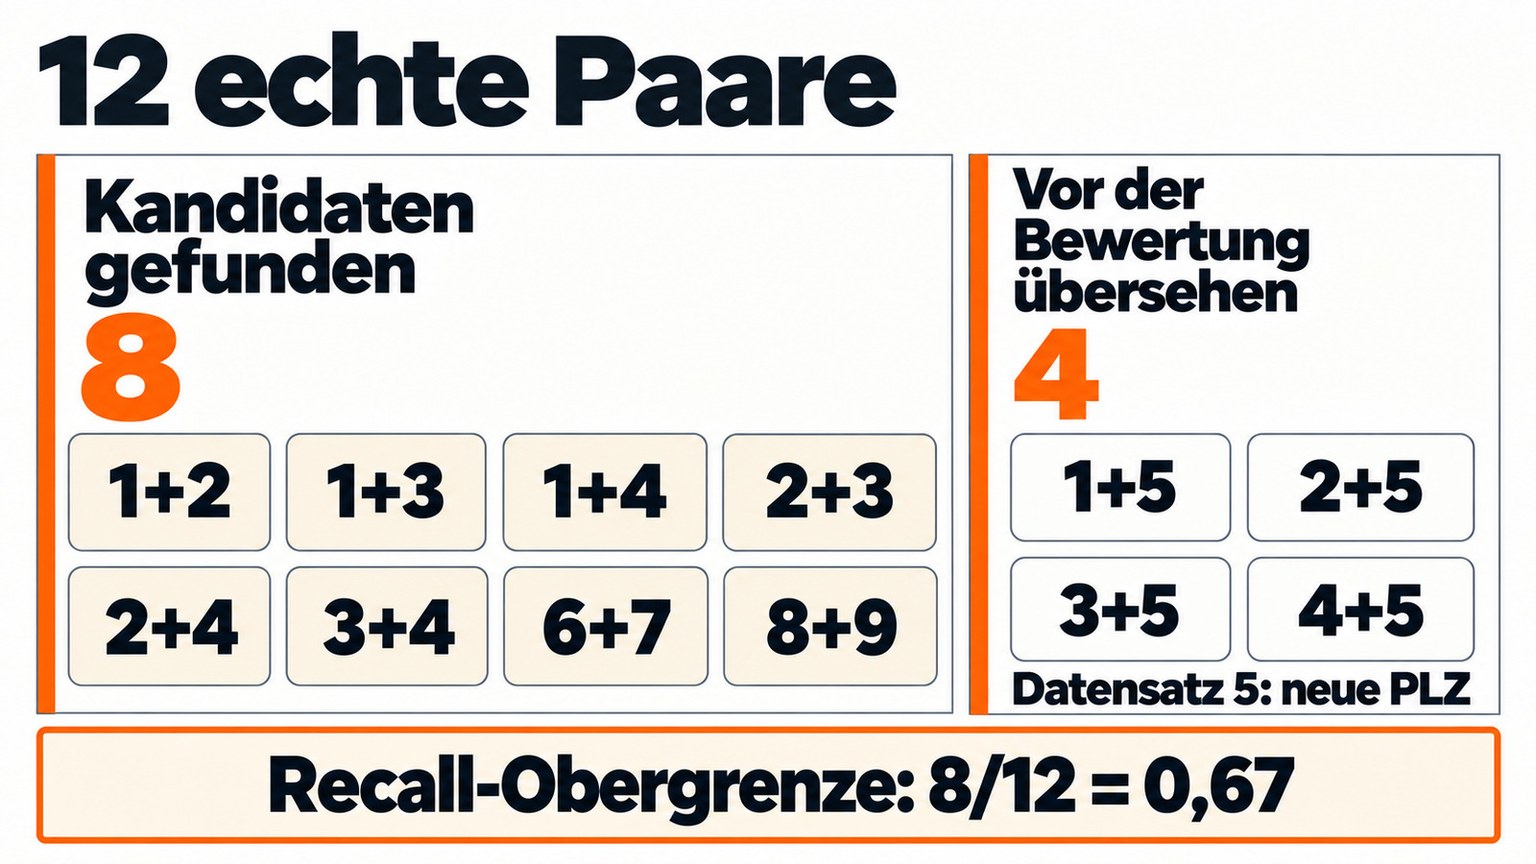
Zehn Datensätze gehören zu vier echten Kunden. Kunde P ist Andreas Müller, mit fünf Datensätzen in fünf Systemen; sein Darlehensdatensatz trägt nach einem Umzug eine neue Postleitzahl. Kundin S ist Andrea Müller, ein Haushaltsmitglied unter der alten Adresse, das nie mit ihm zusammengeführt werden darf. Es gibt 12 echte Paare: zehn innerhalb von P, eines innerhalb von Q und eines innerhalb von R.
| Datensatz | Quellsystem | Gespeicherter Name | PLZ | Echter Kunde |
|---|---|---|---|---|
| 1 | CRM | Andreas Müller | 10115 | P |
| 2 | Kernbanksystem | Andreas Mueller | 10115 | P |
| 3 | Karte | A. Müller | 10115 | P |
| 4 | App | Müller, Andreas | 10115 | P |
| 5 | Darlehen | Andreas Müller | 80331 | P |
| 6, 7 | CRM, Karte | Katarina Nowak, K. Nowak | 50667 | Q |
| 8, 9 | CRM, App | Jonas Weber, J. Weber | 20095 | R |
| 10 | CRM | Andrea Müller | 10115 | S |
System A liefert {1, 2, 3, 4}, {5}, {6, 7}, {8, 9} und {10}. Es sagt 8 Paare voraus, und alle 8 stimmen, die Precision beträgt also 1,00. Es hat 8 von 12 echten Paaren gefunden, der Recall liegt damit bei 0,67 und der F1-Wert bei 0,80. Es hat den Darlehensdatensatz nach dem Umzug übersehen und niemanden falsch zusammengeführt.
System B liefert {1, 2, 3, 4, 5, 10}, {6, 7} und {8, 9}. Es sagt 17 Paare voraus, davon sind 12 richtig: Die Precision beträgt 0,71, der Recall 1,00 und der F1-Wert 0,83. Seine einzige falsche Verknüpfung, zwischen dem Datensatz von Andrea und dem Profil von Andreas, erzeugt fünf falsche Paare, weil das Profil nun sechs Datensätze enthält. Der paarweise F1-Wert setzt System B dennoch auf Platz eins.
Was ändert sich, wenn Sie stattdessen das Profil bewerten?
Cluster-Metriken beurteilen das fertige Profil, und bei diesen zehn Datensätzen kehren sie die Rangfolge um. Berichten Sie drei davon, die letzte so, wie unser Bake-off-Leitfaden sie definiert:
- Die exakte Cluster-Precision ist der Anteil der vorhergesagten Cluster, die einem echten Cluster gleichen, und der exakte Cluster-Recall der Anteil der echten Cluster, die vollständig rekonstruiert wurden. Ein einziger fremder Datensatz verdirbt ein Profil, das Maß ist daher hart, aber leicht zu lesen.
- B-Cubed vergleicht für jeden Datensatz seinen vorhergesagten Cluster mit seinem echten Cluster. Die Precision fragt, wie viel des vorhergesagten Clusters zum Kunden des Datensatzes gehört, der Recall, wie viel vom echten Profil des Kunden der Cluster erfasst. Binette und Kolleginnen und Kollegen mitteln zuerst innerhalb jedes Kunden und dann über die Kunden, sodass ein Kunde mit einem Datensatz so viel zählt wie einer mit fünf.
- Rate falscher Zusammenführungen und Rate übersehener Verknüpfungen zählen Profile: vorhergesagte Cluster mit mehreren Datensätzen, die mehr als einen echten Kunden enthalten, und echte Kunden mit mehreren Datensätzen, die aufgeteilt wurden.
| Maß für die zehn Datensätze | System A | System B | Liegt vorn |
|---|---|---|---|
| Paarweise Precision, Recall, F1 | 1,00; 0,67; 0,80 | 0,71; 1,00; 0,83 | B bei F1 |
| Exakte Cluster-Precision, -Recall, -F1 | 0,60; 0,75; 0,67 | 0,67; 0,50; 0,57 | A |
| B-Cubed-Precision, -Recall, -F1 | 1,00; 0,92; 0,96 | 0,75; 1,00; 0,86 | A |
| Verunreinigte Profile (falsche Zusammenführungen) | 0 von 3 | 1 von 3 | A |
| Aufgeteilte Kunden (übersehene Verknüpfungen) | 1 von 3 | 0 von 3 | B |
Der paarweise F1-Wert wählt System B, während exakte Cluster-Werte, B-Cubed und falsche Zusammenführungen System A wählen; nur die übersehenen Verknüpfungen sprechen für B. Menestrina, Whang und Garcia-Molina fanden, dass solche Konflikte zwischen Maßen häufig auftreten, weil jedes Maß einen anderen Aspekt des Ergebnisses bewertet. Eine Bank, die eine falsche Zusammenführung als Datenvorfall behandelt, sollte A wählen, und der Vertrag kann das nur ausdrücken, wenn er die Zähleinheit nennt.
Warum ist ein einzelner F1-Wert eine schwache Grundlage für ein Ziel?
Die Umkehrung zeigt die erste Schwäche: F1 verbirgt, welchen Fehler Sie einkaufen. Hand und Christen zeigen, dass das F-Maß eine gewichtete Summe aus Precision und Recall ist, deren Gewichte von der Verknüpfungsmethode abhängen. Das System legt also die Abwägung fest und nicht die Bank. Die Leitlinie der britischen Regierung zur Verknüpfungsqualität rät davon ab, die Qualität von Verknüpfungen mit dem F-Maß zu vergleichen, weil der Wert von der Trefferquote des jeweiligen Klassifikators abhängt.
Auch der Testmix verschiebt den Wert. In einem Preprint von 2026 zum Benchmark OpenSanctions Pairs erreicht ein Prädiktor, der jedes Paar als Treffer meldet, einen F1-Wert von 0,870, weil 76,9 % der gelabelten Paare Treffer sind. Berichten Sie Precision und Recall getrennt, auf jeder Ebene.
Neue Beiträge zu Entity Resolution, Identitätsdaten und KI. Kein Spam, Abmeldung jederzeit möglich.
Warum verbirgt eine hohe paarweise Precision verunreinigte Kundenprofile im Bankmaßstab?
Im Bankmaßstab wird die Lücke zwischen Paaren und Profilen größer, weil die Zahl der Paare mit dem Quadrat der Clustergröße wächst und wenige große Cluster den Wert bestimmen. Barnes in seinem Überblick für die Praxis hält fest, dass die Verwechslung zweier Einzeldatensätze die paarweisen Maße kaum bewegt, während das Verbinden oder Trennen zweier großer Cluster sie stark verschiebt.
Wo fast jeder Kunde einen oder zwei Datensätze hat, sind Paar und Profil beinahe dasselbe, und paarweise Werte richten wenig Schaden an. Große Unternehmensgruppen ändern das. Nehmen wir, auf illustrativen Annahmen von uns, 100.000 Kunden mit je zwei Datensätzen und 100 Unternehmensgruppen mit je 200 Datensätzen. Die Zahl der echten Paare beträgt 100.000 plus 100 mal 19.900, also 2.090.000. Nun seien 1.000 Paare von Kunden mit zwei Datensätzen jeweils zu einem Profil mit vier Datensätzen verschmolzen, was pro Verschmelzung 4 falsche Paare ergibt, insgesamt 4.000.
Die paarweise Precision beträgt 2.090.000 geteilt durch 2.094.000, also 99,81 %, bei einem Recall von 100 %. Dennoch teilen 2.000 von 100.100 Kunden, also 2,0 %, ihr Profil jetzt mit einer fremden Person. Der Spitzenwert beschreibt die Unternehmensgruppen, nicht den typischen Kunden.
Eine einzige falsche Verknüpfung kann einen Menschen jahrelang verfolgen. Ab 1996 führte eine Auskunftei die uneinbringlichen Schulden einer anderen Frau in der Akte von Judy Thomas: dasselbe Geburtsjahr, ähnliche Vornamen und Sozialversicherungsnummern, die sich in einer Ziffer unterschieden. CBS News berichtete 2002, dass sie etwa sieben Jahre lang versuchte, den Fehler zu beheben, und dass ihr in einem Bundesverfahren 5,3 Millionen US-Dollar zugesprochen wurden. Kein Durchschnitt auf Paarebene hätte diese Verknüpfung sichtbar gemacht.
Warum endet der Recall bei der Kandidatenerzeugung?
Die paarweise Precision verbirgt falsche Zusammenführungen, und der Recall hat einen eigenen blinden Fleck: die Paare, die der Matcher nie verglichen hat. Ein Matcher kann kein Paar bewerten, das er nie vergleicht. Die Kandidatenerzeugung, oft Blocking genannt, entscheidet, welche Paare den Matcher erreichen, und setzt damit eine Obergrenze für den Recall. Papadakis und Kollegen definieren die Pair Completeness als den Anteil der echten Duplikatpaare, der es in die Kandidatenmenge schafft.
In den zehn Datensätzen gruppiert ein Postleitzahlen-Schlüssel die Datensätze 1 bis 4 mit Datensatz 10, doch Datensatz 5 trägt die neue Postleitzahl und trifft sein eigenes Profil nie. Acht von 12 echten Paaren erreichen den Matcher, der Kandidaten-Recall beträgt also 0,67, und der Recall von System A mit 0,67 ist diese Obergrenze. Keine Schwellenanpassung hebt ihn an, und ein Anbieter, der nur den Recall bei seinem Schwellenwert nennt, kann Ihnen die Ursache nicht zeigen.
Wie testet eine Bank auf übersehene Verknüpfungen?
Wer die Verknüpfungen eines Systems prüft, findet falsche Verknüpfungen viel besser als übersehene. Die Leitlinie der britischen Regierung sagt, die manuelle Prüfung sei für die Schätzung der Precision nützlicher als für die des Recall, und verweist für übersehene auf positive Kontrollen, also bekannte Treffer, die in die Daten eingebracht werden. Versehen Sie den Holdout mit bekannten Treffern, die sich in Postleitzahl, Nachname, Schreibweise und Schrift unterscheiden, und fragen Sie jeden Anbieter nach dem Kandidaten-Recall, dem Recall beim Betriebsschwellenwert und dem Recall nach menschlicher Prüfung.
Warum sind die Genauigkeitswerte zweier Anbieter selten vergleichbar?
Die Werte zweier Anbieter sind nur vergleichbar, wenn jede der genannten Entscheidungen übereinstimmt (Zähleinheit, Anteil leichter Treffer, Labels, Schwellenwert, Stichprobe und Kandidatenschritt), und Auswertungen nennen sie selten. Binette und Kolleginnen und Kollegen berichten, dass die paarweise Precision auf Benchmark-Datensätzen tendenziell zu optimistisch ausfällt und die Rangfolge zweier Algorithmen umkehren kann, sobald sie auf der gesamten Grundgesamtheit laufen.
| Vom Anbieter anzugeben | Warum sich die Zahl ohne die Angabe verschiebt |
|---|---|
| Die Zähleinheit: Paar, Cluster oder Datensatz | Eine falsche Verknüpfung kostet im Zehn-Datensätze-Beispiel fünf Paare, aber nur ein Profil. |
| Der Anteil leichter Treffer im Testdatensatz | Ein Trivial-Prädiktor erreicht F1 = 0,870, wenn 76,9 % der Paare Treffer sind. |
| Wer die Labels vergeben hat und wie ungeklärte Fälle gewertet wurden | Werden ungeklärte Paare gestrichen, verschwinden die schweren Fälle; unser Ground-Truth-Leitfaden behandelt die Richtlinie. |
| Der Betriebsschwellenwert und das Prüfband | Precision und Recall tauschen sich bei jedem Schwellenwert gegeneinander aus. |
| Wie die Stichprobe gezogen wurde, mit Intervall | Eine Stichprobe nur aus verknüpften Paaren schätzt die Precision und sagt nichts über den Recall. |
Die Bank kann dieses Lesen auch nicht dem Anbieter überlassen. Die PRA-Aufsichtserklärung SS1/23 erfasst intern wie extern entwickelte Modelle, Anbietermodelle eingeschlossen, daher ersetzt die Genauigkeitsaussage eines Anbieters nicht die eigene Validierung der Bank mit ihren eigenen Labels. Die Bank führt die Messung selbst durch.
Wie sollte eine Bank die Messung Schritt für Schritt durchführen?
Die Bank behält Holdout, Labels und Rechnung, so kontrolliert sie die Kennzahlen, gleich welcher Anbieter gewinnt.
- Holdout einfrieren und die Zähleinheit benennen. Legen Sie Datensätze, Label-Richtlinie und Einheiten fest, bevor ein Anbieter ein Ergebnis sieht.
- Jede Ausgabe in Cluster umwandeln. Verlangen Sie von jedem Anbieter eine Datei mit der Zuordnung von Datensatz zu Cluster und berechnen Sie jede Kennzahl aus dieser Datei.
- Kandidaten-Recall berichten. Zählen Sie die echten Paare, die den Matcher erreicht haben, bevor ein Schwellenwert greift.
- Profile zählen. Geben Sie die Rate falscher Zusammenführungen und übersehener Verknüpfungen mit Zähler, Nenner und Quellenschnitt an.
- Die Unsicherheit angeben. Ergänzen Sie jede Rate um ein Intervall, bemessen wie im nächsten Abschnitt.
Diese Schritte brauchen drei Dinge von jedem Anbieter: eine Cluster-Datei je Lauf, eine Begründung für jede Verknüpfung und vorab festgelegte Ziele. Unsere bezahlten PoCs laufen auf einem Beispielauszug der Bankdaten, mit vorab vereinbarten Precision- und Recall-Zielen, mindestens zwei Verfeinerungszyklen und einer exportierbaren Regelkonfiguration, die die Bank behält. Wir veröffentlichen keinen einzelnen Genauigkeitswert, weil das Ergebnis von den Labels, Quellen und Schnitten der Bank abhängt.
Wir speichern jeden Match als Graphkante, die die erzeugende Regel festhält, sodass sich ein in Schritt 4 gefundenes verunreinigtes Profil auf eine Verknüpfung und eine Regel zurückführen lässt. Unsere Konsistenzregeln verhindern, dass ein widersprüchliches Geburtsdatum oder eine widersprüchliche Steuer-ID eine Entität bildet, wie stark die übrigen Hinweise auch sind, und zielen damit direkt auf die falsche Zusammenführung. Unsere Regelsimulation zeigt vorab, wie sich ausgewählte Paare verhalten, bevor Sie live schalten. Unsere Leitfäden zu den sieben PoC-Inputs und zur Abstimmung der Matching-Regeln beschreiben den Ablauf.
Für eine einzelne Tabelle mit wenigen tausend Datensätzen und stabilem eindeutigem Schlüssel sind wir die falsche Antwort, denn ein Join über diesen Schlüssel braucht keine Resolution-Engine. Liegen Kunden in mehreren Systemen ohne gemeinsamen Schlüssel, läuft unser Tilores Studio lokal mit bis zu 100.000 Datensätzen und bietet Ihnen dieselbe GraphQL-API, die wir in der Cloud betreiben. Sie können also Tilores Studio herunterladen und eine freigegebene Stichprobe auswerten, bevor ein PoC beginnt, oder eine Demo buchen, um die Ziele zu planen.
Wie groß muss die PoC-Stichprobe sein, und welches Ziel sollte die Bank setzen?
Das Ziel hat eine letzte Bedingung: Die Stichprobe muss es belegen können, und ein von Hand gelabelter Auszug ist dafür oft zu klein. Nach der Dreierregel legen null Fehler in n unabhängigen Fällen die obere 95-%-Grenze der Fehlerrate bei etwa 3 geteilt durch n (die exakte Grenze ist 1 minus 0,05 hoch 1/n).
Auf falsche Zusammenführungen angewandt: 300 geprüfte Cluster mit mehreren Datensätzen ohne ein einziges verunreinigtes Profil zeigen mit 95 % Konfidenz eine Rate unter 1 %. Für unter 0,1 % braucht es 3.000 Cluster, für unter 0,01 % sind es 30.000. Eine Bank, die 200 verunreinigte Profile bei 2.000.000 Kunden toleriert, verlangt 0,01 %, was ein PoC-Auszug nicht belegen kann. Setzen Sie ein Ziel, das die Stichprobe belegen kann, und überwachen Sie den engeren Wert im Betrieb, wie in unserem Leitfaden zur Überwachung nach dem Go-Live.
Das Screening gegen Sanktions- und PEP-Listen sowie Negativmeldungen (Adverse Media) braucht ein eigenes Ziel, und dort kann sich die Rangfolge zu Recht wieder zum System mit hohem Recall drehen, weil eine übersehene gelistete Person mehr kostet als ein zusätzlicher Alarm. Die Baseline RegressionV1 des OpenSanctions-Preprints hat bei einem Schwellenwert von 0,15 einen nahezu perfekten Recall und viele Fehlalarme, was die Autoren mit der Präferenz verbinden, jeden möglichen Treffer auf Kosten der Analystenprüfung zu finden. Entity Resolution ersetzt das Screening nicht; sie übergibt dem Ablauf eine aufgelöste Identität samt Aliasnamen. Setzen Sie den Recall für diesen Schnitt hoch und halten Sie die Obergrenze für falsche Zusammenführungen bei der Kundenanlage niedrig. OpenSanctions veröffentlicht PEP-Datensätze für Testdaten, und die kommerzielle Nutzung erfordert eine Datenlizenz.
Welcher Satz gehört ins Leistungsverzeichnis?
Auf dem verdeckten Holdout der Bank, gelabelt nach der schriftlichen Richtlinie der Bank, erreicht die Konfiguration eine Rate falscher Zusammenführungen von höchstens [X] % der vorhergesagten Cluster mit mehreren Datensätzen, eine Rate übersehener Verknüpfungen von höchstens [Y] % der Kunden mit mehreren Datensätzen und einen Kandidaten-Recall von mindestens [Z] %, jeweils je Quellenschnitt mit Zähler, Nenner und 95-%-Intervall. Paarweise Precision und Recall werden zusätzlich zu diesen Werten berichtet, niemals an ihrer Stelle.
Die Bank legt X, Y und Z aus ihrer eigenen Risikobereitschaft fest, Schnitt für Schnitt. Ein Anbieter, der sie liefert, hat sich seine Prüfung selbst gestellt.
Häufig gestellte Fragen
Was ist der Unterschied zwischen paarweiser und Cluster-Precision?
Die paarweise Precision ist der Anteil der vorhergesagten Datensatzpaare, die stimmen, die Cluster-Precision der Anteil der vorhergesagten Profile, die richtig sind. Eine falsche Verknüpfung in einem großen Profil kostet viele Paare, aber nur ein Profil, daher können beide Werte verschiedene Sieger nennen.
Welche einzelne Kennzahl gehört in einen PoC-Vertrag?
Keine einzelne Kennzahl genügt. Formulieren Sie das Ziel als Rate falscher Zusammenführungen und Rate übersehener Verknüpfungen je Quellenschnitt, ergänzen Sie den Kandidaten-Recall und berichten Sie paarweise Precision und Recall zusätzlich, jeweils mit Zähler, Nenner und Intervall.
Was ist der Kandidaten-Recall?
Der Kandidaten-Recall, in der Literatur Pair Completeness, ist der Anteil der echten Treffer-Paare, die nach dem Blocking den Matcher erreichen. Er begrenzt jeden späteren Recall-Wert, denn kein Schwellenwert findet ein Paar, das nie verglichen wurde.
Wie viele gelabelte Cluster braucht ein PoC?
Das hängt vom Ziel ab. Nach der Dreierregel zeigen 3.000 geprüfte Cluster mit mehreren Datensätzen ohne falsche Zusammenführung eine Rate unter 0,1 %, und für unter 0,01 % braucht es 30.000, wählen Sie also ein Ziel, das die Stichprobe belegen kann, und überwachen Sie den Rest im Betrieb.
Quellen
- Tilores: Die aufgelöste Datenschicht für Risiko, Customer 360 und KI, Tilores.
- Tilores Studio herunterladen, Tilores.
- Entity-Resolution-Anbieter mit echten Bankdaten vergleichen: Ein belastbarer Bake-off, Tilores.
- So bauen Sie 2026 einen Ground-Truth-Datensatz für Entity Resolution auf, Tilores.
- Entity Resolution Proof of Concept: 7 PoC-Inputs für Banken im Jahr 2026, Tilores.
- Wie eine Bank und ihr Entity-Resolution-Anbieter sich vor einem PoC auf Matching-Regeln einigen, Tilores.
- Ist eine falsche Kundenzusammenführung ein meldepflichtiger DSGVO-Vorfall, und was müssen Banken dokumentieren?, Tilores.
- Entity-Resolution-Genauigkeit nach dem Go-Live überwachen: 7 Kennzahlen für 2026, Tilores.
- A Theory for Record Linkage, Ivan P. Fellegi und Alan B. Sunter, Journal of the American Statistical Association, Vol. 64, No. 328 (1969).
- Evaluating Entity Resolution Results, David Menestrina, Steven Euijong Whang und Hector Garcia-Molina, Proceedings of the VLDB Endowment, Vol. 3 (2010).
- A Practioner’s Guide to Evaluating Entity Resolution Results, Matt Barnes, Carnegie Mellon University (2015).
- A note on using the F-measure for evaluating record linkage algorithms, David Hand und Peter Christen, Statistics and Computing (2018).
- Quality assessment in data linkage, James Doidge, Peter Christen und Katie Harron, GOV.UK, Office for National Statistics und Government Analysis Function.
- How to Evaluate Entity Resolution Systems: An Entity-Centric Framework with Application to Inventor Name Disambiguation, Olivier Binette und Kolleginnen und Kollegen, arXiv-Preprint 2404.05622 (2024).
- A Survey of Blocking and Filtering Techniques for Entity Resolution, George Papadakis, Dimitrios Skoutas, Emmanouil Thanos und Themis Palpanas, arXiv 1905.06167 (2020).
- OpenSanctions Pairs: A Large-Scale Dataset for Pairwise Entity Matching, Chandler Smith, Magnus Sesodia, Friedrich Lindenberg und Christian Schroeder de Witt, arXiv-Preprint 2603.11051, Version 2 (25. August 2026).
- Politically Exposed Persons Datasets, OpenSanctions.
- Mistaken Identity In Credit Report, Rome Neal, CBS News (31. Juli 2002).
- SS1/23: Model Risk Management Principles for Banks, Bank of England Prudential Regulation Authority.
- Video: One Woman Spent Seven Years Fighting Another Person’s Debt on Her Credit Report, Schmitdy Gadget, YouTube.
Sehen Sie, was aufgelöste Entitätsdaten für Ihr Unternehmen — und Ihre KI — leisten.